

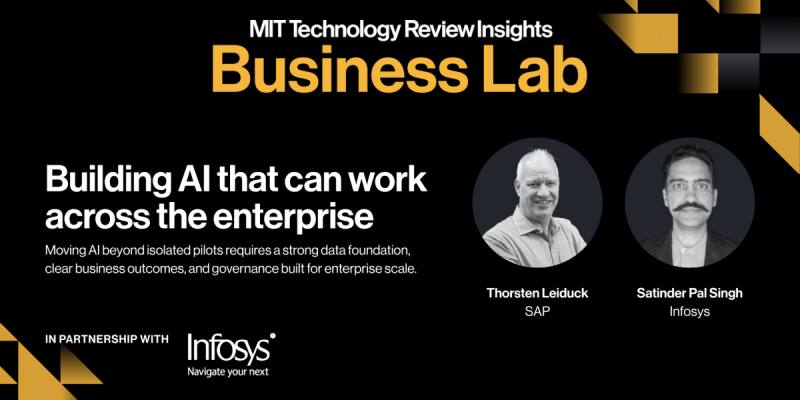
گزارش BCG نشان میدهد ۷۴٪ سازمانها در مرحلهٔ پایلوت هوش مصنوعی متوقف ماندهاند و هیچ برنامهای برای مقیاسدهی ندارند. در نظرسنجی Anthropic هم ۴۲٪ پاسخدهندگان گفتهاند دسترسی به داده و کیفیت آن، مانع اصلی گسترش قابلیتهای AI در سطح سازمان است. این اعداد در برنامهٔ Business Lab نشریهٔ MIT Technology Review (منتشرشده در ۱۶ نوامبر ۲۰۲۶، با همکاری Infosys) مطرح شد.
Thorsten Leiduck، معاون ارشد و سرپرست جهانی SAP Business AI Platform Ecosystem، در این گفتوگو گفت که ریشهٔ گیرکردن در پایلوت، شروع پروژهها بهصورت POCهای مجزا روی فناوریهای مختلف و روی زیرساخت دادهای پراکنده و ناهمگون است. او SAP Autonomous Enterprise Framework را چارچوبی معرفی کرد که هدف آن کمک به سازمانها برای گذار از پایلوت به نتایج مقیاسپذیر است. به گفتهٔ او، AI بهعنوان یک پلتفرم سازمانی باید لایهٔ دادهی یکپارچه و غنیمعنا را با بافت فرآیندهای کاربردی متصل کند و قابلیتهای AI را در چارچوب حاکمیت بر کل چرخهٔ عمر سازمان تعبیه کند.
Leiduck دربارهٔ آستانهٔ دقت هم تمایز قائل شد: «برای برخی کاربردهای روزمره، ۸۰٪ شاید کافی باشد، اما در زنجیرهٔ تأمین یا بستن حسابهای مالی، آن سطح دقت نتیجهای بسیار فاجعهبار است.»
Satinder Pal Singh، معاون منطقهای SAP Business AI Platform و استراتژی AI در Infosys، سه معیار ارزیابی موارد مصرف ایجنتها را پیشنهاد کرد: تأثیر (impact)، امکانپذیری (feasibility)، و مقیاسپذیری (scalability). او گفت: «پایلوتی که مقیاسپذیر نیست، صرفاً یک آزمایش است.» Singh همچنین تأکید کرد که نبود حاکمیت داده، پذیرش AI را سریعتر نمیکند؛ بلکه «بدهی ریسک» ایجاد میکند که در نهایت به توقف و ممیزی اجباری منجر میشود.
هر دو مدیر آیندهای را ترسیم کردند که در آن سیستمهای ایجنتی کار را بین اپلیکیشنها هماهنگ میکنند، گرافهای دانش سازمانی و دادههای حاکمیتشده به داراییهای کلیدی تبدیل میشوند، و AI از ابزار بهرهوری به «شریک تصمیمگیری» ارتقا پیدا میکند.
این خبر برای کسی که همین حالا ایجنت میسازد یعنی چه#
عدد ۷۴٪ مهمترین بخش این خبر است. یعنی اکثر پروژههای هوش مصنوعی سازمانی نه بهخاطر ضعف مدل، بلکه بهخاطر نبود زیرساخت دادهای منسجم و چارچوب حاکمیت، در مرحلهٔ دمو متوقف شدهاند. برای کسی که ایجنت یا اتوماسیون میسازد، پیام عملی این است: مهندسی داده و دسترسیهای حاکمیتشده، پیشنیاز مقیاسپذیریاند، نه مرحلهٔ بعدی. تمایز Leiduck بین «۸۰٪ کافی است» و «۸۰٪ فاجعهبار است» هم یک خط راهنمای مفید است: قبل از انتخاب کاربرد، باید پرسید اگر ایجنت در ۲۰٪ موارد اشتباه کند، هزینهٔ آن اشتباه چقدر است. اگر پاسخ «بالای آستانهٔ تحمل» باشد، آن کاربرد هنوز برای اتوماسیون کامل آماده نیست.
منبع: MIT Technology Review



دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.