


ایجنت هوش مصنوعی (AI Agent) سیستمی است که با دریافت هدف، انتخاب ابزار و ارزیابی مداوم خروجی، مسیر خود را اصلاح میکند. تفاوت کلیدی آن با رباتهای ساده در همین حلقهی بازخورد است؛ بدون این چرخهی تصمیمگیری، شما صرفاً یک خط لولهی ثابت ساختهاید.
تفاوت ایجنت هوش مصنوعی با چتبات و workflow ساده#
ایجنت هوش مصنوعی برخلاف چتباتهای خطی، خروجی خود را با معیارهای مشخص مقایسه کرده و در صورت نیاز ابزار یا پرامپت را اصلاح میکند. تمایز عملیاتی میان این دو، وجود حلقهی خودتصیحیحی (Self-correction loop) است که به سیستم اجازه میدهد اشتباهات را در همان لحظه شناسایی و رفع کند.
حلقهی خودتصیحیحی چه چیزی را تغییر میدهد؟#
در یک workflow ساده، خروجی مدل زبانی مستقیماً به مرحله بعد میرود. اگر خروجی غلط باشد، خطا در کل زنجیره پیشروی میکند. ایجنت اما پس از تولید خروجی، آن را با معیارهای تعریفشده تطبیق میدهد. اگر معیار برآورده نشود، اقدام بعدی تغییر میکند: ابزار دیگری صدا زده میشود، پرامپت اصلاح میگردد یا از مسیر جایگزین (Fallback) استفاده میشود.
این رفتار یعنی ایجنت در هر حلقه از خود میپرسد «آیا کار تمام شده؟». چتبات هرگز این سوال را از خود نمیپرسد.
الگوهای ReAct و Chain-of-Thought#
الگوی ReAct (Reasoning + Acting) چارچوبی است که مدل را مجبور میکند ابتدا استدلال کند، سپس اقدام نماید و در نهایت نتیجه را پردازش کند. این الگو در بسیاری از فریمورکهای ایجنت بهصورت پیشفرض پیادهسازی شده است.
Chain-of-Thought (CoT) صرفاً تکنیکی برای پرامپتینگ است که به مدل میگوید «قدمبهقدم فکر کن». CoT برای استدلال داخلی مفید است، اما بدون ساختار ReAct، ایجنت ابزاری صدا نمیزند و خروجی را ارزیابی نمیکند. CoT یک روش تفکر است؛ ReAct یک معماری اجرایی.
معماری ایجنت هوش مصنوعی: حلقهی ادراک، استدلال و اقدام#
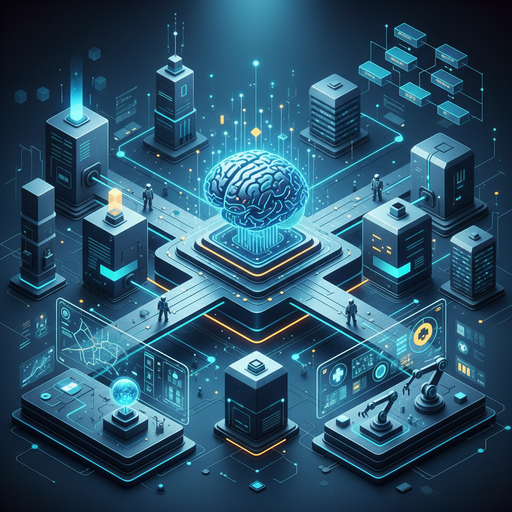
معماری ایجنت بر چهار رکن استوار است: مدل زبانی بزرگ (LLM) بهعنوان مغز متفکر، حافظه برای پیگیری وضعیت، ابزارها برای تعامل با محیط و برنامهریز برای شکستن وظایف. حذف هر کدام از این ارکان، کارایی ایجنت را بهشدت کاهش میدهد.
مدل زبانی و حافظه#
مدل زبانی بزرگ نقش پردازشگر مرکزی را بازی میکند؛ ورودی را میفهمد، استدلال میکند و ابزار مناسب را انتخاب مینماید. انتخاب مدل تأثیر مستقیمی بر کیفیت تصمیمگیری دارد؛ مدلهای کوچکتر در تشخیص زمان توقف و انتخاب ابزار ضعیفتر عمل میکنند.
حافظهی کوتاهمدت (Short-term Memory) همان پنجرهی زمینه (Context Window) است که تاریخچهی گفتوگو را نگه میدارد. حافظهی بلندمدت (Long-term Memory) معمولاً با پایگاه دادهی برداری (Vector Database) پیادهسازی میشود. بدون حافظهی بلندمدت، ایجنت در هر اجرا از صفر شروع میکند.
ابزارها و برنامهریز#
ابزارها (Tools) توابعی هستند که ایجنت میتواند فراخوانی کند: جستوجوی وب، خواندن فایل، اجرای کد یا ارسال ایمیل. فراخوانی توابع (Function Calling) مکانیزمی است که مدل از طریق آن نام ابزار و آرگومانها را بهصورت ساختاریافته تولید میکند.
برنامهریز (Planner) وظیفهی بزرگ را به زیروظایف کوچکتر شکسته و ترتیب اجرای آنها را مشخص میکند. بازگشتیابی افزایشی دانش (RAG) نیز بهعنوان یک ابزار خاص عمل کرده و اطلاعات مرتبط را از پایگاه دانش بازیابی مینماید.
مراحل عملی ساخت ایجنت هوش مصنوعی از صفر#
ساخت یک ایجنت کارآمد از تعریف دقیق وظیفه شروع میشود و به انتخاب مدل، اتصال ابزارهای محدود و پیادهسازی حلقهی بازخورد ختم میگردد. ترتیب این گامها حیاتی است؛ بسیاری از شکستها ناشی از بیترتیبی در طراحی اولیه است.
گامهای ساخت#
- تعریف وظیفه و معیارهای موفقیت: مشخص کنید ایجنت دقیقاً چه خروجیای تولید کند و موفقیت چگونه سنجیده شود. بدون معیار قابلاندازهگیری، ارزیابی ناممکن است.
- انتخاب مدل زبانی: بر اساس نیاز به استدلال، سرعت و هزینه تصمیم بگیرید. مدلهای قدرتمندتر برای ایجنتهای پیچیده ضروریاند.
- طراحی ابزارها: حداکثر 3 تا 5 ابزار دقیقاً مشخصشده تعریف کنید. هر ابزار باید یک تابع با ورودی و خروجی شفاف باشد.
- پیادهسازی حافظه: پنجرهی زمینه را مدیریت کنید و در صورت نیاز، حافظهی بلندمدت با پایگاه برداری اضافه نمایید.
- حلقهی ارزیابی و بازخورد: کدی بنویسید که خروجی را با معیارها مقایسه کند و در صورت شکست، اقدام بعدی را تعیین نماید.
- سناریوهای آزمون (Eval): مجموعهای از ورودیهای استاندارد و خروجیهای مورد انتظار تعریف کنید و رفتار ایجنت را بسنجید.
ساختار پروژه و شبهکد#
یک ساختار پوشهی ساده برای شروع:
project/
├── agent.py # حلقهی اصلی ایجنت
├── tools/
│ ├── search.py # ابزار جستوجو
│ └── calculator.py # ابزار محاسبه
├── prompts/
│ └── system.txt # پرامپت سیستمی
├── memory/
│ └── vector_store.py
└── eval/
└── test_cases.jsonنمونهی شبهکد حلقهی اصلی ایجنت:
def agent_loop(task):
    messages = [system_prompt, task]
    for step in range(max_steps):
        response = llm.generate(messages)
        if response.is_final_answer:
            return response.text
        tool_result = execute_tool(response.tool_call)
        messages.append(tool_result)
return fallback_response()مقایسهی فریمورکهای ایجنت هوش مصنوعی: LangChain، CrewAI و AutoGen#
انتخاب فریمورک باید بر اساس پیچیدگی پروژه انجام شود؛ LangChain برای اتصال سریع ابزارها، CrewAI برای نقشهای تیمی و AutoGen برای گفتوگوی چندایجنتی مناسبتر است. اشتباه رایج، استفاده از LangChain برای پروژههای ساده و ایجاد سربار (Overhead) بیهوده است.
مقایسهی عملیاتی فریمورکها#
| فریمورک | نقطهی قوت | محدودیت اصلی | مناسب برای |
|---|---|---|---|
| LangChain | تنوع ابزارها و زنجیرهسازی | انتزاع زیاد، سختیادگیری | پروژههای متوسط تا پیچیده |
| CrewAI | تعریف نقشهای تیمی و وظایف | کنترل کم بر حلقهی داخلی | ایجنتهای چندنقشی |
| AutoGen | گفتوگوی چندایجنتی انعطافپذیر | مدیریت هزینه و تأخیر | پروژههای تحقیقاتی و تولیدی |
| Semantic Kernel | یکپارچگی با اکوسیستم مایکروسافت | جامعهی کوچکتر | محیطهای سازمانی .NET |
| OpenAI Assistants | راهاندازی سریع بدون کد | وابستگی به API خاص | پروتوتایپ سریع |
معیارهای انتخاب فریمورک#
اگر پروژهتان یک ایجنت با 3 ابزار است، نوشتن حلقهی اصلی در پایتون خالص سادهتر و قابلکنترلتر از LangChain خواهد بود. فریمورک زمانی ارزش دارد که مقیاسپذیری، مدیریت حافظهی مشترک یا گفتوگوی بین ایجنتها را خودکار کند. در غیر این صورت، وابستگی به فریمورک بهجای کمک، مانع پیشرفت میشود.
چرا ایجنتهای چندمنظوره شکست میخورند؟#
ایجنتها به دلیل عدم تعریف واضح معیارهای موفقیت، نبود مسیرهای جایگزین و مشکل بار افزایی ابزارها (Tool Overload) در محیطهای تولیدی دچار اختلال میشوند. رایجترین دلیل شکست ایجنت در محیط تولید، ضعف مدل زبانی نیست؛ بلکه ضعف طراحی معماری است.
مشکل بار افزایی ابزارها#
وقتی تعداد ابزارهای یک ایجنت از حد معینی فراتر میرود، دقت انتخاب ابزار بهشدت کاهش مییابد. مدل زبانی باید بین ابزارهای مشابه تمایز قائل شود و هرچه گزینهها بیشتر باشند، احتمال انتخاب ابزار نادرست بالاتر میرود. در پروژههای واقعی، ایجنتهای متمرکز با تعداد محدود و دقیقاً مشخصشده ابزار عملکرد بسیار بهتری نسبت به ایجنتهای چندمنظوره با لیست طولانی ابزارها دارند.
راهحل عملی: ایجنتهای تخصصی بسازید و یک ایجنت مسیریاب (Router) بالای آنها قرار دهید. هر ایجنت تخصصی فقط ابزارهای مربوط به حوزهی خودش را میبیند.
هزینهی پنهان ایجنتهای چندایجنتی#
در معماری مولتیایجنت (Multi-Agent)، هر حلقهی گفتوگو بین ایجنتها یک فراخوانی کامل مدل زبانی است. تأخیر تجمعی (Cumulative Latency) بهصورت غیرخطی رشد میکند. اگر ایجنت A سه بار با ایجنت B صحبت کند و هر بار دو فراخوانی مدل نیاز باشد، شما 6 فراخوانی مدل دارید. هزینه و زمان اجرا مستقیماً با تعداد حلقههای فراخوانی افزایش مییابد.
نکتهی عملی: قبل از افزودن ایجنت جدید، بپرسید «آیا این کار با یک ایجنت و یک ابزار اضافه قابلحل نیست؟». در بسیاری از موارد، پاسخ مثبت است.
چه زمانی ایجنت هوش مصنوعی انتخاب اشتباه است؟#
در فرآیندهای با قوانین قطعی و ثابت، یا زمانی که ریسک خطای مدل زبانی بالاست، استفاده از کدنویسی سنتی یا workflowهای ساده بسیار بهینهتر و مقرونبهصرفهتر از ایجنت است.
نشانههای «ایجنت لازم نیست»#
- مسیر فرآیند از قبل مشخص است و نیاز به تصمیمگیری در زمان اجرا ندارد.
- خروجی باید دقیقاً فرمتبندیشده باشد و مدل زبانی نمیتواند این دقت را تضمین کند.
- هزینهی خطا بالاست و نظارت انسانی (Human-in-the-Loop) نمیتواند در هر حلقه حضور داشته باشد.
- وظیفه با چند شرط if-else و یک فراخوانی API قابلحل است.
جایگزینهای کمهزینه#
برای فرآیندهای غیرخودمختار، workflowهای ساده با شرطهای ثابت، کدنویسی سنتی با فراخوانی مدل زبانی در نقاط مشخص، و الگوهای Chain-of-Thought بدون حلقهی بازگشتی گزینههای بهتریاند. الگوی ایجنت شکستخورده معمولاً اینگونه است: وظیفهای با خروجی ساختاریافتهی قطعی، ایجنتی با دهها ابزار تعریف میشود، مدل در انتخاب ابزار اشتباه میکند، و نتیجه در محیط تولید قابلاتکا نیست.
راهحل: اگر نمیتوانید معیار موفقیت را بهصورت عددی تعریف کنید، ایجنت نسازید. ابتدا مسئله را با کد حل کنید و فقط جایی که کد نمیتواند تصمیم بگیرد، مدل زبانی اضافه نمایید.
نظارت انسانی بهعنوان لنگر ایمنی#
در محیطهای تولیدی، ایجنت بدون Human-in-the-Loop باید فقط در فرآیندهایی استفاده شود که هزینهی خطا قابلجبران است. برای عملیات مالی، ارسال ایمیل به مشتری یا تغییر دیتابیس، حلقهی تأیید انسانی یک الزام است، نه یک انتخاب. ایجنتی که این حلقه را ندارد، در بهترین حالت یک پروتوتایپ است.
جمعبندی و گام بعدی#
ایجنت هوش مصنوعی ابزاری قدرتمند است، اما نه برای هر مسئلهای. اگر حلقهی خودتصیحیحی ندارید، ایجنت نساختهاید. اگر ابزارهایتان بیش از حد مجاز است، احتمالاً مسیر را اشتباه رفتهاید. و اگر معیار موفقیت تعریف نکردهاید، ارزیابی هم ندارید.
اگر میخواهید ایجنت بسازید و از آن درآمد داشته باشید، دورهی «ساخت Ai Agent با N8N» در کامیونیتی اسکول دقیقاً همین مسیر را گامبهگام پوشش میدهد — از تعریف ابزار تا اتصال به درگاه پرداخت. اگر هم بدون کدنویسی میخواهید ایدهتان را به محصول تبدیل کنید، دورهی «آموزش جامع Claude و ابزارهای مشابه» را ببینید.
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.