


نسخهی دموی یک ایجنت هوش مصنوعی در جلسهی ارائه میدرخشد و دو هفته بعد از deploy، زیر بار ترافیک واقعی میشکند. علت، ضعف مدل نیست؛ تصمیمات معماریاند که پیش از اولین خط کد گرفته میشوند: الگوی برنامهریزی، طراحی fallback، و مرز بین وظیفهی ایجنت و وظیفهی Workflow. این شکاف، همان جایی است که اکثر تیمهای AI در آن هزینهی بازسازی میدهند.
ایجنت هوش مصنوعی چیست و چه فرقی با چتبات دارد؟#
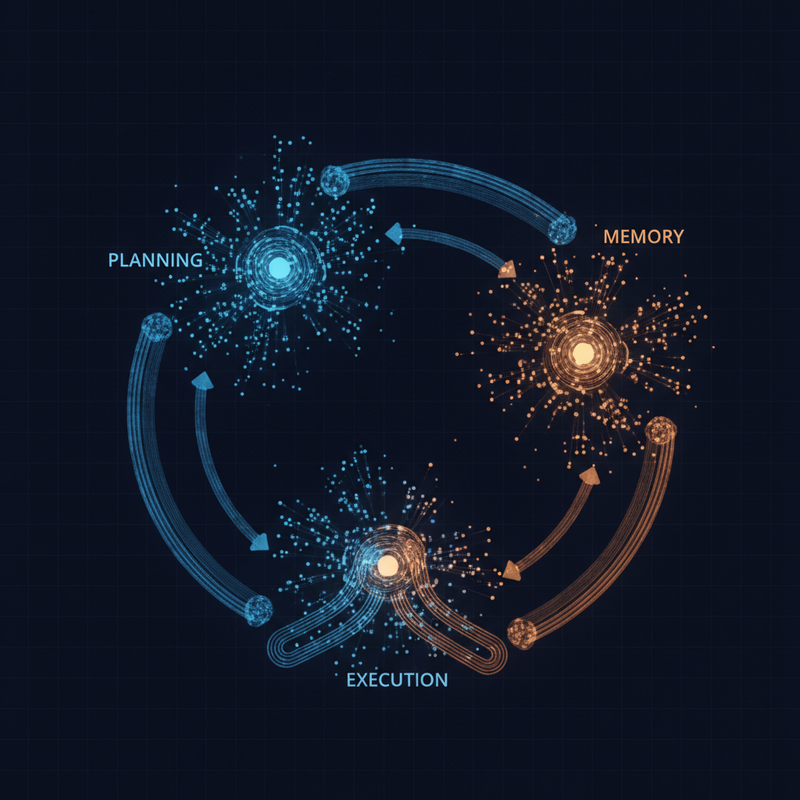
ایجنت هوش مصنوعی (AI Agent) یک مدل زبانی بزرگ (LLM) با سه لایهی اضافه است: حافظه (Memory)، دسترسی به ابزار (Tool Use) و حلقهی برنامهریزی (Planning Loop). چتبات یک ورودی میگیرد و یک خروجی میدهد؛ ایجنت چند گام تصمیمگیری پویا را بدون ورودی مجدد کاربر اجرا میکند.
Agentic Workflow زنجیرهای از تصمیمات مستقل است، نه یک prompt طولانی با چند instruction. ایجنتی که یک ticket پشتیبانی میخواند، در CRM جستجو میکند، پاسخ را مینویسد و اگر مطمئن نبود به انسان ارجاع میدهد، چهار تصمیم جدا گرفته است — نه یک تصمیم با چهار گام.
نکتهای که در بحثهای فنی کمتر گفته میشود: تفاوت ایجنت و چتبات در تعداد توکن نیست. یک چتبات با 10,000 توکن context هنوز یک ورودی-خروجی است. ایجنت از لحظهای شروع میشود که مدل خودش انتخاب میکند کدام ابزار را صدا بزند و آیا نتیجه کافی است یا نه.
برای هدایت مدلها با promptهای ساختاریافته، مقالهی پرامپتنویسی پیشرفته در اسکول الگوهای عملیتری ارائه میدهد.
معماری ایجنت: مؤلفهها و الگوهای ReAct، Plan-and-Execute و Reflexion#
معماری ایجنت چهار لایه دارد: مدل زبانی، حافظه، ابزار و برنامهریزی. الگوهای ReAct، Plan-and-Execute و Reflexion روشهای مدیریت لایهی برنامهریزیاند؛ هرکدام برای کلاسی از وظایف ساخته شده و انتخاب غلط، هزینهی اجرا را بیدلیل بالا میبرد.
لایهی حافظه — کوتاهمدت و بلندمدت#
حافظهی کوتاهمدت همان context window است: اطلاعاتی که در یک جلسه در دسترس مدل قرار دارد. حافظهی بلندمدت (Long-term Memory) از طریق vector store یا relational database پیادهسازی میشود و context را بین مکالمات حفظ میکند.
ایجنتهای ساده فقط context window دارند. ایجنتهای پیچیدهتر یک لایهی retrieval اضافه میکنند که اطلاعات مرتبط را از پایگاه داده بازیابی و به prompt تزریق میکند. در پروژههای اعضای کامیونیتی، الگوی تکرارشونده این است: تیمها ابتدا بدون حافظهی بلندمدت شروع میکنند و وقتی ایجنت در مکالمهی سوم «فراموش» میکند، مجبور به بازنویسی orchestration layer میشوند.
لایهی برنامهریزی — مقایسهی الگوها#
الگوی ReAct (Reasoning and Acting) که در مقالهی Yao et al. (2022) معرفی شد، استدلال و اقدام ابزارمحور را در یک حلقه ترکیب میکند — دقیقتر بگوییم، استدلال با اقدامِ قابلبازبینی، چون Observation همان بازبینی ضمنی است:
Thought → Action → Observation → Thought → Action → ... → Final Answer
Plan-and-Execute ابتدا کل مسیر را برنامهریزی میکند و سپس گامبهگام اجرا. Reflexion یک حلقهی خوداصلاحی (Self-correction Loop) اضافه میکند: ایجنت خروجی خود را بازبینی و در صورت خطا دوباره اجرا میکند.
قضاوت عملی: ReAct برای وظایف با تعداد گام متغیر ساخته شده. Plan-and-Execute فقط وقتی منطقی است که مسیر از پیش قابلپیشبینی باشد. Reflexion هزینهی API را تقریباً دو برابر میکند چون هر بازبینی یک call اضافه است — و در production، این «تقریباً دو برابر» یعنی فاکتور دوبرابری که هیچکس در budget اولیه پیشبینی نکرده.
چرا ایجنتها در production شکست میخورند؟#
ایجنتها در محیط عملیاتی بهدلیل سه شکست معماری از بین میروند: infinite loop در tool calling، non-deterministic routing که خروجی یکسان تضمین نمیکند، و timeout ابزارهای خارجی بدون fallback. هیچکدام ضعف خود LLM نیستند؛ ضعف طراحیاند.
چرا دمو میدرخشد و production میمیرد؟ چون دمو یک ورودی تمیز با یک مسیر مشخص میگیرد. production ورودیهای مبهم، پاسخهای ناقص ابزار و ترافیک همزمان دارد.
Infinite loop — ایجنت در چرخهی Action گیر میکند#
ایجنت یک tool call انجام میدهد، پاسخ مبهم دریافت میکند، تصمیم میگیرد همان tool را دوباره صدا بزند، و چرخه ادامه مییابد. علت رایج: tool خروجی ambiguous برمیگرداند و ایجنت از آن نتیجهی قطعی نمیگیرد.
راهحل: حداکثر تعداد iterations را در کد orchestration محدود کنید. اگر ایجنت به سقف رسید، بهجای ادامه، به انسان ارجاع دهد. سقف را از قبل تعریف کنید — نه در runtime.
Non-deterministic routing — تست خودکار غیرممکن میشود#
با یک prompt یکسان، ایجنت ممکن است در یک اجرا tool A را صدا بزند و در اجرای دیگر tool B. Temperature بالای مدل، prompt مبهم و نبود schema strict در tool definitions، هر سه این مشکل را تشدید میکنند. نتیجه: تست خودکار عملاً غیرممکن است و تیم در تاریکی deploy میکند.
راهحل: temperature را نزدیک صفر ببرید، schema ابزارها را دقیق تعریف کنید، و برای وظایف بحرانی از structured output استفاده کنید. اگر این سه کار را نکنید، هر «اصلاح» شما در production فقط جابهجایی باگ است.
Tool timeout و نبود fallback#
ابزار خارجی پاسخ نمیدهد و ایجنت معلق میماند. الگوی تکرارشونده از پروژههای اعضای کامیونیتی: decomposition به ایجنتهای کوچکتر با وظیفهی مشخص، بارها موفقتر از mega-agent بوده است.
Human-in-the-loop در محیط عملیاتی ضروری است، نه یک بهانه. تقریباً همهی ایجنتهای موفق در نقطهی تصمیم بحرانی به انسان ارجاع میدهند. ادعای استقلال کامل بدون نظارت انسانی یک marketing gimmick است، نه واقعیت فنی.
کدام فریمورک برای چه پروژهای مناسب است؟#
LangChain برای prototyping و demo مناسب است، AutoGen برای multi-agent system، CrewAI برای workflow با نقشهای مشخص، و کد سفارشی برای پروژههایی که نیاز به determinism و latency control دارند. انتخاب اشتباه فریمورک، هزینهی بازسازی در production را چند برابر میکند.
| فریمورک | مناسب برای | نقطهضعف | اکوسیستم |
|---|---|---|---|
| LangChain | Prototyping و demo سریع | Abstractionهای سنگین در production | Python، JavaScript |
| AutoGen (Microsoft) | Multi-agent orchestration | Learning curve بالاتر | Python |
| CrewAI | Workflow با نقشهای مشخص | انعطافپذیری کمتر در routing پیچیده | Python |
| OpenAI Assistants API | راهحل بومی با حافظه و tool | Lock-in به اکوسیستم OpenAI | Python، REST |
| کد سفارشی | Production با نیاز به determinism | توسعهی اولیه کندتر | هر زبانی |
Decision tree عملی#
اگر نیاز به prototyping سریع دارید: LangChain. اگر چند ایجنت باید با هم تعامل کنند: AutoGen. اگر workflow با نقشهای ثابت دارید: CrewAI. اگر determinism و latency control حیاتی است: کد سفارشی.
یک نکته که کمتر کسی صریح میگوید: مهاجرت از LangChain به کد سفارشی شکست نیست، الگوی طبیعی است. بسیاری از تیمها در prototyping با LangChain شروع میکنند و وقتی abstraction layer در production به مانع تبدیل میشود، rewrite میکنند. اگر از اول میدانید که پروژهتان به determinism نیاز دارد، همین حالا کد سفارشی بنویسید و دو ماه بازسازی را حذف کنید.
Function Calling، حافظه و RAG: اتصال ایجنت به دنیای واقعی#
ایجنت با Function Calling به APIهای خارجی متصل میشود، با RAG (Retrieval-Augmented Generation) به دادههای سازمانی دسترسی پیدا میکند و با ترکیب حافظهی کوتاهمدت و بلندمدت، context را بین مکالمات حفظ میکند. بدون این سه لایه، ایجنت فقط یک chatbot پیشرفته است.
Function Calling — schema، routing و مدیریت خطا#
Function Calling به مدل اجازه میدهد بر اساس schema تعریفشده، نام ابزار و پارامترهایش را بهصورت structured output برگرداند. مدل تصمیم میگیرد کدام tool صدا زده شود و با چه ورودیهایی.
مدیریت خطای پاسخ ابزار حیاتی است: اگر API خطا داد، ایجنت باید بداند چه کند — retry کند، fallback بزند یا به انسان ارجاع دهد. این منطق در orchestration layer نوشته میشود، نه در prompt. تیمهایی که error handling را در prompt مینویسند، در اولین باگ production میمانند.
RAG — chunking، embedding و retrieval#
RAG سه مرحله دارد: chunking (تقسیم اسناد به قطعات)، embedding (تبدیل به بردار) و retrieval (بازیابی قطعات مرتبط با query). قطعات بازیابیشده به context window تزریق میشوند و مدل با آگاهی از دادههای سازمانی پاسخ میدهد.
موضع صریح: اگر ایجنت فقط با ابزارهای API کار میکند و نیاز به دسترسی به مستندات داخلی ندارد، RAG اضافه است. latency و هزینه را بیدلیل بالا میبرد و هیچ ارزشی اضافه نمیکند. بسیاری از پروژهها RAG را بهعنوان «بهترین عمل» اضافه میکنند بدون اینکه بپرسند آیا دادهی سازمانی اصلاً در مسیر تصمیمگیری ایجنت لازم است.
ساختار پوشهی یک پروژهی ایجنت:
project/
├── agent.py
├── tools/
│ ├── crm.py
│ ├── email.py
│ └── calculator.py
├── memory/
│ ├── short_term.py
│ └── long_term.py
├── prompts/
│ └── system.txt
└── config.yaml
چه زمانی ایجنت بسازیم و چه زمانی Workflow ساده کافی است؟#
اگر تعداد مسیرهای تصمیم کمتر از سه و ترتیب اقدامات از پیش مشخص است، یک Workflow ساده (chain از promptها) کافی و قابلاعتمادتر است. ایجنت فقط وقتی لازم است که مدل باید در زمان اجرا تصمیم بگیرد کدام ابزار را صدا بزند.
سه معیار تصمیمگیری: اول، تعداد paths — اگر deterministic است، Workflow؛ اگر dynamic است، ایجنت. دوم، level of non-determinism — آیا ورودیهای متفاوت مسیر متفاوت میسازند؟ سوم، نیاز به self-correction — آیا ایجنت باید خروجی خود را بازبینی کند؟ اگر پاسخ هر سه «نه» است، ایجنت ساختن یعنی اضافهکاری.
Anti-pattern رایج: «ایجنت = چتبات + ابزار». این تعریف برنامهریزی و چرخهی بازخورد را نادیده میگیرد. Anti-pattern دوم: «با Prompt Engineering میتوان هر ایجنتی را ساخت». بدون orchestration logic و tool routing، prompt بهتنهایی ایجنت نمیسازد.
مثال عملی: تبدیل فاکتور PDF به CSV — Workflow کافی است. پاسخ به ticket متغیر با مسیرهای نامشخص — ایجنت لازم است. برای الگوهای عملی Agentic Workflow، مقالهی مربوطه در اسکول نمونههای بیشتری دارد.
هزینه، ارزیابی و اشتباهات رایج در ساخت ایجنت#
هزینهی اصلی ایجنت نه ساخت اولیه، بلکه حلقهی tool calling و ارزیابی مداوم است. بدون متریک مشخص و LLM-as-judge، کیفیت خروجی قابلاندازهگیری نیست و تیم در تاریکی توسعه میدهد.
هزینهی واقعی — API calls و latency#
هر tool call اضافه یعنی هزینهی API و latency بیشتر. یک ایجنت با 5 tool call در هر اجرا، پنج برابر یک prompt ساده هزینه دارد. در مقیاس production، این تفاوت فاحش است. حلقهی Reflexion هر بازبینی را یک call اضافه میکند و در عمل، هزینهی هر task را تقریباً دو برابر میکند.
ارزیابی — LLM-as-judge و task success rate#
LLM-as-judge یعنی یک مدل دیگر خروجی ایجنت را ارزیابی میکند. این روش سریع است اما خود قابلخطاست. متریک تکمیلی: task success rate — چه درصدی از وظایف واقعاً درست انجام شدند. مقایسه با baseline بدون ایجنت ضروری است؛ اگر Workflow ساده همان نتیجه را میدهد، ایجنت اضافه است و فقط هزینهی API تولید میکند.
اشتباهات رایج#
- Mega-agent: یک ایجنت با ده ابزار و وظیفهی مبهم. غیرقابلدیباگ و غیرقابلتست.
- نبود fallback: اگر ابزار خطا داد، ایجنت معلق میماند.
- Test نکردن edge caseها: ورودیهای غیرمنتظره که در demo دیده نمیشوند.
- ساخت بدون تعریف موفقیت: اگر نمیدانید چه چیزی «درست» است، نمیتوانید ایجنت بسازید. این پرهزینهترین اشتباه است، چون هر iteration بیهدف یعنی پول سوخته.
پیشنیازهای فنی: Python، آشنایی با API، درک context window، و توانایی نوشتن structured output. بدون اینها، هر فریمورکی در production به مشکل میخورد.
نتیجهی عملی#
ایجنت هوش مصنوعی ابزار قدرتمندی است، اما قدرت آن از معماری میآید نه از مدل. اگر میخواهید ایجنتی بسازید که در production زنده بماند: decomposition به ایجنتهای کوچک، fallback برای هر tool، Human-in-the-loop در نقاط بحرانی، و تعریف دقیق موفقیت قبل از نوشتن اولین خط کد.
اگر با n8n میخواهید ایجنت و اتوماسیون بسازید و از آن درآمد داشته باشید، دورهی «ساخت Ai Agent با N8N» در کامیونیتی اسکول مسیر عملیاتی از prototyping تا deploy را پوشش میدهد. اگر هم بدون کدنویسی میخواهید ایدهتان را به محصول تبدیل کنید، دورهی «آموزش جامع Claude و ابزارهای مشابه» را ببینید.




دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.