


اکثر تیمهایی که به سراغ ایجنت هوش مصنوعی (AI Agent) میروند، در واقع به یک workflow ساده نیاز دارند و نمیدانند. هزینهی این تشخیص غلط: ماهها توسعه، latency غیرقابلپیشبینی و کدی که هیچکس نمیتواند debug کند. این متن معیار عملی تشخیص، معماری قابلاجرا، مقایسهی فریمورکها و اشتباهات پرهزینهی طراحی را پوشش میدهد.
ایجنت هوش مصنوعی چیست و چه فرقی با چتبات و RAG دارد؟#
ایجنت هوش مصنوعی یک حلقهی تصمیمگیری مستقل است: محیط را مشاهده میکند، ابزار انتخاب میکند، عمل میکند و نتیجه را دوباره ارزیابی میکند. چتبات این حلقه را ندارد — یک ورودی میگیرد و یک خروجی میدهد. RAG هم حلقهی تصمیم ندارد؛ صرفاً یک pipeline بازیابی-تولید است.
تعریف عملیاتی ایجنت سه شرط لازم دارد: حداقل یک decision loop، انتخاب ابزار بر اساس وضعیت فعلی، و بازخورد گرفتن از محیط پس از هر عمل. اگر حتی یکی از این سه شرط را نداشته باشید، ایجنت نساختهاید.
تفاوت با workflow ساده ظریفتر از آن است که معمولاً گفته میشود. workflow مراحل ثابت دارد: اگر شرط A برقرار بود، مرحلهی B را اجرا کن. ایجنت مسیر را در زمان اجرا انتخاب میکند و حتی ممکن است تعداد مراحلش بین اجراهای مختلف فرق کند. همین تفاوت، هزینهی debug را از «بررسی سه خط شرط» به «بازسازی غیرقطعی یک trajectory چندمرحلهای» تبدیل میکند.
Anthropic در پست «Building Effective Agents» (دسامبر ۲۰۲۴) موضع روشنی دارد: بسیاری از آنچه در صنعت «ایجنت» نامیده میشود، در واقع workflow از پیش تعریفشده است. این تمایز نه فلسفی، بلکه عملی است — چون workflow قابل debug و قابل پیشبینی است، ایجنت نه.
معماری ایجنت: planning، memory، tool use و حلقهی عمل#
معماری ایجنت از چهار جزء اصلی تشکیل شده: برنامهریزی (planning)، حافظه (memory)، فراخوانی ابزار (tool use) و حلقهی عمل (action loop). الگوی ReAct این چهار جزء را در یک چرخهی تکرارشونده ترکیب میکند و پایهی اکثر ایجنتهای عملیاتی امروز است.
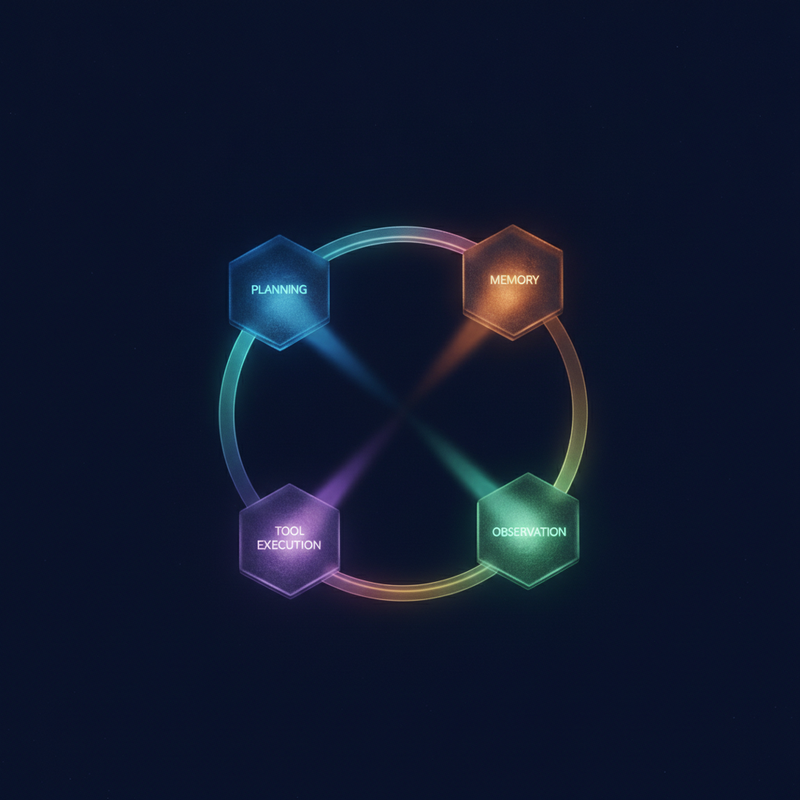
الگوی ReAct (Reasoning and Acting)#
ReAct الگویی است که در آن مدل زبانی در هر دور ابتدا استدلال کلامی مینویسد (thought)، سپس یک عمل انتخاب میکند (action)، و نتیجهی عمل را بهعنوان مشاهدهی بعدی دریافت میکند (observation). مقالهی Yao et al. 2022 نشان داد این الگو دقت را در benchmarkهایی مثل HotpotQA نسبت به baselineهای فقط-استدلالی بهبود میدهد. در عمل، هر دور ReAct یک فراخوانی API به مدل است.
حافظهی کوتاهمدت و بلندمدت (Short-term / Long-term Memory)#
context window حافظهی کوتاهمدت ایجنت است — هر چیزی که در آن جا نمیشود، عملاً فراموش میشود. external store (vector database، SQL، یا حتی یک فایل JSON ساده) نقش حافظهی بلندمدت را بازی میکند.
مهمترین چالش عملی مدیریت context window است: هر حلقهی اضافه token مصرفی را افزایش میدهد و وقتی context پر شود، مدل اطلاعات اولیه را از دست میدهد. این فقط یک مشکل فنی نیست — در پروژههای واقعی، اولین نشانهی context overflow، تکرار بیمعنای ایجنت است و تیمها معمولاً آن را با «مدل خراب شده» اشتباه میگیرند.
فراخوانی ابزار (Tool Use / Function Calling)#
OpenAI Function Calling و Anthropic Tool Use هر دو schema ساختاریافتهای برای تعریف پارامترهای ابزار ارائه میدهند. تفاوت اصلی در format درخواست است، نه در معماری. هر فراخوانی ابزار یک round-trip به مدل اضافه میکند و هزینهی token تقریباً خطی با تعداد دورها افزایش مییابد. این یعنی طراحی ابزارها نهفقط روی دقت، بلکه مستقیماً روی هزینه و latency اثر میگذارد.
طراحی ابزار: قانون ۵ تا ۸#
در پروژههای عملی کامیونیتها، الگوی تکرارشوندهای دیده شده: حداکثر ۵ تا ۸ tool با توضیحات دقیق و بدون overlap به یک ایجنت بدهید. وقتی تعداد ابزارها از این عدد فراتر میرود، مدل در انتخاب دچار confusion میشود. راهحل جایگزین router pattern است: ابتدا یک ایجنت سبک دستهی task را تشخیص میدهد، سپس فقط subset مرتبط از ابزارها فعال میشوند.
یک نمونهی ساختار tool description:
{
  "name": "search_database",
  "description": "Find customer records by email or phone. Returns list of matching accounts.",
  "parameters": {
    "query": {"type": "string", "description": "Email or phone number"},
    "limit": {"type": "integer", "description": "Max results to return"}
  }
}
آیا پروژهام به ایجنت نیاز دارد یا یک workflow کافی است؟#
آیا پروژهام به ایجنت نیاز دارد یا یک workflow کافی است؟ معیار عملی: اگر مسیر اجرا از پیش قابلتعریف است، workflow کافی است. ایجنت زمانی لازم میشود که تصمیم بعدی به خروجی مرحلهی قبلی وابسته باشد و نتوانید همهی شاخهها را از قبل بنویسید.
چکلیست تشخیص:
- آیا input مشخص و مراحل ثابت دارید؟ → workflow.
- آیا خروجی میانی تعیینکنندهی مرحلهی بعد است؟ → ایجنت.
- آیا محیط feedback واقعی میدهد (کد اجرا میشود، API پاسخ میدهد)؟ → ایجنت میتواند ارزشآفرین باشد.
- آیا task باز است (نوشتن مقاله، خلاقیت)؟ → prompt ساده بهتر از ایجنت عمل میکند.
مثال workflow مناسب: دریافت درخواست پشتیبانی → ثبت در CRM → ارسال ایمیل تأیید → نوتیفیکیشن به تیم. سه مرحله، ترتیب ثابت، بدون نیاز به تصمیمگیری.
مثال ایجنت مناسب: debug یک خطای runtime. مسیر بررسی کاملاً به پیام خطا، stack trace و نتیجهی اجرای قبلی وابسته است. نمیتوانید همهی شاخهها را از قبل بنویسید.
استثنای مهم که کمتر کسی صریح میگوید: ایجنت در taskهای باز (open-ended) مثل نوشتن مقاله عملکرد بدتری از prompt ساده دارد. دلیلش روشن است — observation مشخصی وجود ندارد، حلقهی تصمیم بیمعنی میشود و فقط token اضافه مصرف میکند. اگر کسی به شما گفت «ایجنت بنویس که مقاله تولید کند»، دارد پول شما را میسوزاند.
مقایسهی فریمورکهای ایجنتسازی: LangGraph در برابر CrewAI، AutoGen و Semantic Kernel#
مقایسهی فریمورکهای ایجنتسازی باید متناسب با پیچیدگی پروژه باشد؛ ایجنتهای ساده با مستقیم صدا زدن API و چند خط کد قابلساختاند و فریمورکها فقط برای پروژههای پیچیده ارزش دارند. انتخاب اشتباه فریمورک یعنی اضافه کردن abstraction layer بیمورد که debugging را سختتر میکند.
LangGraph: کنترلپذیری در سطح graph#
LangGraph state machine صریح، checkpoint و human-in-the-loop ارائه میدهد. مناسب پروژههایی است که نیاز به کنترل دقیق بر جریان اجرا دارند. برای یک ایجنت تکحلقه با ۲-۳ ابزار، LangGraph overkill است.
CrewAI و AutoGen: orchestration چندایجنتی#
CrewAI نقشمحور (role-based) است: هر ایجنت یک نقش دارد (researcher، writer، reviewer) و taskها بین آنها تقسیم میشوند. AutoGen مکالمهمحور (conversation-based) است: ایجنتها با هم گفتوگو میکنند و از طریق message passing هماهنگ میشوند. هر دو برای سناریوهایی مناسباند که واقعاً به تقسیم task بین چند ایجنت نیاز دارید.
Semantic Kernel و Haystack: گزینههای سازمانی#
Semantic Kernel برای اکوسیستم Microsoft طراحی شده و ایجنتسازی را بهعنوان یک capability ارائه میدهد. Haystack بیشتر RAG-centric است و ایجنتسازی در آن secondary است. اگر پروژهتان حول جستجو و بازیابی میچرخد، Haystack ممکن است کافی باشد.
| فریمورک | سطح انتزاع | زبان | مناسب برای |
|---|---|---|---|
| LangGraph | پایین (graph صریح) | Python، JS | ایجنتهای پیچیده با state machine و checkpoint |
| CrewAI | بالا (role-based) | Python | multi-agent با نقشهای مشخص |
| AutoGen | بالا (conversation-based) | Python | ایجنتهایی که با هم مکالمه میکنند |
| Semantic Kernel | متوسط | C#، Python | اکوسیستم Microsoft و enterprise |
| بدون فریمورک | بسیار پایین | هر زبانی | ایجنتهای ساده با ۱-۳ ابزار |
رایجترین اشتباهات طراحی ایجنت که در پروژههای واقعی هزینهساز میشوند#
رایجترین اشتباهات طراحی ایجنت سه مورد هستند: tool overload، multi-agent بیدلیل و نادیدهگرفتن context drift؛ هر سه در شروع پروژه بیضرر به نظر میرسند ولی در production هزینهی latency و debug را چند برابر میکنند. این سه الگو در پروژههای عملی کامیونیتها بارها تکرار شدهاند.
Tool overload: بیش از ۸ ابزار به یک ایجنت#
مدلهای فعلی در انتخاب از بین ابزارهای زیاد دچار confusion میشوند. وقتی ۱۵ tool به یک ایجنت میدهید، مدل اغلب ابزار اشتباه را انتخاب میکند یا پارامترها را غلط پر میکند. الگوی موفق: router pattern یا حداکثر ۵-۸ tool بدون overlap. اگر واقعاً به بیش از ۸ ابزار نیاز دارید، ایجنت را به چند ایجنت تخصصیتر تقسیم کنید.
Multi-agent بیدلیل: orchestration بدون نیاز#
در پروژههای واقعی کامیونیتهای LangGraph و CrewAI، بخش عمدهای از ایجنتهای multi-agent بهدلیل latency و non-determinism به تکایجنت با toolهای بیشتر بازنویسی میشوند. یک orchestrator با ۳ worker که هر بار ۲ دور مکالمه دارند حداقل ۶ فراخوانی API دارد؛ در حالی که یک ایجنت با همان ۳ ابزار در ۲-۳ فراخوانی همان کار را انجام میدهد.
multi-agent زمانی لازم است که task بهطور ذاتی قابل تقسیم به زیرمسئلههای مستقل با ابزارهای متفاوت باشد و orchestration بین آنها از پیش قابلتعریف نباشد. اگر میتوانید همهی مراحل را در یک لیست بنویسید، به multi-agent نیاز ندارید.
Context drift: فراموشی هدف در حلقههای عمیق#
ایجنتها در taskهای با depth بیش از ۵-۶ حلقه دچار context drift میشوند؛ مدل هدف اولیه را فراموش میکند و شروع به تکرار یا انحراف میکند. راهحل: external state tracking (نیتکردن وضعیت در یک متغیر مستقل از context) + periodic goal restatement (در هر حلقه، هدف اصلی را دوباره به prompt اضافه کنید).
ادعای خودمختاری کامل بدون guardrails#
ایجنتهای production-ready در عمل نیاز به human-in-the-loop، guardrails و checkpoint دارند. خودمختاری کامل یک ادعای بازاریابی است نه واقعیت مهندسی. حداقلهای لازم: max iteration count، input/output validation، و یک مکانیزم escalation وقتی ایجنت در حلقه گیر میکند.
چطور ایجنت را تست، ارزیابی و دیباگ کنم؟#
چطور ایجنت را تست، ارزیابی و دیباگ کنم؟ با تستهای deterministic شروع کنید: هر حلقه را با input ثابت اجرا کنید، output ابزار را بررسی کنید و سپس trajectory کل ایجنت را با expected path مقایسه کنید. non-determinism ایجنتها debugging را نسبت به کد سنتی سختتر میکند، اما نه غیرممکن.
سؤال اصلی اینجاست: آیا مشکل از ابزار است، از انتخاب ابزار است، یا از کل مسیر؟ هر سه سطح تست جداگانه دارند.
تست سطح ابزار: هر tool را جداگانه validate کنید#
قبل از تست ایجنت، مطمئن شوید هر ابزار بهدرستی کار میکند. شبهکد:
def test_search_database():
    mock_env = MockEnvironment({"customers": [...]})
    result = search_database.run(query="ali@example.com", limit=5)
    assert result["count"] == 1
    assert result["data"][0]["email"] == "ali@example.com"
اگر ابزار درست کار نکند، ایجنت هرگز درست رفتار نخواهد کرد — حتی اگر مدل بینقص باشد.
تست سطح حلقه: آیا ایجنت ابزار درست را انتخاب میکند؟#
با چند scenario مشخص، بررسی کنید آیا ایجنت در هر دور، tool مناسب را صدا میزند یا نه. metrics کلیدی: tool selection accuracy (آیا ابزار درست انتخاب شد؟) و loop termination rate (آیا ایجنت در تعداد حلقهی قابلقبول متوقف شد؟).
تست سطح trajectory: آیا کل مسیر منطقی است؟#
output نهایی + تعداد دورها + مجموع token مصرفی را با baseline مقایسه کنید. در multi-agent، هر message بین ایجنتها یک round-trip است و latency را مستقیماً افزایش میدهد. اگر trajectory یک task مشخص در ۱۰ دور حل میشود ولی ۳ دور کافی بود، مشکل در planning ایجنت است نه در ابزارها.
Guardrails عملی: max iteration count را همیشه ست کنید (مثلاً ۱۵ حلقه)، input/output schema validation اضافه کنید، و یک fallback path برای زمانی که ایجنت در حلقه گیر میکند تعریف کنید.
محدودیتها، هزینه و زمان واقعی ساخت ایجنت#
محدودیتهای ایجنت هوش مصنوعی سه دستهاند: وابستگی به feedback محیطی، هزینهی token که با هر حلقه افزایش خطی دارد، و زمان توسعهای که معمولاً چند برابر یک workflow ساده است. شناخت این محدودیتها قبل از شروع پروژه، جلوی هزینههای پنهان را میگیرد.
محدودیتهایی که کمتر گفته میشوند#
ایجنت بدون observation مفید بیفایده است. اگر محیط feedback نمیدهد (مثلاً task خلاقانه یا تحلیلی بدون معیار صحت)، ایجنت حلقهی تصمیم معناداری ندارد و فقط token اضافه مصرف میکند. non-determinism هم debugging را سخت میکند: یک ایجنت ممکن است با همان input، دو بار متفاوت رفتار کند. quality tool descriptions هم حیاتی است — یک description مبهم، ایجنت را به سمت ابزار اشتباه میکشاند.
هزینهی واقعی: token و latency#
هر فراخوانی ابزار یک round-trip به مدل اضافه میکند. یک ایجنت با ۵ حلقه، حداقل ۱۰ round-trip دارد (۵ فراخوانی مدل برای انتخاب ابزار + ۵ اجرای ابزار). اگر در هر حلقه بیش از یک ابزار صدا زده شود، این عدد افزایش مییابد. انتخاب مدل باید متناسب با task باشد؛ یک مدل متوسط با toolهای خوب طراحیشده از یک مدل بزرگ بدون ساختار مناسب بهتر عمل میکند.
زمان توسعه در عمل#
زمان واقعی ساخت ایجنت به پیچیدگی بستگی دارد:
- ایجنت ساده (۱-۲ ابزار، تکحلقه): چند ساعت. بدون فریمورک، مستقیم API.
- ایجنت production-ready (guardrails، logging، human-in-the-loop، test suite): چند روز تا چند هفته.
- ایجنت چندعاملی (multi-agent): بهمراتب بیشتر، چون debugging non-deterministic behavior بین چند ایجنت چالش جداگانهای است.
یک ساختار پوشهی پیشنهادی برای ایجنت production:
agent_project/
├── tools/
│   ├── search.py
│   ├── calculator.py
│   └── __init__.py
├── prompts/
│   ├── system.txt
│   └── goal_restatement.txt
├── tests/
│   ├── test_tools.py
│   ├── test_loop.py
│   └── test_trajectory.py
├── config.py
├── agent.py
└── main.py
این ساختار ساده، جدا کردن تست ابزار از تست حلقه از تست trajectory را ممکن میکند و debugging را نسبت به یک فایل monolithic بسیار قابلمدیریتتر میسازد.
نتیجهی عملی: قبل از شروع هر پروژهی ایجنت، تست «آیا workflow کافی است؟» را اجرا کنید. اگر پاسخ بله بود، ایجنت نسازید. اگر پاسخ نه بود، با کمترین تعداد ابزار و بدون فریمورک شروع کنید و فقط وقتی واقعاً به state management پیچیده نیاز پیدا کردید، LangGraph یا مشابهش را اضافه کنید. اگر میخواهید این فرآیند را در محیط عملی و با پروژههای واقعی تمرین کنید، دورهی «ساخت Ai Agent با N8N» در کامیونیتی اسکول دقیقاً همین مسیر را پوشش میدهد — از تشخیص نیاز تا production.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.