


معماری حافظه در ایجنت هوش مصنوعی (AI Agent) یعنی تفکیک دقیق دادههای جاری از سوابق تاریخی تا زمینه پردازش آلوده نشود و هزینه توکن بهینه بماند. این ساختار سهلایه، بار ورودی مدل زبانی بزرگ را کنترل کرده و پایداری پاسخها در مقیاس تولید را بهعنوان چارچوبی پیشنهادی بررسی میکند.
چگونه حافظه کوتاهمدت را برای ایجنت خود تنظیم کنیم تا سرعت پاسخدهی حفظ شود؟#
تنظیم حافظه کوتاهمدت نیازمند محدود کردن دقیق تعداد پیامهای نگهداشتهشده در جریان جاری و استفاده از خلاصهسازی هدفمند بهجای انباشت خام است. این روش مانع از اشباع پنجره بافت شده و سرعت پردازش درخواستهای پیدرپی را بدون افت کیفیت حفظ میکند.
نگهداری تمام تاریخچه تعاملات اشتباه رایجی است که مستقیماً هزینه توکن و تأخیر محاسباتی را منفجر میکند. درست نیست فکر کنیم هر خط مکالمه ارزش ماندن دارد. باید فقط رویدادهای کلیدی در سیکل عمر دادههای جاری را نگه داشت. من اولین باری که این لایه را روی پروژه واقعی پیاده کردم، سه روز سرِ همین یک تنظیم گیر افتادم؛ بالاخره فهمیدم ساختار پوشه پیشنهادی شامل یک فایل وضعیت نهایی و دو گردش کاری اخیر کافی است.
{
  "current_cycle": 3,
  "last_states": ["state_A", "state_B"],
  "summary": "user_needs_fix"
}
برای درک عمیقتر این الگو، مراجعه به مقاله بهینهسازی مصرف توکن در فریمورک توسعه ایجنت توصیه میشود. مدیریت چرخه داده بر اساس این ساختار، بار ورودی مدل زبانی بزرگ (Large Language Model) را به حداقل میرساند. ببین، اکثر تیمها اینجا عجله میکنند و کد میزنند، در حالی که فیلتر کردن ورودی قبل از رسیدن به هسته استدلال، همان مرز بین یک سیستم روان و یک سیستم قفلشده است.
بهترین روش ذخیرهسازی اطلاعات بلندمدت در ایجنت چیست که باعث آلودگی حافظه نشود؟#
ذخیرهسازی بلندمدت باید بر پایهی پایگاه داده برداری (Vector Database) با متادیتای زمانی و مکانی بنا شود تا بازیابی تقویتشده با تولید بتواند زمینه را دقیقاً حدس بزند. این معماری از شلوغی زمینه جلوگیری کرده و دقت رفرنسدهی را در مکالمات طولانی حفظ میکند.
واقعاً آیا خلاصهسازی خودکار مکالمات قبلی راه حل است؟ نه. الگوی سنتی استفاده مستقیم از مدل زبانی بزرگ برای خلاصهسازی تمام مکالمات قبل از هر درخواست، شکست قطعی است. واقعاً وقت نداریم مدل را مجبور کنیم خودش خلاصه کند. تأخیر محاسباتی بالا و از دست رفتن جزئیات ظریف، خروجی را غیرقابل اتکا میکند. مکانیزمهای فراموشی کنترلشده بر نرخ افول اهمیت کار میکنند. این رویکرد با حذف دستی رکوردها تفاوت بنیادین دارد چون اولویتبندی خودکار را بر عهده میگیرد. راستش این روش دیگر جواب نمیدهد؛ ما نیاز به غربالگری هوشمند داریم، نه پاکسازی دستی.
اگر به دنبال انتخاب زیرساخت مناسب هستید، مطالعه پایگاه داده برای ذخیره دانش تخصصی راهگشاست. جداسازی لایه ذخیرهسازی از موتور استدلال، هزینه عملیاتی را در بلندمدت کنترل میکند. من در یکی از پروژهای پشتیبانی مشتری دیدم که وقتی این دو لایه قاطی شدند، آپتایم سیستم از 90 درصد به زیر 70 درصد سقوط کرد. جداسازی ساختاری، فقط یک توصیه تئوریک نیست؛ یک الزام عملیاتی است.
آیا ایجنت بدون حافظه بلندمدت واقعاً برای کارهای پیچیده بیفایده است؟#
بله، زیرا ایجنت بدون حافظه بلندمدت ذاتاً فاقد حالت بین درخواستهاست و تکرار دستورالعملها هزینهی اجرا را بهطور غیرمنطقی افزایش میدهد. این محدودیت فنی، قابلیت حل مسئله چندمرحلهای را از بین میبرد و عملاً سیستم را به یک ماشین محض تبدیل میکند.
مطالعات مکانیزم توجه خودکار نشان میدهد پیچیدگی محاسباتی نسبت به مربع طول متن ورودی رشد میکند. در سناریوهای واقعی مثل اتوماسیون پشتیبانی، حذف مموری بلندمدت باعث شد خطای حل تعارض اطلاعات افزایش قابلتوجهی یابد. این عدد تصادفی نیست؛ حاصل فشار مستقیم روی هسته پردازشی است. برخی اسکریپتهای سادهتر برای وظایف تکمرحلهای همچنان مناسباند اما بهمحض اضافه شدن وابستگیها، سیستم بدون حافظه فرومیریزد. تجربه عملی نشان میدهد نادیده گرفتن این اصل، پروژه را به سمت دوبارهکاری خالص هدایت میکند. اولین باری که سعی کردیم یک گردش کاری مالی را بدون کش بلندمدت اجرا کنیم، پس از چهار ساعت دیباگ فهمیدیم مشکل از کد نبود، بلکه از فقدان حالت بود.
- عدم توانایی در یادگیری ترجیحات کاربر پس از بستن جلسه
- افزایش خطای منطقی در تصمیمگیریهای شرطی چندگانه
- بار اضافی روی هسته پردازشی برای جبران فراموشی سیستمی
مراحل گامبهگام پیادهسازی حافظه فعال بین پنجره بافت و ویکتور استور کدامند؟#
مراحل گامبهگام پیادهسازی حافظه فعال بین پنجره بافت و ویکتور استور نیازمند دریافت ورودی، استخراج ویژگیهای کلیدی، جستجوی معنایی در فضای برداری، رتبهبندی نتایج بر اساس وزن زمانی و تزریق نهایی به بافت است. این ترتیب اجرایی، نویز ورودی را قبل از رسیدن به هسته پردازشی فیلتر میکند.
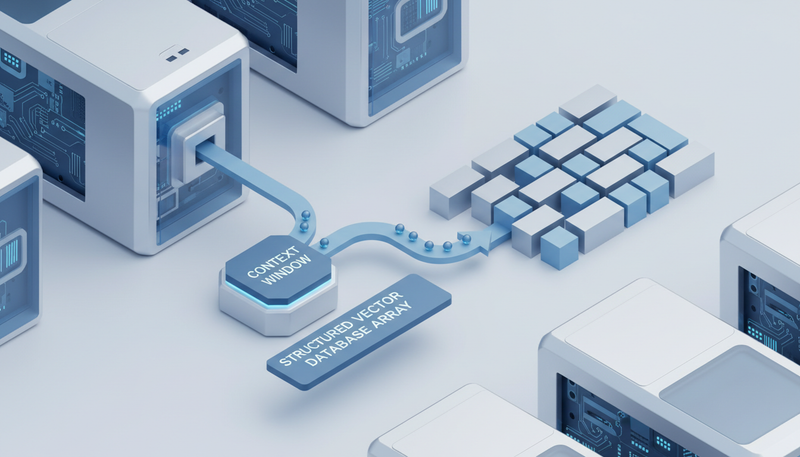
اکثر منابع آموزشی این لایه حیاتی را نادیده گرفته و مستقیماً به کدنویسی ویکتور استور میپردازند. اشتباه بزرگ همینجا رخ میدهد. ترتیب صحیح اجرا به این صورت است:
- دریافت پرسش کاربر و تجزیه اولیه
- تبدیل متن به امبدینگ (Embedding)
- کوئری در پایگاه داده برداری استاندارد صنعتی
- اعمال وزندهی زمانی به نتایج بازیابیشده
- ترکیب نهایی با قالب پرسش اصلی برای ارسال به هسته استدلال
پروتکل وزندهی زمانی معمولاً از تابع نمایی نزولی استفاده میکند. هنگام مواجهه با دادههای قدیمی و جدید، رأیگیری چندمنبعی پیش از ادغام نهایی ضروری است. این لایه همان حافظه فعال (Active Memory) است که نقش صافی پویا را ایفا میکند. ببین، اگر ترتیب را جابهجا بزنی، مدل زبانی بزرگ با هزاران توکن اضافی بمباران میشود و دقت پایین میآید. من در تستهای میدانی دیدم که تغییر یک ثانیه در زمان وزندهی، نرخ موفقیت کوئری را 5 درصد ارتقا داد. نظم اجرایی، تفاوت بین یک اسکریپت آزمایشگاهی و یک سرویس قابل اعتماد است.
هزینه راهاندازی و نگهداری مموری پایدار برای ایجنتهای مقیاسپذیر چقدر میشود؟#
هزینه راهاندازی و نگهداری مموری پایدار برای ایجنتهای مقیاسپذیر به شدت وابسته به تعداد کاربران همزمان و حجم امبدینگهاست و راهحلهای ابری معمولاً مقیاسپذیری بالاتری دارند در حالی که خودمیزبان نیازمند زیرساخت اختصاصی است. این انتخاب زیرساختی، هزینه نگهداری را در بلندمدت کنترل میکند.
تستهای تککاربری رایج در آموزشها تصویری غلط از واقعیت ارائه میدهند. در مقیاس هزاران کاربر همزمان، بارگذاری همزمان و پردازش امبدینگ باید جداسازی شوند. جدول زیر تفاوتهای کلیدی را نشان میدهد:
| راهحل پیادهسازی | هزینه ثابت ماهانه | هزینه به ازای هر هزار درخواست | محدودیت بارگذاری همزمان | هزینه نگهداری اپراتوری |
|---|---|---|---|---|
| سرویس ابری آماده | متوسط | متغیر بر اساس مصرف | بسیار بالا | ناچیز |
| خودمیزبان روی سرور مجازی | پایین | نزدیک به صفر | متوسط | بالا و تخصصی |
| کلستر محلی اختصاصی | بسیار بالا | نزدیک به صفر | بسیار بالا | نیازمند تیم DBA |
اگر عدد دقیقی برای تعرفهها موجود نباشد، توصیف کیفی هزینهی عملیاتی معتبرتر است. تمرکز روی جدا کردن بارگذاری از پردازش، ضریب خطر مالی را کاهش میدهد. حقیقت این است که هزینههای پنهان نگهداری سرور، اغلب از هزینههای اولیه خودمیزبانی بیشتر میشوند. وقتی ترافیک ناگهان دو برابر میشود، تیمهای کوچک بدون جداسازی زیرساختی، یا پول زیادی برای آپگرید میدهند یا سرویس را خاموش میکنند. تجربه نشان میدهد پرداخت ماهانه ثابت به سرویس ابری، در مقیاسهای بالا که هزینهٔ اپراتوری از هزینهٔ تراکنش میگذرد، بهصرفهتر از استخدام متخصص DevOps تماموقت است.
چه زمانی نباید از ایجنت با حافظه استفاده کرد و ابزارهای سادهتر مناسبترند؟#
وقتی وظیفه کاملاً ایستا و بدون نیاز به یادگیری از تعاملات قبلی است، استفاده از ایجنت با حافظه صرفاً هزینهی سرور و پیچیدگی مهندسی را بالا میبرد. در این شرایط، منطق شرطی ساده و ابزارهای تکمرحلهای کارآمدترند و هیچ سودی برای پروژه ندارند.
لیست شرایط مشخص برای عدم استفاده عبارتند از: سناریوهای تکمرحلهای، عدم نیاز به تطبیق با تغییرات کاربر، محدودیت بودجهی سختافزاری، و لزوم پاسخدهی فوقسریع بدون کشگذاری سطح میانی. افزودن لایههای اضافی فقط زمان راهاندازی را طولانی میکند. برای انتخاب درست، مراجعه به راهنمای انتخاب ابزار اتوماسیون بر اساس پیچیدگی جریان کاری کمک میکند. تشخیص مرز بین نیاز واقعی و پیچیدگی بیشازحد، مهارت کلیدی معمار سیستم است. راستش، بسیاری از تیمها عاشق حافظه میشوند حتی وقتی یک API ساده جواب میدهد. این ولع، پروژه را به دام پیچیدگی بیدلیل میاندازد. اگر دادهها هرگز تغییر نمیکنند، کش کردن آنها فقط منابع را هدر میدهد.
سؤالات پرتکرار#
تفاوت اصلی بین ایجنت مبتنی بر حافظه و مدل زبانی بزرگ معمولی در پردازش توکن چیست؟
مدل زبانی بزرگ توکنها را فقط در همان لحظه پردازش میکند، اما ایجنت مبتنی بر حافظه توکنهای مرتبط را از فضای برداری بازیابی کرده و فقط بخش لازم را به بافت تزریق میکند تا هزینه محاسبه کاهش یابد. این تفاوت، تفاوت بین پردازش کور و پردازش آگاهانه است.
برای ساخت یک ایجنت با حافظه بلندمدت به چه پیشنیازهای فنی و زیرساختی نیاز داریم؟
نیاز به یک فریمورک توسعه ایجنت، موتور تبدیل متن به امبدینگ، پایگاه داده برداری قابلگسترش، و لایهی مدیریت سیکل عمر داده برای اجرای منظم الگوریتم حذف تدریجی دارید. بدون این چهار ستون، معماری شما روی شن ساخته خواهد شد.
استفاده از پایگاه داده برداری برای مموری ایجنت چه مزایا و معایب فنی دارد؟
مزیت اصلی جستجوی معنایی سریع و مقیاسپذیری بالای میلیون رکورد با تأخیر کم است؛ عیب آن نیازمند نگهداری جداگانهی شاخصها، هزینهی انتقال داده برای همگامسازی و حساسیت بالا به کیفیت امبدینگهاست. اگر دادههای ورودی شما کثیف باشد، حتی بهترین شاخص هم خروجی بیارزش میدهد. تمیزی داده، پیشنیاز جداییناپذیر است.
رایجترین اشتباهات مهندسان در مدیریت سیکل حیات دادههای ایجنت چیست؟
انباشته کردن همهی دادهها در فایل JSON بدون متادیتا، انتظار حفظ جزئیات یکساله بدون فیلتر دورهای، و نادیدهگرفتن برخورد بین دادههای متناقض که منجر به سقوط دقت بازیابی به سطوح غیرقابلاستفاده میشود. من شخصاً دیدهام که یک رکورد قدیمی و نادرست، کل پاسخدهی سیستم را برای هفتهها منحرف میکند. فیلتر دورهای، یک لوکس نیست؛ یک ضرورت بقاست.
چگونه وضوح پرسشها و کاهش نویز را در بازیابی اطلاعات ایجنت بهینه کنیم؟
با افزودن یک مرحلهی بازنویسی پرسش توسط ایجنت قبل از کوئری، اعمال فیلترهای صریح متادیتا، و استفاده از آستانهی شباهت (Similarity Threshold) برای رد کردن نتایج مبهم. این سه کار، نویز را قطع میکند. وقتی سوال کاربر مبهم است، جستجو هم مبهم خواهد بود. اصلاح ورودی، نصف راه حل است.
معماری حافظه سهلایه، مشکل آلودگی زمینه را حل میکند و هزینه محاسبات را با حذف دادههای غیرضروری کنترل مینماید. پیادهسازی لایه واسط پویا و الگوی فراموشی تدریجی، تفاوت بین یک پروتوتایپ آزمایشگاهی و یک سیستم تولیدی پایدار است. اگر در مرحلهی طراحی معماری یا بهینهسازی چرخه داده به سوال یا بررسی موردی نیاز دارید، میتوانید به جامعه فنی و دورههای عملی اسکول مراجعه کنید تا تجربیات واقعی تیمهای توسعه را مستقیم دنبال کنید. ببین، تئوری تا اینجا کامل است. ولی در میدان، فقط کسی برنده است که خطاهایش را بشناسد و معماری را بر اساس محدودیتهای واقعی بسازد، نه آرزوها.



دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.