


اگر چند بار Claude Code را در پروژهی چندفایلی استفاده کردهاید، احتمالاً با خروجیهایی روبهرو شدهاید که فایلهای قبلی را «فراموش» میکند یا توابعی را صدا میزند که وجود ندارند. این باگ نیست — الگوی شکست شناختهشدهای به نام context collapse است که در این مقاله دقیقاً بررسی میشود: چهوقت رخ میدهد و معماریهای نجاتبخشش کداماند.
Claude Code چیست و چه فرقی با Cursor یا Copilot دارد؟#
Claude Code یک ایجنت (AI Agent) کدنویسی CLI است که در terminal اجرا میشود، فایلها را مستقیم ویرایش میکند، shell command اجرا میکند، و در یک turn چندین فایل را بدون دخالت کاربر تغییر میدهد. برخلاف Cursor و Copilot که پیشنهاد میدهند، Claude Code خودش تصمیم میگیرد و اجرا میکند.
معماری این سه ابزار کاملاً متفاوت است. Copilot یک autocomplete درونخطی است — پیشنهاد میدهد، شما قبول یا رد میکنید. Cursor یک extension در VS Code است که context فایلهای باز را میخواند و در پنل chat پاسخ میدهد. Claude Code اما یک agent مستقل است: shell command اجرا میکند، چندین فایل را در یک turn ویرایش میکند، و خودش تصمیم میگیرد چهکاری بکند.
Claude Code در فوریه 2025 بهصورت research preview منتشر شد و سپس به public beta رسید. پیشنیازهایش Node.js، Git و یک terminal است — همین یعنی برای non-developerها مناسب نیست و باید با خط فرمان راحت باشید.
اشتباه رایج: انتظار اینکه Claude Code جایگزین IDE باشد. در عمل مکمل workflow است. شما همچنان در IDE کد میزنید، debug میکنید، و review میکنید. Claude Code کارهای تکراری و چندفایلی را انجام میدهد.
چهزمانی Claude Code را انتخاب کنیم و چهزمانی سراغ Cursor یا Copilot برویم#
اگر task شما «این تابع را در این فایل اضافه کن» است، Copilot سریعتر است. اگر «این feature را در 5 فایل پیادهسازی کن و test بنویس» است، Claude Code بهینهتر است. اگر میخواهید در حین نوشتن کد، سوال فنی بپرسید و context فایلهای باز را داشته باشید، Cursor راحتتر است.
نقطهی تمایز واقعی Claude Code: ability to run shell commands و edit multiple files در یک turn. هیچکدام از این دو ابزار دیگر این کار را بهصورت native انجام نمیدهند.
پرامپتنویسی Claude: چرا XML tags کار میکنند و chain-of-thought گاهی ضربه میزند#
پرامپتنویسی Claude دو اصل دارد: XML tags بهعنوان مرزهای معنایی در attention map عمل میکنند و واقعاً خروجی را بهبود میدهند؛ اما chain-of-thought اجباری در system prompt نسخههای جدیدتر، الگوی reasoning داخلی مدل را مختل میکند و performance را کاهش میدهد.
مکانیزم attention در Claude با GPT متفاوت است. Claude delimiterهای ساختارمند (XML tags) را بهعنوان مرزهای معنایی پردازش میکند. این یعنی وقتی <code> یا <thinking> مینویسید، مدل واقعاً آن را بهعنوان یک واحد جداگانه در attention map میبیند. در GPT این رفتار به همین شدت وجود ندارد.
XML tagging چه زمانی مؤثر است و چه زمانی overhead بیهوده؟ وقتی چند بخش متفاوت در یک پرامپت دارید — دستور، context، خروجی مورد انتظار — جدا کردنشان با XML tags کیفیت را بالا میبرد. ولی اگر پرامپت کوتاه و تکبخشی است، اضافهکردن tags فقط token مصرف میکند بدون بهبود معنادار.
توصیهی رایج «prompt را انگلیسی بنویسید» را جدی نگیرید. مشکل quality of instruction است نه زبان. Claude در فارسی عملکرد قابلقبولی دارد. برای کدنویسی، ساختاردهی XML و دستور دقیق مهمتر از زبان پرامپت است.
الگوی structured prompting برای پروژههای کدنویسی#
یک الگوی تکرارشونده در پروژههای واقعی: پرامپت را به سه بخش XML تقسیم کنید — <task> برای شرح کار، <context> برای فایلها و محدودیتها، و <output_format> برای ساختار خروجی مورد انتظار. این الگو در پروژههای اعضای Claude School بارها تکرار شده و خروجیهای قابلپیشبینیتری تولید میکند.
چهچیزهایی را در system prompt نگذاریم#
دستورات متناقض، نقشهای نمایشی («تو یک senior developer با 20 سال سابقه هستی»)، و chain-of-thought اجباری. نقش نمایشی token مصرف میکند بدون اینکه رفتار مدل را واقعاً تغییر دهد. chain-of-thought اجباری در نسخههای جدیدتر Claude performance را کاهش میدهد چون مدل الگوی reasoning داخلی دارد و دستور اضافه آن را مختل میکند.
Few-shot در Claude: تعداد مثال و تنوع آن تأثیر مستقیم بر token count دارد. سه مثال متنوع بهتر از ده مثال تکراری عمل میکند. هر مثال اضافه، هزینهی هر request را بالا میبرد — در workflowهای ایجنتمحور که پرامپت بارها ارسال میشود، این تفاوت هزینهی محسوسی ایجاد میکند.
Context collapse: الگوی شکست واقعی Claude Code در پروژههای چندفایلی#
Context collapse زمانی رخ میدهد که Claude Code چندین بار فایلهای بزرگ را reference کند و مدل بهجای حفظ همهی context، شروع به hallucination دربارهی محتوای فایلهای قبلی کند. حتی با context window 200K token، در پروژههای با بیش از 50 فایل این پدیده بهسرعت ظاهر میشود.
200K token context window تضمینکنندهی حفظ کیفیت نیست. مدل در عمل، tokenهای ابتدای context را بهتر از tokenهای میانی بهیاد میآورد. وقتی ده فایل 1000 خطی در context باشد، فایلهای میانی عملاً «فراموش» میشوند.
نشانههای context collapse در خروجی کد: ارجاع به متغیر یا تابعی که در فایل قبلی تعریف شده ولی با امضای اشتباه صدا زده میشود. import کردن moduleای که وجود ندارد. و ساختن کدی که با logic فایلهای قبلی سازگار نیست.
راهحل عملی: reset context بین فازهای مختلف کار. بعد از هر فاز (مثلاً بعد از ساخت schema، بعد از نوشتن API routes، بعد از نوشتن tests)، session جدید باز کنید. CLAUDE.md را بهعنوان persistent memory بین sessions استفاده کنید.
نشانههای context collapse در کد خروجی#
سه نشانهی عملی که در پروژههای واقعی بارها دیده شده:
- تابعی صدا زده میشود که با امضای متفاوتی تعریف شده — مثلاً
getUserById(id)صدا زده میشود ولی تعریف آنfindUser(id, options)است. - import از مسیری که قبلاً تغییر کرده — مدل مسیر قدیمی را بهیاد دارد و مسیر جدید را نه.
- تکرار منطق — مدل یک helper function را که قبلاً نوشته دوباره از صفر مینویسد چون «یادش رفته» قبلاً وجود دارد.
استراتژیهای RAG با Claude برای پروژههای بزرگ#
برای پروژههای بزرگ، بهجای ریختن همهی فایلها در context، از الگوی RAG (Retrieval-Augmented Generation) استفاده کنید: فقط فایلهای مرتبط با task فعلی را به Claude بدهید. CLAUDE.md نقش index را بازی میکند — خلاصهی ساختار پروژه، نام فایلها، و مسئولیت هر module را نگه میدارد. مدل بر اساس این خلاصه تصمیم میگیرد کدام فایل را بخواند.
الگوی planner-executor: چرا یک مدل برای طراحی و مدل دیگر برای اجرا بهتر است#
الگوی planner-executor یعنی دو مرحلهی مجزا با دو مدل مختلف: Opus برای planning و Sonnet برای execution. این معماری هزینه را کاهش میدهد، کیفیت را بالا میبرد، و debug را سادهتر میکند — چون خطا در planning مشخص است، خطا در execution مشخص است.
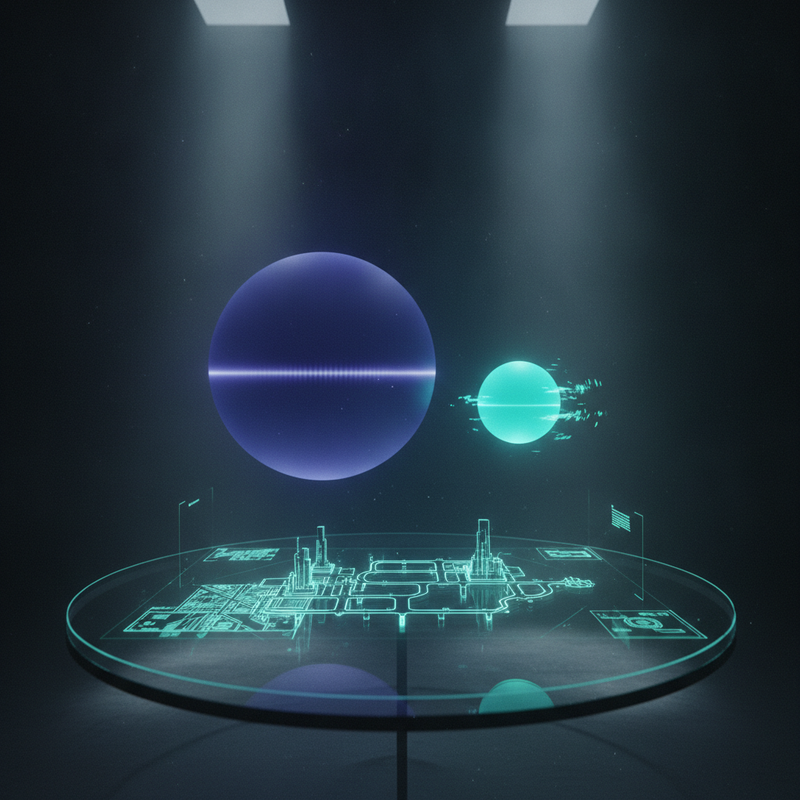
معماری planner-executor: مدل قویتر (Opus) فقط یک خروجی متنی تولید میکند — یک plan ساختارمند که فایلها، توابع، و ترتیب اجرا را مشخص میکند. مدل ارزانتر (Sonnet) آن plan را میگیرد و کد مینویسد. نقطهی اتصال، خروجی plan است.
چرا Sonnet برای execution کافی است؟ Claude 3.5 Sonnet در SWE-bench Lite عملکرد قابلقبولی در مسائل bug-fixing کدنویسی نشان داد. برای کارهای boilerplate و implementation، این سطح کیفیت کافی است. Opus فقط وقتی توجیه دارد که مسئله نیاز به reasoning عمیق چندمرحلهای دارد.
اشتباه رایج: «همیشه از Opus استفاده کنید» بدون توجه به نوع task. در workflow ایجنتمحور که دهها request در دقیقه ارسال میشود، تفاوت هزینهی Opus و Sonnet سرسامآور میشود بدون اینکه کیفیت خروجی execution تفاوت محسوسی کند.
پیادهسازی planner-executor با Claude API#
گامهای عملی این الگو:
- با Opus یک پرامپت planning بسازید که خروجیاش JSON ساختارمند باشد: فایلها، توابع، ترتیب، و وابستگیها.
- خروجی plan را validate کنید — مطمئن شوید همهی فایلهای موردنیاز ذکر شدهاند.
- برای هر فایل در plan، با Sonnet یک request execution جداگانه بفرستید.
- خروجی هر فایل را review کنید و در صورت نیاز، فقط آن فایل را regenerate کنید.
- در صورت خطا، مشخص کنید خطا در planning است یا execution — و فقط همان لایه را اصلاح کنید.
Extended Thinking و tradeoff latency در مسائل چندمرحلهای#
نسخههای جدیدتر Claude قابلیت Extended Thinking دارند که مدل قبل از پاسخ، reasoning داخلی طولانیتری انجام میدهد. این برای مسائل architecture design و debugging پیچیده مؤثر است. اما latency چندبرابری دارد و token مصرفیاش بالاتر است. برای execution ساده، این overhead توجیه اقتصادی ندارد.
MCP: اتصال Claude Code به ابزارهای خارجی با استاندارد باز#
Model Context Protocol (MCP) یک استاندارد باز برای اتصال مدلهای زبانی به ابزارهای خارجی است که نوامبر 2024 توسط Anthropic معرفی شد؛ در عمل به Claude Code اجازه میدهد دیتابیس، API، و فایلسیستم را بهصورت tool صدا بزند.
معماری MCP مبتنی بر client-server است. یک MCP server ابزارها را expose میکند، client (Claude Code) آنها را کشف و صدا میزند. message format ساده است و با JSON-RPC کار میکند. نصب و پیکربندی MCP server برای Claude Code از طریق فایل تنظیمات انجام میشود.
مقایسه با Tool Use سنتی در API: Tool Use یکبار و stateless است — شما schema تعریف میکنید و مدل صدا میزند. MCP stateful است — server زنده میماند، context نگه میدارد، و میتواند چندین round-trip داشته باشد. برای ابزارهایی که نیاز به connection pool دارند (دیتابیس، API با auth)، MCP مناسبتر است.
ساخت MCP server امن برای محیط سازمانی#
اشتباه رایج در production: server بدون timeout و retry logic. اولین خطای شبکه کل workflow را متوقف میکند. حداقل سه اقدام امنیتی لازم است:
- timeout مشخص برای هر tool call — بدون آن، یک request hang شده کل session را قفل میکند.
- retry logic با exponential backoff — نه retry بینهایت، نه بدون retry.
- input validation و minimal access — دسترسیهای tool را به حداقل برسانید. server فقط به دادههایی دسترسی داشته باشد که واقعاً لازم است.
این موارد در نمونههای آموزشی معمولاً دیده نمیشوند چون demoها روی localhost اجرا میشوند و شبکه بینقص فرض میشود.
ابزارهای مکمل Claude Code: IDE extensions و CLI workflows#
Claude Code را میتوان در کنار IDE extensionها استفاده کرد. الگوی رایج: در IDE کد میزنید، برای کارهای چندفایلی و refactoring به Claude Code در terminal میروید، و برای سوالهای سریع از Cursor یا Copilot استفاده میکنید. این سه ابزار مکملاند نه رقیب.
کدام مدل Claude برای کدنویسی بهتر است؟#
Claude 3.5 Sonnet در بسیاری از کارهای کدنویسی عملکردی نزدیک به Opus ارائه میدهد در حالی که هزینهی آن چندین برابر کمتر است؛ Haiku برای tasks ساده و latency-sensitive مناسب است و Opus فقط برای مسائل پیچیدهی reasoning-محور توجیه اقتصادی دارد.
تصمیمگیری بر اساس نوع task: برای boilerplate و CRUD، Haiku کافی است. برای refactoring و نوشتن test، Sonnet بهینه است. برای architecture design و debugging مسائل پیچیده، Opus توجیه دارد. برای extended thinking در مسائل چندمرحلهای، فقط Opus.
| مدل | سرعت پاسخ | کیفیت کدنویسی | هزینه (تقریبی) | بهترین کاربرد |
|---|---|---|---|---|
| Haiku | بسیار سریع | مناسب boilerplate | کمترین | فرمهای تکراری، سادهسازی کد |
| Sonnet | متوسط | خوب برای اکثر tasks | متوسط | refactoring، نوشتن test، execution در planner-executor |
| Opus | کند | بهترین برای reasoning | بیشترین | architecture design، debugging پیچیده، planning |
benchmarkهای عمومی گمراهکنندهاند — چرا task-specific performance مهم است#
نمرهی SWE-bench یک عدد کلی است. در عمل، مدلها در taskهای متفاوت performance متفاوت دارند. Sonnet در نوشتن کد React خوب عمل میکند ولی در architecture design پیچیده ممکن است به Opus نیاز باشد. benchmarkهای عمومی را بهعنوان نقطهی شروع ببینید، نه معیار نهایی. task-specific test روی پروژهی خودتان انجام دهید.
هزینهی Claude API و استراتژیهای کاهش token usage#
قیمت Claude API برای Sonnet حدود 3 دلار ورودی و 15 دلار خروجی بهازای هر میلیون token است؛ در پروژههای کدنویسی، بخش عمدهای از هزینه از خروجیهای تکراری و contextهای بلااستفاده میآید. استراتژیهای کاهش token usage تفاوت هزینهی محسوسی ایجاد میکنند.
محاسبهی token: token count با word count فرق دارد. یک کلمهی فارسی معمولاً 2 تا 3 token است، یک کلمهی انگلیسی معمولاً 1 تا 2 token. کد و فرمتهای ساختارمند token بیشتری مصرف میکنند چون characters خاص (بریس، پرانتز، semicolon) هرکدام token جداگانهاند.
استراتژیهای کاهش:
- max_tokens را مشخص تنظیم کنید — نگذارید مدل آزادانه تولید کند.
- contextهای غیرمرتبط را حذف کنید — فقط فایلهای مرتبط با task فعلی را بفرستید.
- streaming استفاده کنید تا در صورت نیاز، mid-response قطع کنید.
- در workflow ایجنتمحور، plan را cache کنید و بارها استفاده مجدد نکنید.
Claude Pro و Max plan: برای استفادهی شخصی و مکرر، اشتراک معمولاً بهصرفهتر از API است. Max محدودیتهای استفادهی بسیار بالاتری دارد و برای workflowهای سنگین با Claude Code و ایجنتها طراحی شده است. Pro برای استفادهی معمولی کافی است.
بهینهسازی هزینه در workflowهای ایجنتمحور#
در workflow ایجنتمحور، هر turn یک request جدید است. اگر 20 turn لازم باشد و هر turn 5000 token خروجی تولید کند، هزینهی یک task ساده بهسرعت بالا میرود. الگوی planner-executor در اینجا مؤثر است: یک request گران با Opus برای planning، و دهها request ارزان با Sonnet برای execution. مجموع هزینه کمتر از استفادهی Opus در همهی مراحل است.
Rate limit و retry strategy در production: بدون retry logic، اولین خطای rate limit کل workflow را متوقف میکند. exponential backoff با حداکثر 3 retry، الگوی استاندارد است.
نتیجهی عملی: Claude Code و پرامپتنویسی Claude در پروژههای چندفایلی نیاز به معماری آگاهانه دارند — context reset، planner-executor، و MCP با timeout. بدون این الگوها، حتی قویترین مدل هم در پروژههای بزرگ شکست میخورد.
اگر میخواهید این الگوها را در عمل تمرین کنید و روی پروژههای واقعی کار کنید، دورهی «آموزش جامع Claude و ابزارهای مشابه» در Claude School دقیقاً همین workflowهای چندفایلی و ایجنتمحور را پوشش میدهد — با تمرین روی پروژههای واقعی نه فقط demo.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.