

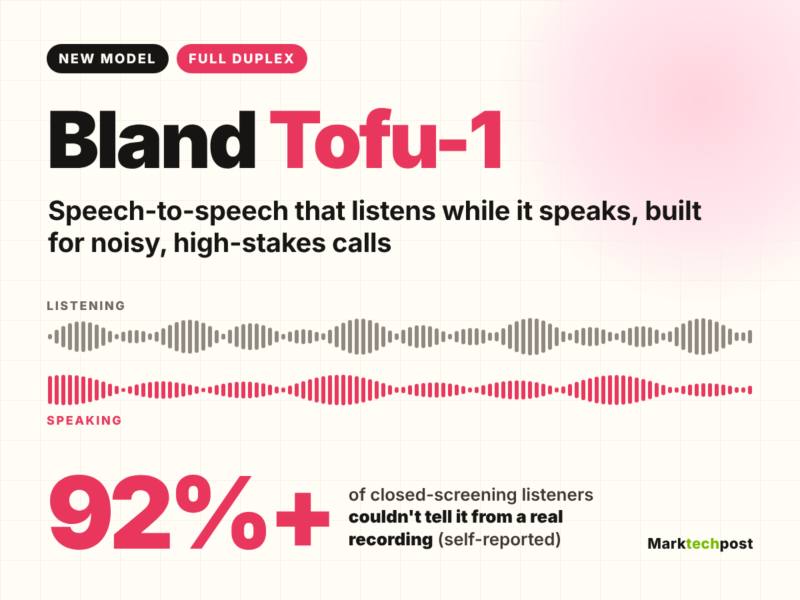


شرکت Bland، فعال در حوزه هوش مصنوعی صوتی و مستقر در سانفرانسیسکو، مدل Tofu-1 را بهعنوان پیشنمایش پژوهشی منتشر کرد. این مدل یک سیستم تمامدودکش گفتاربهگفتار است که در تماسهای تلفنی، صدای ورودی را مستقیماً میشنود و بدون واسطهی متن، پاسخ صوتی تولید میکند. هدفگذاری اصلی، تماسهایی است که در آنها نویز محیطی بالاست: خودروی در حرکت، اتاق بیمارستان، خطوط با سیگنال ضعیف.
Tofu-1 نخستین انتشار در خانوادهای از مدلهای گفتاربهگفتار است که Bland برنامهریزی کرده، اما جزئیات معماری داخلی منتشر نشده و تعداد پارامترها نامشخص است.
تفاوت با مدلهای آبشاری#
بیشتر عاملهای صوتی فعلی ساختار آبشاری دارند: ابتدا گفتار به متن تبدیل میشود، سپس مدل زبانی پاسخ را تولید میکند، و در نهایت متن به گفتار تبدیل میشود. در این مسیر، لحن، مکث و صدای پسزمینه از بین میروند. Tofu-1 صدای خام را میشنود و این اطلاعات را نگه میدارد. سه قابلیت صوتی که Bland روی صفحهی محصول اعلام کرده:
- ردیابی گوینده: تفکیک افراد و تشخیص اینکه هر کدام با چه کسی صحبت میکند.
- جداسازی نویز: تفکیک صدا از گریهی کودک، تلویزیون، ترافیک، بلندگوی بیمارستان یا صدای دکمههای تلفن.
- پارالینگویستیک: تشخیص مکث، نارضایتی و فوریت در لحن.
در حالت تمامدودکش، تماسگیرنده میتواند در میانهی جمله مدل را قطع کند. مدل همزمان که روی یک درخواست کار میکند، گفتگو را ادامه میدهد و نتیجه را فقط وقتی کار تمام شد گزارش میکند.
مقایسه با رقبای تمامدودکش#
جدول مقایسهای که Bland ارائه کرده، Tofu-1 را در کنار OpenAI GPT-Live-1، NVIDIA NemotronLabs VoiceChat 11B و Block Dessa قرار میدهد. نکتهی قابلتوجه این است که Tofu-1 نه تعداد پارامتر، نه تأخیر نوبتگیری، نه بنچمارک و نه قیمت منتشر کرده — در حالی که رقبا حداقل بخشی از این اعداد را دارند. تنها عددی که Bland ارائه کرده، نتیجهی خودگزارشدهیشده است: بیش از ۹۲ درصد شرکتکنندگان در یک غربالگری نتوانستند تشخیص دهند طرف مقابل انسان است یا مدل.
دسترسی#
پیشنمایش پژوهشی فقط برای تعداد محدودی سازمان باز است. بخشهای هدف: بانکداری، بهداشت، بیمه و دولت. فرم ثبتنام حجم تماس ماهانه را میپرسد (از زیر ۱٬۰۰۰ تا بیش از ۵۰٬۰۰۰). Bland اشاره کرده که دسترسی عمومی در ژانویه ممکن میشود.
این خبر برای کسی که همین حالا ایجنت صوتی میسازد چه معنایی دارد#
اگر تیم شما در حال ساخت عامل صوتی برای تماسهای تلفنی است، Tofu-1 نشان میدهد که مسیر «حذف لایهی متن» از آبشار به سمت مدل یکپارچه گفتاربهگفتار، حداقل از نظر فنی عملی شده است. اما عملاً فعلاً چیزی عوض نمیکند: بدون بنچمارک، بدون تأخیر اعلامشده، بدون قیمت و بدون دسترسی عمومی، نمیتوانید تصمیم فنی بگیرید. احتیاط اصلی اینجا است که عدد ۹۲ درصد خودگزارشدهیشده است و شرایط آزمایش مشخص نیست. تا زمانی که دادهی قابلمقایسه منتشر شود، این مدل برای اکثر تیمها یک سیگنال جهتدار است، نه یک ابزار قابلاستفاده.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.