


چگونه در n8n ایجنت هوش مصنوعی (AI Agent) بسازیم که واقعاً استدلال کند؟#
ساخت ایجنت هوش مصنوعی (AI Agent) در n8n نیاز به کدنویسی ندارد؛ بلکه بر پایهی طراحی بصری ورکفلو و مدیریت دقیق حافظه استوار است. با جایگزینی نودهای Agent بهجای API Request، میتوان چرخههای استدلال چندمرحلهای ساخت که تصمیمگیریها را قبل از اجرا توسط انسان تأیید میکنند.
آیا n8n واقعاً نیاز به کدنویسی دارد یا Drag & Drop کافی است؟#
n8n با رابط بصری Drag & Drop طراحی شده اما درک منطق جریان داده (Data Flow Logic) برای پیکربندی صحیح نودها الزامی است. اگرچه ظاهر ابزار بدون کد است، اما مهندسان داده باید بدانند چگونه خروجی یک نود JSON را به ورودی نود بعدی تبدیل کنند تا ایجنت دچار خطا نشود.
معماری و مفاهیم پایه n8n#
برخلاف بسیاری از ابزارهای اتوماسیون که فریمورکهای بسته دارند، n8n اجازه میدهد هر نود (Node) را مستقل پیکربندی کنید. یادگیری نحوه اتصال ورودیها و خروجیها بین نودها، پیشنیاز اصلی است. برای مثال، وقتی نود AI Agent تصمیم میگیرد، نمیتواند مستقیماً به دیتابیس وصل شود؛ باید ابتدا نتیجه را از طریق نودهای شرطی یا Map هدایت کند.
انتخاب بین Self-hosted و Cloud#
برای پروژههای مبتنی بر ایجنت هوش مصنوعی (AI Agent)، کنترل کامل روی دادهها حیاتی است. نسخه Community Edition کاملاً متنباز است و امکان نصب روی سرور شخصی را فراهم میکند. این انتخاب امنیت دادهها را تضمین کرده و هزینههای اشتراک ابری را حذف میکند. همچنین دسترسی مستقیم به منابع داخلی سازمان برای Retrieval-Augmented Generation (RAG) را آسانتر میکند.
| ویژگی | n8n Cloud | n8n Self-hosted |
|---|---|---|
| مدیریت زیرساخت | توسط شرکت n8n | توسط تیم فنی شما |
| امنیت دادهها | اشتراکی | کاملاً خصوصی و ایزوله |
| هزینه بلندمدت | بالا برای مقیاس بزرگ | فقط هزینه سرور |
تفاوت اصلی اتوماسیون معمولی با ایجنت هوش مصنوعی در n8n چیست؟#
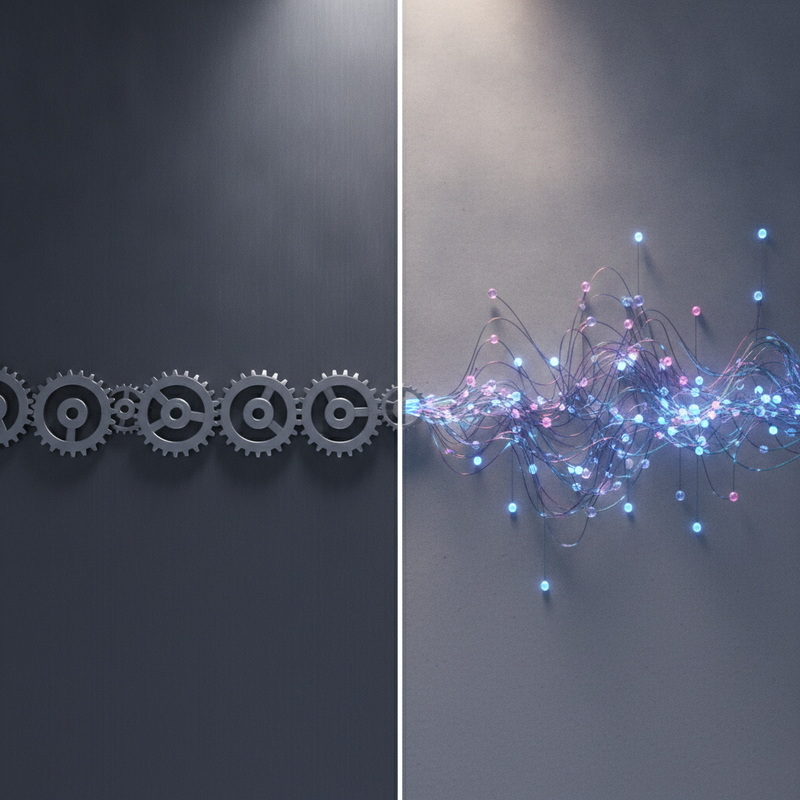
اتوماسیون سنتی اجرای خطی (Linear Workflow) دارد، اما ایجنت هوش مصنوعی (AI Agent) دارای چرخههای استدلال و تصمیمگیری خودکار است. در روش قدیمی، شما برای هر سناریو یک مسیر جداگانه تعریف میکردید؛ اما ایجنت با تحلیل پرامپت، خودش مسیر درست را انتخاب میکند.
نقد روشهای قدیمی: چرا HTTP Request کافی نیست؟#
استفاده صرف از نودهای API REST برای ارسال درخواست به مدل زبانی بزرگ (Large Language Model - LLM) دیگر بهینه نیست. این روش فاقد مدیریت وضعیت و حافظه است. نودهای اختصاصی Agent در n8n این خلأ را پر کرده و قابلیت استدلال چندمرحلهای را اضافه میکنند. یعنی ایجنت میتواند در صورت ابهام، سوال بپرسد یا ابزار دیگری فراخوانی کند.
الگوی تعامل چندمرحلهای (Multi-turn Interaction)#
ایجنت واقعی باید بتواند در یک گفتگو، سوال بعدی را بر اساس پاسخ قبلی تعیین کند. این رفتار با استفاده از حلقههای کنترلی و ذخیرهسازی برداری (Vector Storage) برای دسترسی سریع به دانش سازمانی پیادهسازی میشود. بهجای اینکه هر پیام را جدای پردازش کنید، تاریخچه مکالمات را به عنوان Context به ایجنت تزریق کنید.
- تعریف نود Agent برای تحلیل Intent کاربر.
- اتصال نود Vector Store برای جستجوی اسناد مرتبط.
- هدایت خروجی به نودهای عملیاتی پس از تایید صحت.
ساخت یک ایجنت هوشمند در n8n چقدر زمان میبرد؟#
با استفاده از Templateهای آماده و نودهای بصری، راهاندازی اولیه و تست یک سناریوی ساده زمان بسیار کمی نیاز دارد. البته رسیدن به دقت بالا نیاز به تنظیم Promptها و تست خطاها دارد، اما هسته اولیه بسیار سریع ساخته میشود.
ابزارهای کلیدی: Agent Node و AI Memory#
نود Agent وظیفه تجزیه درخواست کاربر را دارد و نود AI Memory مسئول ذخیره و بازیابی اطلاعات زمینهای است. ترکیب این دو، هسته مرکزی هر ایجنت هوشمند در n8n را تشکیل میدهند. بدون Memory، ایجنت مانند ماهیgoldfish است که هر جمله را تازه میشنود.
راهنمای گامبهگام ساخت اولین ایجنت#
- یک ورکفلو جدید ایجاد کنید و آن را Trigger کنید.
- نود Agent را به عنوان نقطه شروع قرار دهید.
- نود Memory را متصل کنید تا تاریخچه گفتگو حفظ شود.
- ابزارهای لازم (Tools) مثل Google Search یا Database را به Agent معرفی کنید.
- در نهایت، خروجی را به نودهای عملیات (مانند ایمیل یا دیتابیس) متصل نمایید.
این روند ساده، قدرت استدلال را به ورکفلوهای معمولی اضافه میکند. برای یادگیری عمیقتر این فرآیند، دوره «ساخت Ai Agent با N8N» در اسکول میتواند مسیر را کوتاهتر کند.
چگونه میتوان حافظه را در ایجنتهای n8n مدیریت کرد؟#
مدیریت حافظه شامل تقسیمبندی Short-term vs Long-term Memory است که توسط نودهای مخصوص در n8n انجام میشود. این دو نوع حافظه نقشهای متفاوتی دارند: یکی برای روانی مکالمه فعلی و دیگری برای دانش پایدار سازمان.
ذخیرهسازی برداری (Vector Storage)#
برای دسترسی به اسناد طولانی، از Retrieval-Augmented Generation (RAG) استفاده کنید. n8n با اتصال به سرویسهای Vector Database، پرسشهای کاربر را با اسناد موجود تطبیق داده و پاسخ دقیقتری تولید میکند. این تکنیک توهم دانستن را در مدلهای زبانی کاهش میدهد.
مدیریت وضعیت و حافظه در گردشهای تکرارشونده#
حافظه کوتاهمدت فقط برای چت فعلی نگه داشته میشود. برای حافظه بلندمدت، باید از State Management استفاده کرد تا ایجنت بین جلسات مختلف، ترجیحات کاربر را به خاطر بسپارد. تنظیم Window Size در نودهای حافظه، میزان مصرف توکن را کنترل میکند.
| نوع حافظه | کاربرد | ابزار پیشنهادی |
|---|---|---|
| Short-term | پیوستگی مکالمه جاری | Conversation Buffer Memory |
| Long-term | یادگیری از کاربران خاص | Redis / Postgres Memory |
| Semantic | جستجو در دانش سازمان | Pinecone / Qdrant |
بهترین راه برای جلوگیری از پاسخهای غلط ایجنتها در n8n چیست؟#
پیادهسازی Human-in-the-loop و محدود کردن دامنه استدلال ایجنت با Prompt Engineering دقیق. هیچ مدلی ۱۰۰٪ دقیق نیست؛ بنابراین معماری سیستم باید طوری باشد که خطا قبل از رسیدن به مشتری شناسایی شود.
پیادهسازی Human-in-the-loop#
برای اقدامات حساس، نود Approve/Reject را در زنجیره قرار دهید. این کار باعث میشود ایجنت قبل از ارسال نهایی، منتظر تأیید انسانی بماند و از بروز خطاهای فاجعهبار جلوگیری شود. این الگو در اتوماسیونهای مالی یا حقوقی حیاتی است.
مدیریت خطاها و Observability#
فعالسازی لاگگیری دقیق در n8n به شما اجازه میدهد مسیر تصمیمگیری ایجنت را ردیابی کنید. استفاده از Error Handling Nodes برای مدیریت استثناها ضروری است. وقتی ایجنت شکست میخورد، باید مسیر مشخصی برای fallback داشته باشید.
هزینه استفاده از n8n چقدر است و آیا نسخه رایگان کافی است؟#
نسخه Community رایگان است، اما هزینه اصلی مربوط به مصرف توکن (Token Costs) مدل زبانی بزرگ (LLM) است. n8n فقط واسط است؛ پول شما به API Keyهایی پرداخت میشود که به آنها متصل میشوید.
بهینهسازی هزینهها و مدیریت توکنهای LLM#
برای کاهش هزینه، از مدلهای ارزانتر برای مراحل اولیه استدلال و مدلهای قویتر فقط برای تولید نهایی استفاده کنید. پیکربندی درست توکنها در نودهای Agent میتواند هزینهها را بهینه کند. همچنین استفاده از Cache برای پرسشهای تکراری ضروری است.
تحلیل خطاهای رایج در نودهای هوش مصنوعی#
بیشتر خطاها ناشی از Timeout یا نرخ بالای درخواست است. تنظیم Retry Policies و استفاده از Queue برای پردازش موازی، پایداری سیستم را افزایش میدهد. اگر ایجنت شما کند عمل میکند، احتمالاً در مرحله استدلال گیر کرده است، نه در دریافت پاسخ.
ساخت ایجنت هوشمند در n8n ترکیبی از مهارت فنی در مدیریت داده و درک رفتار مدلهای زبانی است. با رعایت اصول Human-in-the-loop و مدیریت صحیح حافظه، میتوان سیستمهایی ساخت که نه تنها کارها را انجام میدهند، بلکه درست هم انجام میدهند. برای کسانی که میخواهند از این پیچیدگیها عبور کنند و مستقیماً وارد فاز ساخت محصول شوند، شرکت در چالش «۰ تا ۱۰۰ تبدیل ایده به پول با Ai» میتواند نقطه شروع قدرتمندی باشد.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.