

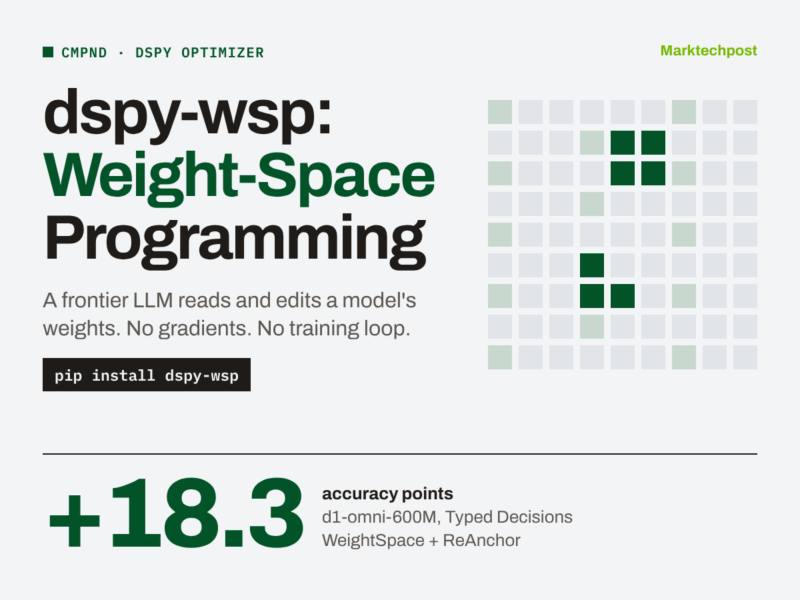


شرکت Cmpnd ابزار dspy-wsp را منتشر کرد؛ یک بهینهساز نمونهآزمایشی که وزنهای یک مدل کوچک را با کمک یک مدل زبانی بزرگ ویرایش میکند — بدون گرادیان، بدون حلقهی آموزش و بدون دادهی fine-tuning. این ابزار در قالب یک optimizer به نام WeightSpace در هر برنامهی DSPy قابل استفاده است و تحت مجوز MIT با pip install dspy-wsp نصب میشود. نسخهی DSPy 3.5 به بالا لازم است.
عملکرد: از +۱.۹ تا +۲۰.۰ امتیاز#
تستها روی مدلهای تصمیمگیر باز از 0.6B تا 9B پارامتر انجام شده. نتایج:
- بهترین نتیجه: مدل d1-omni-600M از 50.9% به 69.1% رسید (+18.3 امتیاز) با ترکیب WeightSpace و ReAnchor.
- بدترین نتیجه: مدل Clef-Flash (9B) فقط 1.9 امتیاز از WeightSpace بهتنهایی گرفت.
- محدودهی کلی بهبود WeightSpace تنها: 1.9 تا 16.1 امتیاز روی معیار Typed Decisions. با ReAnchor: 6.5 تا 20.0 امتیاز.
هزینهی هر اجرا حدود 5 تا 10 دلار فراخوانی GPT-6-Astra است. زمان اجرا بین 78 تا 167 دقیقه برای هر دور 25-pass متغیر است.
محدودیتها#
نتایج نشان میدهد که هرچه مدل بزرگتر، بهبود کمتر. مدل 9B تقریباً بیاثر بوده. در پژوهش اصلی MIT روی Gemma 3 270M، ویرایشها MATH-500 را از 6.8% فقط به 7.0 تا 7.7% رساندند و تیم پژوهشی آن را بهبود واقعی حساب نکرد. WSP میتواند یک مانع را حذف کند، اما توانایی جدیدی اضافه نمیکند.
معماری سهنقشی#
دو بازیگر اصلی: student (مدل کوچک شما که وزنهایش در یک پروسهی محلی Python بارگذاری میشود) و writer (یک مدل زبانی بزرگ، توصیهشده: gpt-6-astra با حداکثر تلاش استدلالی). Writer در هر نوبت یک بلوک کد Python برای خواندن یا ویرایش وزنها یا یک بلوک forward برای اجرای برنامهی DSPy روی نمونههای تمرینی تولید میکند. بودجهی forward-pass ثابت است (max_passes=25 در تستها).
مدلهای 2B حدود 6 گیگابایت حافظه نیاز دارند. d1-omni-600M حداقل 4 گیگابایت. تمام آزمایشها روی یک Mac اجرا شدهاند.
خوانش تحریریه#
برای کسی که همین حالا با DSPy ایجنت میسازد، dspy-wsp در عمل چیزی عوض نمیکند. این ابزار یک prototype است، نه محصول آمادهی تولید. محدودیتهایش جدیاند: سرعت پایین (یک ویرایش ساده ۸۰ دقیقه طول میکشد)، عملکرد ضعیف روی مدلهای بزرگ، و وابستگی به یک مدل خاص (GPT-6-Astra). اما ایدهی پشت آن — اینکه یک LLM بتواند بدون گرادیان و بدون دادهی آموزش، یک لایه یا یک head از وزنها را با استدلال ویرایش کند — مسیر تازهای را نشان میدهد. اگر DSPy را برای مدلهای کوچک تصمیمگیر زیر 2B پارامتر استفاده میکنید و مشکل شما «یک رفتار نادرست در یک بخش خاص» است، این ابزار یک گزینهی کمهزینه و قابلتست است. اگر مدل بزرگتر دارید، فعلاً fine-tuning معمولی همچنان منطقیتر است.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.