

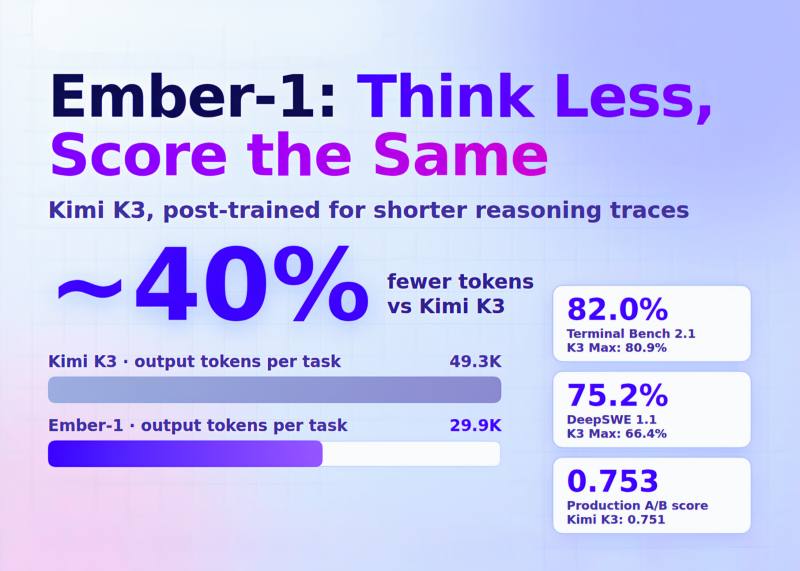


Fireworks AI مدل Ember-1 را منتشر کرد؛ نسخهای post-trained از Kimi K3 (مدل متنباز Moonshot AI) که با حدود ۴۰٪ توکن کمتر، دقت مشابهی در تکالیف مختلف حفظ میکند. این مدل فقط از طریق serverless API شرکت Fireworks و بهصورت Research Preview در دسترس است. وزنها، کد آموزش و الگوریتمهای دقیق آن منتشر نشدهاند، بنابراین خودمیزبانی ممکن نیست.
مشکل: توکنهای استدلالی در کارهای چندمرحلهای هزینه را دوچندان میکند#
به گفتهی تیم Fireworks، مدلهای استدلالی مثل Kimi K3 گاهی بیش از ۹۰٪ توکنهای تولیدشده را صرف استدلال داخلی میکنند. در بارهای کاری چندمرحلهای (agentic) این هزینه تشدید میشود، چون هر نوبت، استدلالهای قبلی را دوباره به مدل میفرستد و context تقریباً بهصورت درجهدوم با تعداد نوبتها رشد میکند.
کاهش reasoning effort در زمان استنتاج مشکل را حل نکرد؛ کیفیت بهطور نامتناسب افت میکرد. بنابراین تیم بهجای تنظیم inference، مدل را آموزش داد تا کارآمدتر استدلال کند.
نتایج بنچمارک و تست تولیدی#
Fireworks نتایج خود را با Kimi K3 در سه سطح reasoning effort مقایسه کرد:
- Terminal Bench 2.1: دقت ۸۲.۰٪ (در برابر ۸۰.۹٪ K3 Max) با کاهش ۵۱.۹٪ هزینه
- DeepSWE 1.1: دقت ۷۵.۲٪ (در برابر ۶۶.۴٪ K3 Max) با کاهش ۲۳.۷٪ هزینه
- SWE-bench Verified: دقت ۹۲.۲٪ (در برابر ۹۳.۲٪ K3 Max) با کاهش ۱۵.۵٪ هزینه
- SWE-Interact: دقت ۲۰.۰٪ (در برابر ۲۱.۳٪ K3 Max) با کاهش ۳۲.۵٪ هزینه
در تست A/B زنده با دو مشتری روی بارهای کاری تولیدی کدنویسی، توکنهای خروجی از ۴۹.۳K به ۲۹.۹K در هر تکلیف رسید (کاهش ۳۹٪ کل توکنها و ۷۱.۳٪ توکنهای استدلالی) در حالی که نمرهی تکلیف تقریباً ثابت ماند: ۰.۷۵۳ برای Ember-1 در برابر ۰.۷۵۱ برای K3. یک مشتری اکنون Ember-1 را در محیط تولید اجرا میکند.
قیمتگذاری هر توکن مشابه Kimi K3 است: ۳.۰۰ دلار ورودی، ۰.۳۰ دلار ورودی کششده و ۱۵.۰۰ دلار خروجی به ازای هر میلیون توکن. صرفهجویی صرفاً از تولید توکن کمتر میآید.
Ember-1 چه چیزی را عوض میکند و چه چیزی را نه#
برای کسی که ایجنتهای کدنویسی با Kimi K3 میسازد، ۴۰٪ کاهش توکن یعنی کاهش مستقیم هزینهی هر درخواست بدون افت محسوس دقت. اما سه محدودیت مهم باقی است: اول، دسترسی فقط از طریق API فایروالزدهی Fireworks است و امکان self-hosting وجود ندارد. دوم، الگوریتمهای آموزش منتشر نشدهاند، پس نمیتوان روش کار را بازتولید یا روی مدلهای دیگر اعمال کرد. سوم، در دو بنچمارک (SWE-bench Verified و SWE-Interact) دقت Ember-1 از K3 Max پایینتر است؛ یعنی این مدل در تکالیف نرمافزاری پیچیدهی چندمرحلهای هنوز همتراز نیست. اگر workload شما عمداً روی استدلالهای کوتاهترِ چندتور تمرکز دارد، این خبر عملی است؛ اگر روی دقت مطلق در SWE-bench حساس هستید، K3 Max هنوز انتخاب بهتری است.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.