

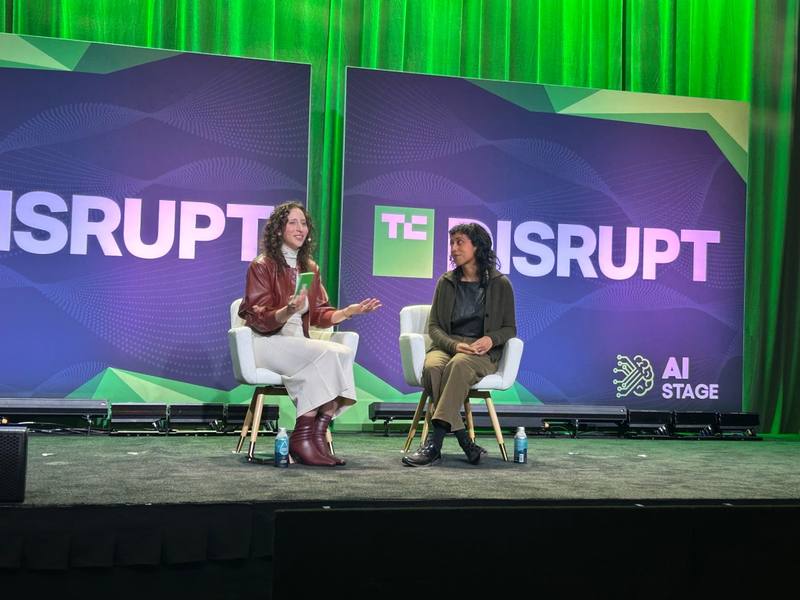
ایرین سلیمان، سرپرست سیاستگذاری Hugging Face، در گفتوگویی در رویداد TechCrunch Disrupt اعلام کرد که روشهای ارزیابی مدلهای هوش مصنوعی هنوز به بلوغ نرسیدهاند و ایدهٔ قرار دادن ارزیابهای شخص ثالث درون سازمانهای توسعهدهندهٔ مدل، «راهحل سادهای» نیست.
به گفتهٔ سلیمان، تکرارپذیری نتایج ارزیابی یکی از دشوارترین بخشهای benchmarking باقی مانده است. او تأکید کرد که دسترسی به وزنهای باز (open weights) مدل، نقش مهمی در امکانپذیر کردن تکرار نتایج دارد: «اعتماد واژهای سنگین است. بخشی از آن این است که آیا میتوانید نتایج یک ارزیابی را بازتولید کنید؟ آیا به مدل دسترسی لازم دارید؟ اینجا است که وزنهای باز نقش بزرگی بازی میکنند.»
سلیمان ارزیابیها را «علمی در حال تکامل» توصیف کرد که هنوز روش معناداری برای مقایسهٔ آنها با یکدیگر وجود ندارد. او افزود: «ارزیابیها نسبتاً سریع از کارایی میافتند و اکوسیستم پویایی که نیاز داریم شکل نگرفته است.»
ایدهٔ ارزیابهای درونسازمانی — یعنی ناظران شخص ثالثی که در داخل شرکتهای توسعهدهندهٔ مدل مستقر میشوند — در ماههای اخیر و پس از وقوع چندین حادثهٔ ایمنی در صنعت هوش مصنوعی رایج شده است. Hugging Face خود هدف یکی از آن حوادث بوده است. در مقابل، شرکتها بهجای تنظیمگری دولتی، این راهحل شخص ثالث را پیش میبرند. اما انتقاداتی وجود دارد: تصمیم Anthropic برای استخدام Accenture بهعنوان نخستین ارزیابش با واکنش منفی روبهرو شد و برخی منتقدان صلاحیت این شرکت مشاورهای را برای این کار زیر سؤال بردند.
سلیمان همچنین اشاره کرد که ارزیابیها از صرفاً سنجش مدل، به سنجش کل سیستم — شامل harness و ایجنت — در حال حرکتاند. به گفتهٔ او، مدل ضعیفتری با harness بهتر میتواند از یک مدل frontier پیشی بگیرد. «ارزیابیهای ایجنتی واقعاً سخت و واقعاً گراناند. ما ارزیابیهای بیشتری برای مدلها داریم، اما برای harnessها و ایجنتهای یکپارچه هنوز کم است.»
این خبر برای سازندگان ایجنت یعنی چه#
اگر همین حالا با ابزارهای موجود ایجنت یا اتوماسیون میسازید، پیام عملی این خبر این است که benchmarkهای فعلی — حتی آنهایی که شرکتهای بزرگ منتشر میکنند — هنوز پایهٔ مطمئنی برای تصمیمگیری نیستند. تکرارپذیری کم است، مقایسهٔ بین ارزیابیها مشکل دارد، و مهمتر اینکه نتیجهٔ ارزیابی یک مدل بهتنهایی، عملکرد واقعی آن را درون harness شما نشان نمیدهد. اگر میخواهید مدل مناسبی برای ایجنت خود انتخاب کنید، آزمون درونی و اختصاصی شما هنوز بهترین معیار است. اما این خبر چیز جدیدی را «حل» نکرده؛ فقط تأیید کرده که مشکل وجود دارد و هنوز راهحل استانداردسازیشدهای در دسترس نیست.
منبع: TechCrunch AI



دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.