

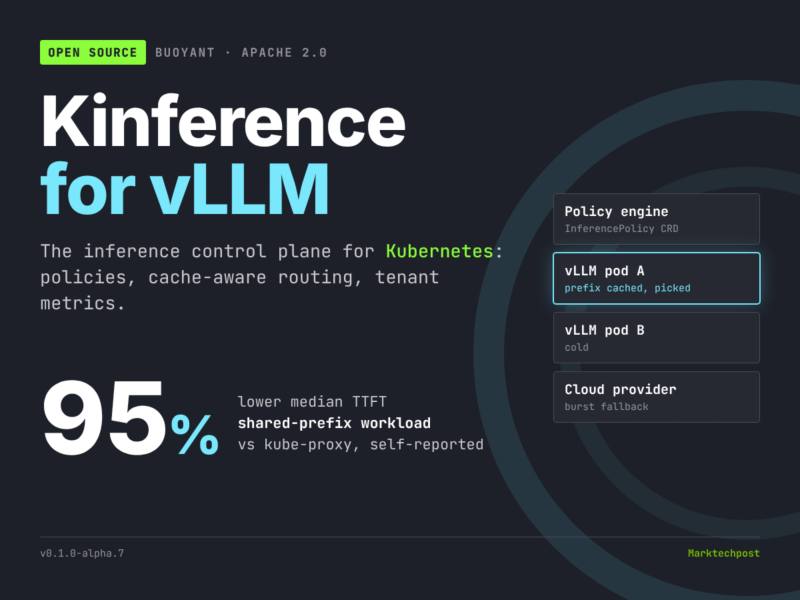


شرکت Buoyant، سازنده سرویسمِش Linkerd، پروژه Kinference را منتشر کرد؛ یک کنترلپلین بازمتن که لایهای بین Kubernetes و خوشه vLLM قرار میگیرد و تصمیم میگیرد هر درخواست استنتاج به کدام worker فرستاده شود. این پروژه با مجوز Apache 2.0 روی GitHub در دسترس است و در حال حاضر در نسخه v0.1.0-alpha.7 قرار دارد.
Kinference با زبان Rust نوشته شده و از طریق ۵ CRD در Kubernetes پیکربندی میشود: GatewayBackend، InferencePolicy، InferencePool، InferenceProvider و InferenceWorkerSet. معماری آن از دو بخش تشکیل شده: یک traffic gateway و یک inference handler که رابط gRPC دارد و با پروکسی مانند Buoyant Gateway جفت میشود. سیستم رویدادهای KV-cache و متریکهای موتور vLLM را رصد میکند و از crate dynamo-kv-router شرکت NVIDIA برای پردازش رویدادهای کش بهره میبرد.
پالیسیهای مسیریابی اعلامی#
هسته اصلی Kinference، InferencePolicy است: قواعد اعلامی که مشخص میکنند هر درخواست چگونه مسیریابی یا رد شود. قواعد میتوانند بر اساس tenant، مدل درخواستی، وضعیت GPU pool و تگهای معنایی تطبیق یابند. پنج الگوی نمونه در سایت پروژه آمده است:
- ساده به ارزانتر: پرامپتهای کمپیچیدگی به مدل کوچکتر فرستاده شوند، مگر اینکه همپوشانی کش مدل بزرگ را سریعتر کند.
- Burst به ابر: workerهایی با بیش از ۲ پرامپت در صف رد شوند و درخواست به providerهایی مانند Bedrock منتقل شود.
- PII محلی بماند: در صورت فعالشدن تگ PII، providerهای خارجی حذف و درخواست با onEmpty: Reject رد شود.
- Batch روی GPU بیکار: درخواستهای دستهای فقط به workerهایی با مصرف KV-cache زیر ۷۰ درصد ارسال شوند.
- Model aliasing: یک نام پایدار مانند standard-model پشت چند مدل مختلف منتشر شود.
بیشتر قواعد با minimize: PredictedTTFT پایان مییابند؛ یعنی Kinference زمان-to-first-token هر endpoint را با استفاده از همپوشانی کش و طول صف پیشبینی میکند.
بنچمارک خودگزارششده#
Buoyant بنچمارکی در مقابل بارگذاری تصادفی kube-proxy منتشر کرده است. هر بازو ۳ پاد vLLM 0.31.0 روی GPU L40S داشت و مدل Qwen3.8-27B-FP8 استفاده شد. نتایج:
- ترافیک با پیشوند مشترک: میانه TTFT از ۶/۸۸ ثانیه به ۰/۳۱ ثانیه کاهش یافت (حدود ۹۵ درصد). Goodput از ۱۴ به ۱۰۳ درخواست در دقیقه رسید (حدود ۷/۴ برابر).
- ترافیک چندنوبتی: میانه TTFT از ۱/۷۰ به ۰/۵۹ ثانیه کاهش یافت (حدود ۶۵ درصد). Goodput از ۲۳/۸ به ۸۲/۷ رسید (حدود ۳/۵ برابر).
- ترافیک بدون پیشوند مشترک: تفاوت معناداری وجود نداشت (۶/۹۲ در برابر ۶/۸۳ ثانیه).
این اعداد خودگزارششدهاند و خطمبنای مقایسه، مسیریابی تصادفی kube-proxy است، نه یک router آگاهبهکش مانند llm-d یا Dynamo. همچنین SLOهای تعریفشده (۸ و ۴ ثانیه) برای ایجنتهای آفلاین مناسباند، نه چت.
تحلیل تحریریه#
Kinference جای خالی مشخصی را پر میکند: لایهی حاکمیت و سیاستگذاری روی خوشه vLLM. تا پیش از این، اگر تیمی میخواست چند مدل مختلف را به چند tenant داخلی سرو کند و در عین حال قواعد PII، burst به ابر و aliasing مدل را بهصورت اعلامی مدیریت کند، باید این منطق را در اپلیکیشن خود پیادهسازی میکرد. حالا یک CRD به نام InferencePolicy این کار را ممکن میسازد.
اما این نسخه آلفا است و فاصلهاش تا استفادهی تولیدی هنوز زیاد است. موتور پشتیبانیشده فعلاً فقط vLLM است (SGLang و TensorRT-LLM در برنامه هستند)، disaggregated prefill/decode فاش نشده، و rate limiting چندمستأجر هنوز در برنامه است نه پیادهسازی. در مقایسه با llm-d (نسخه ۰/۷، مه ۲۰۲۶) و Dynamo (نسخه ۱/۵/۱)، Kinference از نظر بلوغ چندین نسل عقبتر است.
برای کسی که همین حالا روی Kubernetes با vLLM کار میکند و ترافیکش پیشوند مشترک دارد (مثلاً ایجنتهایی که سیستمپرامپت ثابت دارند)، عدد ۹۵ درصد کاهش TTFT قابلتوجه است — حتی اگر خطمبای آن kube-proxy باشد. اما اگر ترافیک متنوع و بدون پیشوند مشترک دارید، این بنچمارک چیزی به شما نمیگوید.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.