

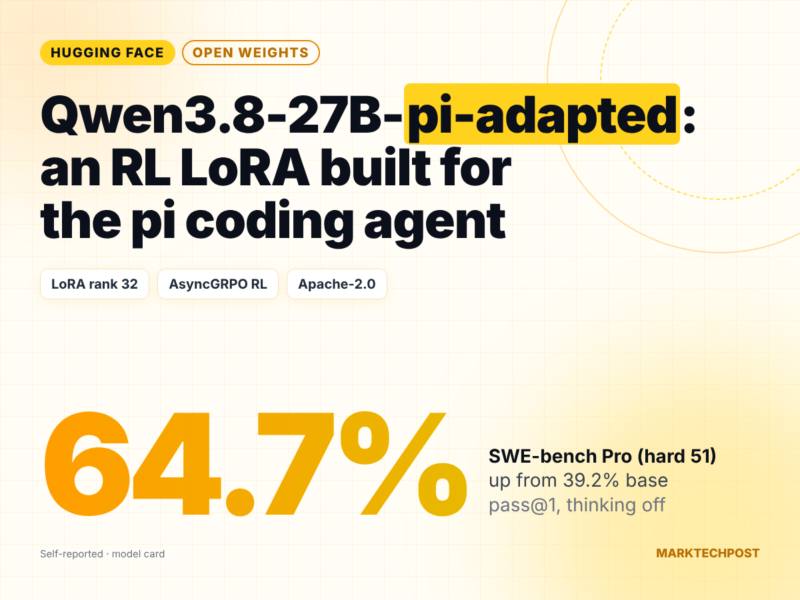


تیم harness-hub در Hugging Face یک LoRA adapter به نام Qwen3.8-27B-pi-adapted منتشر کرده که برای کار درون محیط pi — یک کیت ابزار عاملی با مجوز MIT — با یادگیری تقویتی آموزش دیده است. این adapter از نوع rank 32 (alpha 64) روی مدل پایه Qwen3.8-27B اعمال میشود و مجوز Apache-2.0 دارد.
عملکرد در بنچمارکها#
اعداد زیر خودگزارشیشده و فقط در محیط pi با thinking خاموش به دست آمدهاند:
- SWE-bench Pro (hard 51): از ۳۹.۲٪ به ۶۴.۷٪ رسید (+۲۵.۵ ± ۱۴.۲ واحد، p = 0.0023).
- Terminal-Bench 2.1: از ۳۹.۵٪ به ۵۵.۸٪ رسید (+۱۶.۳ ± ۹.۱ واحد، p = 0.0013).
نکته مهم: مدل پایه با thinking روشن خودش به ۶۴.۷٪ در SWE-bench Pro میرسد. یعنی adapter عملاً دقت سطح thinking را بدون پرداخت هزینه reasoning طولانی ارائه میدهد — با حدود ۴.۵ برابر توکن کمتر.
در کارهایی که هر دو مدل حل کردند، تعداد دورهای میانی در SWE-bench Pro از ۵۹ به ۲۳ و در Terminal-Bench 2.1 از ۱۸ به ۸ کاهش یافت.
روش آموزش#
آموزش با الگوریتم AsyncGRPO از کتابخانه TRL انجام شده: ۸ rollout در هر task، دمای ۰.۸، حداکثر ۵۰ گام عاملی و ۱۸۰۰ ثانیه برای هر rollout. پاداش شامل صحت پاسخبرر بهعلاوه یک بونوس بهرهوری ابزار با وزن ۰.۱ است. هر فراخوانی ابزار از فیلتر safeagents عبور میکند تا تقلب در پاداش مسدود شود. چکپوینت نهایی در گام ۱۶۰ گرفته شد، درحالیکه اجرا در گام ۱۹۱ از ۱۰۰۰ برنامهریزیشده متوقف شد. سختافزار آموزش: ۲ کارت NVIDIA B200.
راههای استقرار#
مدلکارت چهار مسیر استقرار ارائه میدهد:
- vLLM با پرچم
--enable-lora --max-lora-rank 32و thinking خاموش. - llama.cpp با GGUF adapter روی پایه Q8_0.
- Llama.app در macOS با context 32,768 توکن.
- ادغام (merge) با PEFT روی CPU و سرو چکپوینت BF16 حدود ۵۴ گیگابایتی بدون پرچم LoRA.
چون چند adapter یک پایه مشترک دارند، یک سرور میتواند بهطور همزمان adapter مخصوص pi و adapter مخصوص OpenCode را میزبانی کند.
خوانش تحریریه#
این خبر برای کسی که همین حالا یک ایجنت کدنویسی محلی روی Qwen3.8-27B اجرا میکند، یک چیز عوض میکند: بهجای روشنکردن thinking و پرداخت هزینه توکنی، یک adapter کوچک swap میکند و دقت مشابهی با مصرف حدود یکچهارم توکن میگیرد. اما مرزهایش روشن است: نتایج خودگزارشیشده، روی مجموعههای ارزیابی کوچک (۵۱ و ۸۶ تسک)، و فقط در harness pi اعتبار دارد. اگر از OpenCode یا هر محیط عاملی دیگری استفاده میکنید، این عدد بهدرد شما نمیخورد — هرچند روش harness-specific LoRA احتمالاً بهزودی برای آنها هم تکرار میشود. احتیاط اصلی: با p-value و فاصله اطمینان بزرگ (+۲۵.۵ ± ۱۴.۲) مواجهایم؛ یعنی بازه واقعی بهبود میتواند از حدود ۱۱ واحد تا ۴۰ واحد باشد. برای تصمیمگیری عملی، خودتان روی تسکهای واقعیتان تست کنید.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.