

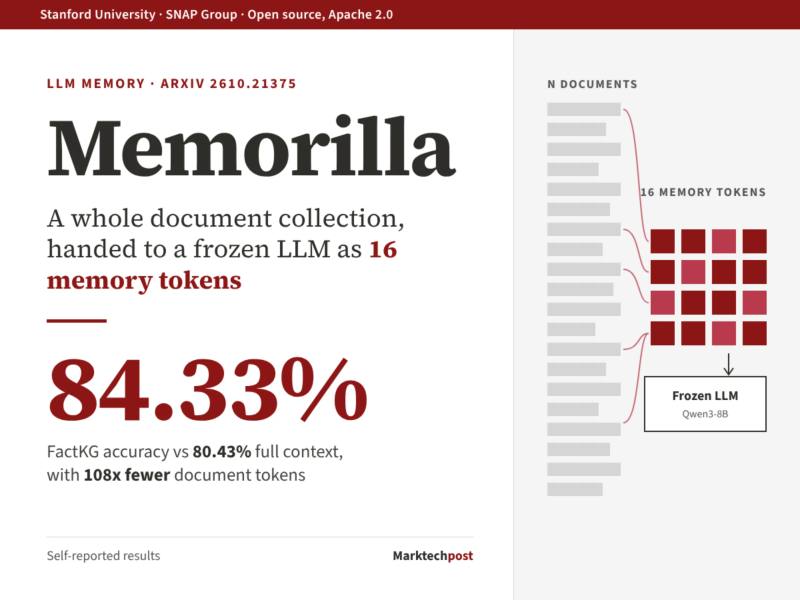


پژوهشگران گروه SNAP دانشگاه Stanford به سرپرستی Jure Leskovec، ماژول حافظهی نهفتهی Memorilla را بهصورت متنباز منتشر کردند. این ماژول ۱۹۴ میلیون پارامتری، مجموعهی کامل اسناد را به ۱۶ توکن تبدیل میکند و آنها را به ورودی یک مدل زبانی منجمد میفرستد. کد، دستورالعملهای آموزش و وزنها زیر مجوز Apache 2.0 در دسترساند.
ساختار و نحوهی کار#
Memorilla از دو بخش منجمد و یک بخش قابلآموزش تشکیل شده است. کدکننده Qwen3-Embedding-4B هر سند را یکبار ایمبد میکند و افزودن سند جدید، ایمبد اسناد قبلی را دوباره حساب نمیکند. سپس ۱۶ اسلات یادگرفته با ۲ لایهی cross-attention (۸ هدر) به سؤال و کل مجموعه توجه میکنند. خروجی در فضای ایمبدینگ ورودی Qwen3-8B تصویر میشود و پیش از سؤال قرار میگیرد. تنها ماژول حافظه آموزش میبیند؛ مدلهای زبانی دستنخورده میمانند.
آموزش در ۳ مرحله انجام میشود: مرحلهی اول حدود ۱.۹۸ میلیون نمونهی بازسازی پارافریز از Wikipedia، مرحلهی دوم حدود ۱.۳۴ میلیون نمونه از ۱۰ مجموعهدادهی پرسشوپاسخ و خلاصهسازی، و مرحلهی سوم fine-tune روی ۸ بنچمارک. کل پروسه حدود ۱۹ ساعت روی ۴ کارت H100 طول میکشد.
عملکرد و محدودیتها#
میانگین گزارششده روی ۸ بنچمارک ۴۹.۶۸ است — بالاترین عدد در مقایسه با xRAG (۴۱.۹۲)، LLMLingua-2 (۴۰.۷۵) و Mem0 (۳۸.۰۲). در ۵ بنچمارک از ۸، Memorilla بهترین نمره را گرفته است. اما در ۳ بنچمارک باخته است: در PubMedQA دقت ۵۹.۰۰٪ در مقابل ۶۹.۰۰٪ برای LLMLingua-2 ثبت شده — چون چکیدههای این مجموعه فقط ۳۲۴ توکناند و فشردهسازی سود چندانی ندارد.
در بنچمارک FactKG، دقت ۸۴.۳۳٪ در مقابل ۸۰.۴۳٪ روش متن کامل گزارش شده، با ۱۰۸ برابر توکن سند کمتر. در NarrativeQA، ۱۶ توکن جایگزین ۶۷,۳۸۵ توکن سند شدهاند — کاهش ۴,۲۱۲ برابری.
سرعت و منابع موردنیاز#
روی یک کارت H100، پاسخدهی در ۵۱۲ سند (حدود ۱۲۸K توکن) ۰.۷۴ ثانیه طول میکشد؛ متن کامل در همان حجم ۱۹.۹ ثانیه — ۲۷ برابر کندتر. ماژول حافظه خودش حدود ۲ میلیثانیه زمان میبرد. با فعالسازی حافظهی کششده روی یک کارت B200، زمان پاسخ در ۱ میلیون سند ۸.۱ میلیثانیه و در ۴ میلیون سند ۳۳ میلیثانیه است. این کش ۸۰ گیگابایت حافظه مصرف میکند.
برای اجرا به Linux، CUDA و Python 3.11 نیاز است. نصب اولیه حدود ۲۵ گیگابایت مدل دانلود میکند. نسخهی کمحجم (quantized) منتشر نشده است.
خوانش تحریریه#
Memorilla یک ایدهی مهندسیشده است، نه یک محصول آمادهی استفاده. برای کسی که همین حالا ایجنت یا سیستم RAG میسازد، این خبر دو پیام دارد. اول، اینکه ۱۶ توکن میتواند جایگزین دهها هزار توکن شود و همزمان دقت را بالا ببرد — یعنی سقف فشردهسازی هنوز پایینتر از آن است که بسیاری فرض میکنند. دوم، اینکه این ماژول فقط روی Qwen3-8B آموزش دیده و هیچ نسخهی کمحجم یا مدل دیگری ارائه نشده. اگر مدل شما Llama یا Mistral است، باید خودتان pipeline را بازسازی کنید. همچنین ضعف محسوس در PubMedQA نشان میدهد هر جا اسناد کوتاهاند و جزئیات ریز مهم است، فشردهسازی نهتنها کمک نمیکند بلکه ضرر میزند. این روش برای مجموعههای بزرگ و ناهمگن ساخته شده، نه برای چند صفحهی مرجع.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.