

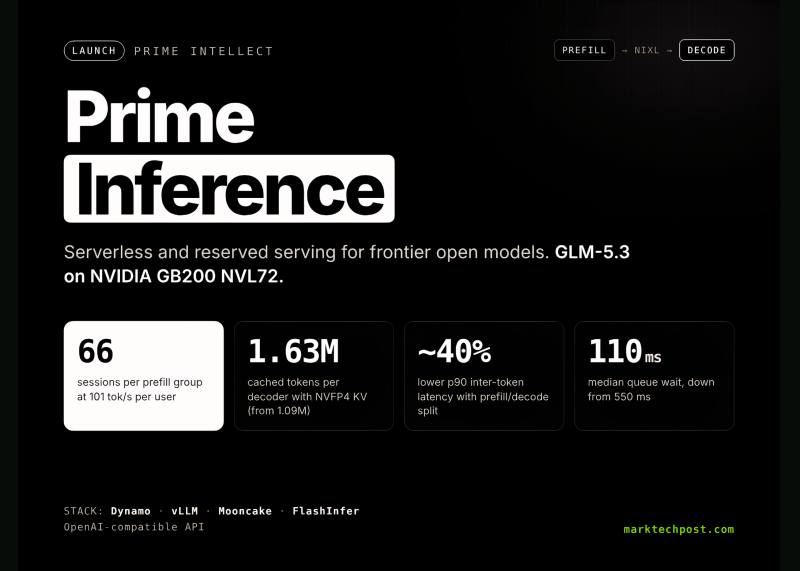


Prime Intellect پلتفرم سرو Prime Inference را برای مدلهای متنباز مرزی راهاندازی کرد. این سرویس در دو حالت «سرورلس» برای تقاضای متغیر و «ظرفیت رزروشده» برای بارهای پایدار روی GPUهای خود شرکت در چند مرکز داده اجرا میشود. پیش از انتشار عمومی، این زیرساخت روزانه نزدیک به یک تریلیون توکن را از محل rolloutهای RL، تولید داده مصنوعی، ارزیابیها و ایجنتهای کدنویسی بلندمدت پردازش کرده بود.
پشته سرو و سختافزار#
معماری سرو ترکیبی از NVIDIA Dynamo، vLLM، Mooncake و FlashInfer است که با همکاری Inferact و NVIDIA ساخته شده و اصلاحات آن بهصورت upstream به این پروژهها برگشتهاند. سختافزار فعلی NVIDIA Blackwell است و Vera Rubin در برنامه آینده ذکر شده. API با SDKهای OpenAI سازگار است.
GLM-5.3 روی GB200 NVL72 با نسبت ۱:۴ بین پیشتولید و رمزگشایی، ۶۶ نشست همزمان در هر گروه پیشتولید را با نرخ ۱۰۱ توکن بر ثانیه برای هر کاربر سرو میکند. فشردهسازی NVFP4 برای کش KV، هر ردیف کش MLA را از ۵۷۶ به ۳۵۲ بایت کاهش داد و ظرفیت توکنهای کششده در هر رمزگشاشنده از ۱٫۰۹ میلیون به ۱٫۶۳ میلیون رسید.
قابلیتهای کلیدی و محدودیتها#
- جداسازی prefill/decode با کاهش حدود ۴۰ درصدی تأخیر p90 بینتوکنی
- مسیریابی آگاه از کش با Dynamo و لایه دوم KV در DRAM میزبان (Mooncake)
- نرخ خطای نزدیک به صفر در فراخوانی ابزارها با استفاده از xgrammar برای ماسککردن توکنهای نامعتبر
- قیمتگذاری هر مدل هنوز بهطور کامل در مستندات منتشر نشده است
- Batch inference و استقرار یککلیک dedicated در roadmap قرار دارند
خوانش تحریریه#
مهمترین نکته این خبر، انتشار عدد عملکردی است، نه قیمت. رقبا (Together AI، Fireworks AI، Baseten) GLM-5.3 را با ۱٫۴۰ دلار ورودی و ۴٫۴۰ دلار خروجی به ازای هر میلیون توکن سرو میکنند، اما Prime Inference هنوز عددی منتشر نکرده. تا پیش از آن، تصمیمگیری برای تیمهایی که بهدنبال جایگزین هستند عملاً ممکن نیست.
آنچه برای سازندگان ایجنت و اتوماسیون قابل استفاده است، جزئیات معماری سرو است: جداسازی prefill/decode، فشردهسازی NVFP4، و ساختار BLHNC برای کاهش تأخیر انتقال. اینها الگوهایی هستند که هر کسی با vLLM یا Dynamo کار میکند میتواند در زیرساخت خود بازتولید کند. اما ادعای «۱۰۰ درصد uptime از زمان انتشار» با توجه به تازهبودن سرویس، هنوز معنای آماری چندانی ندارد.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.