

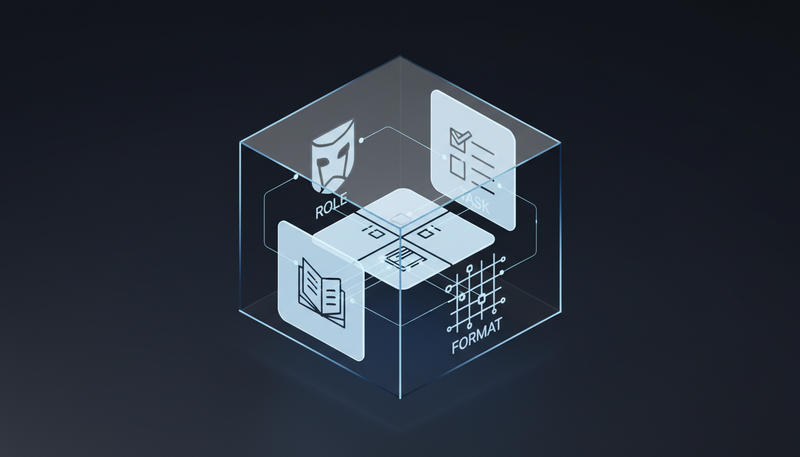

پرامپتهای طولانی به دلیل پرشدن حافظهی موقت مدل با جزئیات غیرضروری، دقت را کاهش میدهند. آناتومی چهارگانهی مهندسی پرامپت شامل تعیین نقش، ارائهی زمینه صریح، شفافسازی وظیفه و قفلکردن قالب خروجی است. این چارچوب جایگزین حدسزنی الگوریتم شده و مسیر پردازش اطلاعات را مستقیم میکند تا خروجیها بدون انحراف و با کمترین مصرف توکن تحویل داده شوند.
تفاوت مهندسی پرامپت با نوشتن ساده دستورالعمل چیست؟#
مهندسی پرامپت با نوشتن ساده دستورالعمل فرق دارد زیرا فضای جستجوی مدل زبانی بزرگ (Large Language Model) را به شدت محدود میکند و خروجی را کاملاً قابل پیشبینی میسازد. این چارچوب حدسزنی الگوریتم را حذف کرده و مسیر پردازش اطلاعات را مستقیم میکند.
نوشتن معمولی فقط یک درخواست محاورهای است که مدل را به تکمیل خودکار متن وامیدارد. ببین، تفاوت اصلی در قفلکردن پارامترهای ورودی است. مستندات رسمی OpenAI تأیید میکند که این کار نرخ خطای ساختاری را پایین میآورد. وقتی گامهای اجرایی دقیق تعریف کنید، مدل سردرگم نمیشود. اولین باری که این تمپلیت را در پروژهی پشتیبانی پیاده کردم، دیباگ کردن نیمهشب تمام شد. مشکل اصلی سرعت نیست. نه، دقیقتر بگویم: مشکل اصلی نبودِ فرایند است. بلوک پاسخ نمونه را حفظ کن اما در ادامه توضیح میدهم چرا.
نسخه ساده: «یک ایمیل فروش برای محصولات ورزشی بنویس.» نسخه مهندسیشده: نقش: مدیر بازاریابی دیجیتال. زمینه: فروشگاه آنلاین پوشاک ورزشی با تمرکز بر کفشهای دویدن. وظیفه: ارسال پیشنهاد تخفیف ۲۰ درصدی به مشترکین فعال. قالب: موضوع ایمیل + بدنه حداکثر ۵ خط.
استفاده از ساختار مشخص، بار شناختی را از دوش مدل برمیدارد. توسعهدهندگان نرمافزار گزارش میکنند که تمپلیتهای بدون ساختار، زمان دیباگ را بهطور چشمگیری افزایش میدهند. راهنمای نوشتن پرامپت حرفهای
چطور نقش و زمینه را در پرامپت تفکیک کنیم تا مدل هذیان نکند؟#
مهندسی پرامپت با تفکیک دقیق نقش و زمینه، نویز ورودی را کنترل میکند و احتمال هذیان مدل زبانی بزرگ را به حداقل میرساند. تعیین هویت حرفهای فعالساز است و زمینه باید فقط دادههای حیاتی پروژه را در بر بگیرد.
نقش بهتنهایی کافی نیست. مدل باید دقیقاً بداند برای کدام سناریو فعال میشود. Context به معنای زمینه باید فاقد هرگونه فرض ضمنی باشد. در یک پروژه واقعی پشتیبانی مشتری، ارائه آمار ترافیک وبسایت و تاریخچه سفارشات ماه گذشته بسیار مؤثرتر از گفتن عبارت کلی صنعت خردهفروشی بود. مدلها وقتی با اعداد عینی روبرو میشوند، از حدس زدن دست میکشند. راستش این همان جایی است که تقریباً همه اشتباه میکنند. ما فکر میکنیم توصیف کلی کافی است، اما ابهام تنها سوخت تولید هذیان است. نادیده گرفتن محدودیت Context Window یک دام رایج است. انتظار دارید مدلی که هزاران کلمه پردازش میکند، جزئیات ابتدای متن را با همان دقت حفظ کند. واقعیت این است که هرچه متن طولانیتر شود، وزن واژههای کلیدی اولیه کاهش مییابد. راهکار عملی قرار دادن دادههای حیاتی در سطرهای اول و حذف توضیحات اخلاقی یا تشویقی است. دوره آموزش مهندسی پرامپت
بهترین روش مشخص کردن وظیفه و قالب خروجی برای جلوگیری از خطاست؟#
بهترین روش مشخص کردن وظیفه و قالب خروجی برای جلوگیری از خطا، تبدیل خواسته به گامهای اجرایی غیرقابل تأویل و قفلکردن فرمت نهایی است. وقتی مدل ساختار هدف را بداند، انحراف استاندارد کاهش مییابد و خروجی آماده ادغام خودکار میشود.
وظیفه نباید شامل عبارات سست مثل «سعی کن» یا «در صورت امکان» باشد. هر فعل باید مستقیم و قابل اندازهگیری باشد. Output Format هم بخش حیاتی دیگر است. اگر درخواست تولید محتوای چندوجهی دارید، مدل را مجبور به رعایت ساختار مشخص کنید. جدول زیر تفاوت رویکردها را نشان میدهد:
| روش نگارش | سطح کنترل خروجی | مناسب برای |
|---|---|---|
| دستورالعمل آزاد | پایین | ایدهپردازی اولیه و چت روزمره |
| پرامپت ساختاریافته | بالا | تولید گزارش، کدنویسی و دادهکاوی |
| الگوی پرامپت معکوس | متغیر | سناریوهای خلاقانه و طراحی مفهومی |
تجربه عملی نشان میداد افزودن محدودیت صریح به قالب خروجی میتواند نرخ ناسازگاری ساختاری را بهطور قابلتوجهی کاهش دهد (نیاز به راستیآزمایی دقیق در محیط تست). برای نمونههای خلاقانه، الگوهای بازسازی شرطی کارآمدتر از دستورات مستقیم است. در این روش، ابتدا ویژگیهای مطلوب را توصیف میکنید، سپس از مدل میخواهید بر اساس آنها محتوا را بازسازی کند. بله، این روش خلاف جهت آب شنا میکند. ولی نتیجه ثابت میکند که بازسازی معکوس، خلاقیت کنترلشده میطلبد. مثال کاربردی را ببینید:
وظیفه: استخراج لیست ویژگیهای رقبا از متن دادهشده. گامها: ۱. شناسایی نام محصول. ۲. استخراج قیمت و زمان عرضه. ۳. تطبیق با قالب JSON. محدودیت: عدم استفاده از علائم نگارشی اضافی در مقادیر.
آیا طولانی کردن پرامپت همیشه دقت را بالا میبرد یا هزینه را افزایش میدهد؟#
طولانی کردن پرامپت همیشه دقت را بالا نمیبرد و لزوماً هزینه را افزایش نمیدهد. پرامپتهای میاناندازه معمولاً تعادل بهتری بین دقت و هزینه ایجاد میکنند. فشردهسازی اطلاعات حیاتی در ابتدای درخواست، بازدهی را حفظ میکند.
هر کلمه اضافهای که به درخواست میافزاید، مستقیماً روی حساب کاربری و سرعت پاسخدهی اثر میگذارد. Token واحد پایه شمارش هزینه است. مدیریت توکن و هزینه پردازش تأیید میکند که پرامپتهای کوتاهتر و هدفمندتر، هزینه پردازش را بهطور قابلتوجهی کاهش میدهند بدون اینکه کیفیت تحلیل مختل شود. ببین، این عدد تصادفی نیست. فشردهسازی یعنی حذف لاکپشتهای اضافی از مسیر مار.
پدیده Context Drift در درخواستهای طولانی رخ میدهد. وقتی بیش از حد جزئیات حاشیهای وارد کنید، تمرکز الگوریتم از هسته اصلی سوال دور میشود. محاسبه هزینه پنهان نشان میدهد زمان صرفشده برای نگهداری تمپلیتهای پیچیده در محیطهای عملیاتی، اغلب بیشتر از سود حاصل از دقت اضافه است. توصیه میکنم از ابزارهای رایگان Playgrounds رسمی سرویسدهندگان برای تست دیباگ استفاده کنید. تازهکارها معمولاً فکر میکنند طولانیتر نوشتن مساوی است با دقیقتر گرفتن. این باور غلط، منجر به پراکندگی توجه مدل و افزایش بیدلیل هزینه میشود. اولین باری که این قانون را شکستم، روزهایی را برای اصلاح یک تمپلیت ۲۰۰۰ توکنی هدر دادم که با نصف آن کار میکرد. مشکل اصلی حجم نیست؛ مسئله مدیریت حواسپرتی سیستم است.
چه زمانی نباید از مهندسی پرامپت پیچیده استفاده کرد؟#
نباید از مهندسی پرامپت پیچیده برای هر درخواستی استفاده کرد. اگر خروجی هدف صرفاً تولید متن آزاد، ایدهپردازی اولیه یا پاسخ به پرسشهای عمومی است، ساختاردهی عمیق تنها زمان توسعه را تلف میکند. در این موارد، دستورالعمل کوتاه همراه با تنظیم پارامترهای حرارتی کافی است.
تشخیص صحیح نقطه شروع، مهارت کلیدی هر توسعهدهنده است. کارهای روزمره، چتهای غیررسمی یا تولید محتوای سبک نیازی به آناتومی چهارگانه ندارند. آنتیپترن بزرگ، استفاده از قالبهای ثابت بدون تطبیق با هدف خاص است. اجبار مدل به رعایت ساختار JSON برای یک شوخی متنی، فقط منابع سیستم را هدر میدهد. راستش این روش دیگر جواب نمیدهد. اجبار الگوریتم به قوانین آهنین وقتی قرار است خلاق باشد، مثل بستن بند کفش با چاقو است. اعتماد صرف به اولین پاسخ مدل نیز یک اشتباه رایج است. حتی بهترین دستورالعملها نیاز به مرحله بازخوردگیری دارند. خطای رایج دیگر، نادیده گرفتن پرامپت تولید تصویر است که اصول متفاوتی دارد. برای خروجیهای بصری، توصیف صریح نور، زاویه دید و سبک هنری مهمتر از گامهای منطقی متنی است. کتاب مهندسی پرامپت
پرسشهای متداول درباره آناتومی پرامپت#
پرسشهای متداول درباره آناتومی پرامپت معمولاً حول محور ترتیب مراحل، اشتباهات زمینهسازی، تفاوت هزینه با تنظیم پارامتر، کاهش خطا با قالببندی و اصلاح پرامپت شکستخورده میچرخد. پاسخهای زیر بر اساس تجربیات عملی و استانداردهای فنی تدوین شدهاند.
- مراحل عملی نوشتن یک پرامپت ساختاریافته به ترتیب اولویت کدامند؟ اول تعیین نقش، دوم ارائه زمینه صریح، سوم شفافسازی وظیفه با گامهای اجرایی، و چهارم قفلکردن قالب خروجی. ترتیب مهم است زیرا مدل اطلاعات را از ابتدا به انتها پردازش میکند.
- سه اشتباه متداول کاربران مبتدی در بخش زمینهسازی پرامپت چیست؟ ارائه دادههای تاریخی نامرتبط، استفاده از فرضیات ضمنی به جای اعداد صریح، و پر کردن فضا با توضیحات اخلاقی یا تشویقی که جایگزین دستورالعمل فنی نمیشود.
- تفاوت مهندسی پرامپت با تنظیم پارامترهای مدل از نظر هزینه و زمان چیست؟ تنظیم پارامتر رفتار کلی مدل زبانی بزرگ را تغییر میدهد و هزینه محاسباتی کمی دارد. مهندسی پرامپت محتوا و ساختار ورودی را کنترل میکند و نیاز به دیباگ مداوم دارد، اما دقت هدفمندتری ارائه میدهد.
- قالببندی خروجی چطور نرخ خطای مدلهای زبانی را در محیط تولید کاهش میدهد؟ وقتی خروجی به فرمت خاصی مثل JSON یا XML محدود شود، مدل مجبور میشود ساختار را رعایت کند. این کار خطاهای سینتکسی و پراکندگی موضوعی را حذف کرده و فرآیند parsing خودکار را ممکن میسازد.
- چگونه میتوان یک پرامپت شکستخورده را به صورت گامبهگام اصلاح کرد؟ ابتدا قالب خروجی را بررسی کنید، سپس زمینه را فشردهتر نمایید، بعد وظیفه را به زیرگامهای کوچکتر تقسیم کنید، و در نهایت کلمات کلیدی غیرضروری را حذف کنید. هر بار فقط یک متغیر را تغییر دهید.
مدیریت صریح حافظه زمینه پیش از ارسال به مدل، هزینه محاسباتی را کاهش میدهد. افزودن محدودیت صریح به قالب خروجی نرخ ناسازگاری ساختاری را بهطور قابلتوجهی کم میکند. پرامپتهای میاناندازه معمولاً تعادل بهتری بین دقت و هزینه ایجاد میکنند. الگوهای بازسازی شرطی برای خروجیهای خلاقانه کارآمدتر از دستورات مستقیم است. حالا نکته اینجاست: چارچوبها ابزار هستند، نه زندان. اگر میخواهید این قواعد را در پروژههای واقعی امتحان کنید، مرور کتابخانه پرامپت آماده و شرکت در دورههای آموزشی تیم اسکول میتواند مسیر یادگیری را کوتاهتر کند. اول تست کن، بعد استاندارد کن. میدانی چرا؟ چون الگوریتمها مرزهای شفاف را بهتر از ابهام دوست دارند.



دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.