


مهندسی پرامپت، اگر درست تعریف شود، یک قرارداد سیستمی است — نه نوشتن جملهی زیبا، نه ترفند زبانی. ورودی مشخص، خروجی مشخص، رفتار در حالت خطا از پیش تعریفشده. این سه ضلع، پرامپت را از یک دستور زبانی به یک پروتکل قابلتست تبدیل میکنند. در ادامه، ساختار لایهای مستر پرامپت، تکنیکهای بنیادین و مرزهایی که این مهارت بهتنهایی کافی نیست را بررسی میکنیم.
مهندسی پرامپت چیست و چه چیزی نیست؟#
مهندسی پرامپت (Prompt Engineering) یعنی طراحی ورودی مدل زبانی بهگونهای که خروجی قابلاعتماد و قابلتکرار بدهد. این تعریف سه چیز نیست: نه صرفاً نوشتن دستور زیبا، نه جایگزین Context Engineering، نه جایگزین Fine-tuning. تعریف عملیاتیاش یک جملهست: تعریف قرارداد ورودی-خروجی بین کاربر و مدل، با ساختاری که بدون خواندن بقیهی متن قابل اجرا باشد.
این حوزه با انتشار GPT-3 در 2020 شکل گرفت و در 2022 با ChatGPT به جریان اصلی وارد شد. در 2023 بهعنوان شغل مستقل تبلیغ شد. در 2024-2025 جایگاهش بازتعریف شده: مهارتی مکمل در کنار طراحی سیستمهای هوش مصنوعی (AI Systems Design)، نه یک شغل مستقل. این تغییر موضع انتظارات بازار کار و نحوهی یادگیری را جابهجا میکند — و این جابهجایی هنوز در ذهن بسیاری از تازهواردها رخ نداده.
تفاوت مهندسی پرامپت و مهندسی زمینه (Context Engineering)#
مهندسی زمینه مدیریت آنچه مدل «میبیند» است: تاریخچهی گفتگو، اسناد RAG، خروجی ابزارها و محدودیتهای پنجرهی بافت (Context Window). مهندسی پرامپت اما طراحی همان دستوری است که مدل را وادار میکند با آن زمینه کار کند. در پروژههای واقعی، پرامپت خوب روی زمینهی بد شکست میخورد و زمینهی خوب با پرامپت بد هم نتیجهی ناپایدار میدهد.
تفاوت مهندسی پرامپت و فاینتیونینگ (Fine-tuning)#
فاینتیونینگ وزنهای مدل را تغییر میدهد؛ مهندسی پرامپت فقط ورودی را تغییر میدهد. هزینهی تغییر در فاینتیونینگ بسیار بالاتر است — نیاز به دادهی آموزش، GPU و زمان — اما پایداری خروجی را تضمین میکند. مهندسی پرامپت ارزان و سریع است ولی پایداریاش وابسته به نسخهی مدل باقی میماند.
| مفهوم | چه چیزی را کنترل میکند | هزینهی تغییر | چه زمانی مناسب است |
|---|---|---|---|
| مهندسی پرامپت | ورودی مدل | پایین | تست سریع، وظایف با حجم کم تا متوسط |
| مهندسی زمینه | اطلاعاتی که مدل در بافت میبیند | متوسط | نیاز به دانش خارجی یا تاریخچهی گفتگو |
| فاینتیونینگ | وزنهای مدل | بالا | رفتار پایدار روی صدها ورودی با خطای کم |
مستر پرامپت چیست و چه تفاوتی با پرامپت معمولی دارد؟#
مستر پرامپت (Master Prompt) یک پرامپت سیستمی کامل و چندلایه است که نقش، دستور، محدودیتها، نمونهها و فرمت خروجی را در یک قرارداد واحد تعریف میکند. پرامپت معمولی فقط بخشی از این ساختار را دارد — معمولاً یک جملهی دستورالعملی بدون محدودیت و بدون فرمت مشخص.
پرامپتهای تکجملهای در پروژههای تیمی شکست میخورند. نه بهخاطر ضعف زبانی، بلکه بهخاطر نبود مرز. وقتی چند نفر روی یک پرامپت کار میکنند، بدون ساختار لایهای نمیدانند کدام بخش را تغییر میدهند و کدام را نباید. مستر پرامپت این مرزها را مشخص میکند.
پرامپت سیستمی (System Prompt) و پرامپت کاربر (User Prompt): مرز و وظیفه#
پرامپت سیستمی قرارداد را تعریف میکند: مدل کیست، چه کاری انجام میدهد، چه محدودیتهایی دارد و خروجیاش چه شکلی است. پرامپت کاربر ورودی خاص را میفرستد. در مستر پرامپت، بخشهای نقش، دستور، محدودیت و فرمت خروجی در System Prompt قرار میگیرند و نمونهها و ورودی واقعی در User Prompt.
مثال عملی: تبدیل یک پرامپت معمولی به مستر پرامپت#
پرامپت معمولی: «یک خلاصه از این مقاله بنویس.»
مشکل: خروجی قابلمصرف نیست. طول مشخص نیست. مخاطب مشخص نیست. اگر ورودی خالی باشد مدل چه کند نامعلوم است.
تو یک خلاصهنویس فنی هستی که برای مهندسان نرمافزار مینویسی. وظیفه: مقالهی دادهشده را در حداکثر 150 کلمه خلاصه کن. محدودیتها: - از اصطلاحات بازاریابی استفاده نکن. - اگر مقاله کد دارد، کد را خلاصه نکن، فقط بگو چه کاری انجام میدهد. - اگر ورودی خالی یا کمتر از 100 کلمه است، بنویس: «محتوای کافی برای خلاصهنویسی وجود ندارد.» فرمت خروجی: - پاراگراف اول: موضوع اصلی (حداکثر 2 جمله) - پاراگراف دوم: 3 نکتهی کلیدی بهصورت لیست - پاراگراف سوم: مخاطب هدف (حداکثر 1 جمله)
ساختار لایهای مستر پرامپت: گامبهگام از صفر تا خروجی#
یک مستر پرامپت حرفهای از پنج لایه تشکیل میشود: نقش (Role)، دستور اصلی (Instruction)، محدودیتها (Constraints)، نمونهها (Examples) و فرمت خروجی (Output Format). حذف هر لایه هزینهی مشخصی روی دقت و پایداری خروجی دارد و این هزینه در پروژههای تیمی بهمرور انباشته میشود.
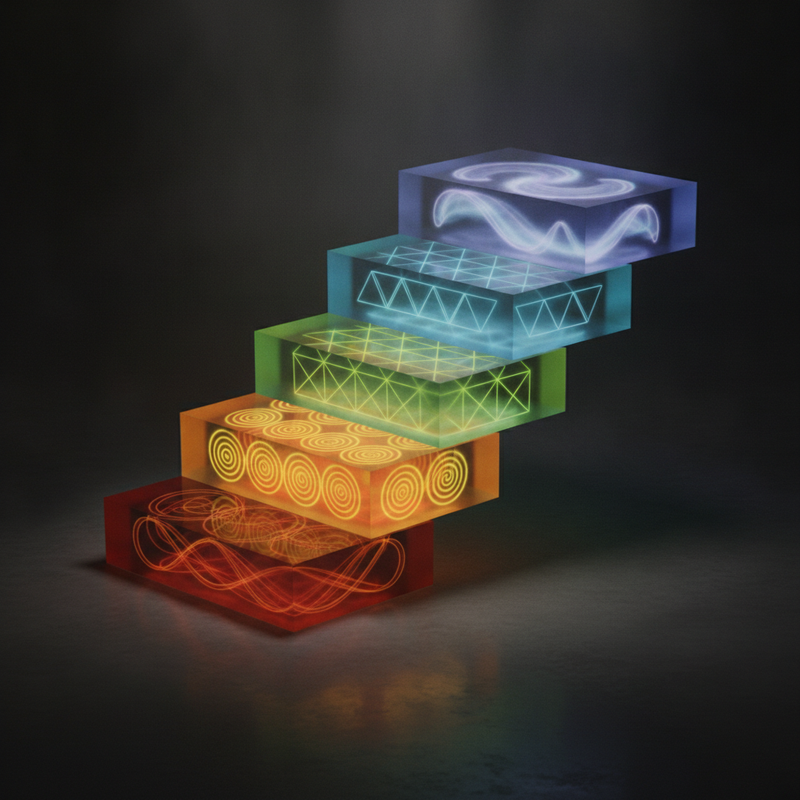
- لایهی نقش (Role): مدل را در یک هویت مشخص قرار میدهد. بدون این لایه، مدل بهجای متخصص، یک «دستیار عمومی» میماند و لحن و عمق خروجی نوسان دارد.
- لایهی دستور اصلی (Instruction): وظیفه را تعریف میکند. مهمترین نکته: لحن را از وظیفه جدا کنید. «خلاقانه بنویس» یک لحن است، نه وظیفه. وظیفه این است: «این داده را به این فرمت تبدیل کن.»
- لایهی محدودیت (Constraints): آنچه مدل نباید انجام دهد. این لایه در پروژههای واقعی بیشترین ارزش را دارد چون جلوی رفتارهای غیرقابلپیشبینی را میگیرد.
- لایهی نمونه (Examples): Few-shot در عمل. یک یا دو نمونهی ورودی-خروجی کامل، مدل را از تفسیر آزاد به سمت الگو هدایت میکند.
- لایهی فرمت خروجی (Output Format): ساختار قابلمصرف برای سیستم. این لایه مهمترین بخش برای تضمین دقت است چون خروجی مدل را به دادهی ساختاریافته تبدیل میکند.
حذف هر لایه چه هزینهای دارد؟#
حذف لایهی نقش: خروجی نوسان لحن دارد و در پروژههای چندمدلی رفتار غیرقابلپیشبینی میشود. حذف لایهی محدودیت: مدل کارهایی انجام میدهد که نخواستهاید — مثلاً در پرامپت خلاصهنویسی، شروع به نقد میکند. حذف لایهی فرمت خروجی: خروجی برای سیستمهای خودکار قابلمصرف نیست و نیاز به post-processing دارد.
الگوی تکرارشونده از پروژههای واقعی: پرامپتهایی که بدون لایهی فرمت خروجی، در تولید شکست خوردند#
در پروژههای اتوماسیون با n8n که پرامپت خروجی JSON مشخصی نداشت، مدل گاهی متن آزاد برمیگرداند و گاهی JSON ناقص. نتیجه: خطای parse در گرههای بعدی. الگوی تکرارشونده این است: هر پرامپتی که خروجیاش به سیستم بعدی میرود، باید لایهی فرمت خروجی داشته باشد — بدون استثنا. این الگو در ساخت Ai Agent با N8N در کامیونیتی N8N اسکول مرحلهبهمرحله تمرین میشود.
تکنیکهای بنیادین و کاربرد هر کدام#
تکنیکهای Few-shot، Zero-shot، Chain-of-Thought و Self-Consistency هرکدام برای نوع خاصی از وظیفه بهینهاند. استفادهی کورکورانه از هرکدام هزینه دارد — مثلاً Chain-of-Thought روی وظایف سادهی استخراجی، خروجی را کند و گاهی بدتر میکند.
Zero-shot و Few-shot: چه زمانی نمونه بدهیم و چه زمانی ندهیم#
Zero-shot وقتی مناسب است که وظیفه ذاتی مدل باشد — ترجمه، خلاصهنویسی، پاسخ به سؤال. Few-shot وقتی لازم است که فرمت خروجی غیراستاندارد باشد یا مدل باید یک الگوی تصمیمگیری خاص را یاد بگیرد. در پروژههای واقعی، Few-shot با 2 تا 3 نمونهی خوب، پایداری خروجی را محسوس بالا میبرد.
زنجیرهی اندیشه (Chain-of-Thought): مقالهی Wei و همکاران (NeurIPS 2022) و کاربرد عملی آن#
مقالهی Wei et al. در NeurIPS 2022 نشان داد که اضافهکردن «باید مرحلهبهمرحله فکر کنی» به پرامپت، دقت مدلها را در وظایف ریاضی و استدلال منطقی بالا میبرد. اما این تکنیک برای وظایف سادهی استخراجی یا دستهبندی، هزینهی توکنی اضافه دارد و گاهی مدل را به سمت استدلالهای اشتباه سوق میدهد. بهطور خاص، اگر وظیفهی شما یک تصمیم بله/خیر یا یک برچسب تککلمهای است، CoT فقط نویز اضافه میکند.
خودثباتی (Self-Consistency): مقالهی Wang و همکاران (ICLR 2023) و افزایش دقت با رأیگیری#
Wang et al. در ICLR 2023 روشی ارائه دادند که چند مسیر استدلال مختلف تولید میکند و از رأیگیری روی پاسخ نهایی استفاده مینماید. این روش دقت را در وظایف پیچیده بالا میبرد ولی هزینهی محاسباتی را چند برابر میکند. در پروژههای با حجم بالا، این هزینهی چندبرابری مانع استفادهی عملی میشود.
| تکنیک | مناسب چه وظیفهای | هزینهی محاسباتی | چه زمانی نباید استفاده شود |
|---|---|---|---|
| Zero-shot | وظایف ذاتی مدل | پایین | فرمت خروجی غیراستاندارد |
| Few-shot | الگوهای تصمیمگیری خاص | متوسط | محدودیت شدید توکن |
| Chain-of-Thought | استدلال ریاضی و منطقی | متوسط تا بالا | استخراج ساده، دستهبندی |
| Self-Consistency | وظایف پیچیده با دقت بالا | بالا (چند برابر) | حجم بالای درخواست |
چرا پرامپت من روی مدل دیگر کار نمیکند؟#
مدلهای مختلف الگوهای آموزشی متفاوتی دارند. پرامپتی که روی GPT-4o کار میکند ممکن است روی Claude یا Gemini خروجی متفاوت بدهد، چون وابستگی به الگوهای خاص آن مدل را نمیبینید. این مشکل در پروژههای تیمی که از چند مدل استفاده میکنند، هزینهی پنهان بزرگی است.
تفاوت رفتار GPT-4o، Claude و Gemini نسبت به یک پرامپت ثابت#
GPT-4o نسبت به ساختارهای سلسلهمراتبی (### و bullet) حساستر است. Claude به لحن پرامپت و توضیحات متنی واکنش نشان میدهد و اگر پرامپت محاورهای باشد، خودش هم محاورهای میشود و جدیت محدودیتها را کم میکند. Gemini نسبت به طول پرامپت حساستر است و پرامپتهای بلندتر را با دقت کمتری اجرا میکند. این تفاوتها الگوی تکرارشوندهای است که در تستهای چندمدلی بارها دیده شده.
کاراکترهای ساختاری (###، ```) جادو نیستند؛ فقط در مدلهای آموزشدیده روی آن مؤثرند#
بسیاری از پرامپتنویسان از ### برای بخشبندی استفاده میکنند چون در آموزش GPT رایج بوده. اما این کاراکترها ذاتاً معنایی ندارند. اگر مدل روی این الگو آموزش ندیده باشد، ### فقط یک کاراکتر اضافی است. راهحل: از ساختارهای زبانی روشن (عنوانهای صریح، شمارهگذاری، لیست) استفاده کنید که در همهی مدلها خوانا هستند.
راهحل عملی: تست چندمدلی و نگارش پرامپت مدلمحور (model-agnostic). پرامپت را طوری بنویسید که وابستگی به الگوی خاص یک مدل نداشته باشد.
تو یک تحلیلگر داده هستی. ورودی: یک جدول CSV از فروش ماهانه. وظیفه: 1. سه محصول با بالاترین رشد درصدی را شناسایی کن. 2. برای هرکدام یک جمله توضیح بنویس. محدودیتها: - اگر جدول کمتر از 3 ردیف دارد، بگو «دادهی کافی نیست». - از فرمت جدولی استفاده نکن. خروجی: فقط سه خط. هر خط: [نام محصول] | [درصد رشد] | [توضیح یکجملهای]
این پرامپت ساختار زبانی روشن دارد و به کاراکترهای خاص مدل وابسته نیست. روی GPT، Claude و Gemini باید خروجی مشابه بدهد.
اشتباهات رایج و هزینههای واقعی آنها#
مهمترین اشتباهات مهندسی پرامپت باورهای نادرستی هستند که در 2023 رایج شدند و در 2024-2025 هزینهی واقعی دارند: پرامپت بلندتر بهتر نیست، Chain-of-Thought همیشه کمک نمیکند، و یک پرامپت روی همه مدلها کار نمیکند.
«پرامپت بلندتر بهتر است» — چرا پرامپت بدون ساختار، دقت را کاهش میدهد#
پرامپت 500 کلمهای بدون ساختار لایهای، مدل را در انبوه دستورات گم میکند. مدلها نسبت به ابتدای و انتهای پرامپت حساسترند (مشکل Lost in the Middle). پرامپت کوتاه با ساختار روشن، از پرامپت بلند بدون ساختار بهتر عمل میکند.
«همیشه از Chain-of-Thought استفاده کنید» — هزینهی پنهان روی وظایف ساده#
برای وظیفهی «این ایمیل را به سه دسته اسپم، عادی و فوری تقسیم کن»، CoT فقط توکن اضافه مصرف میکند و گاهی مدل را به سمت استدلالهای بیربط میبرد. CoT ابزار دقیقسازی است، نه پیشفرض.
«مهندسی پرامپت یک شغل مستقل است» — بازتعریف جایگاه آن در 2024-2025#
در 2023 عنوان شغلی «Prompt Engineer» در آگهیها ظاهر شد. در 2024-2025 این عنوان بهعنوان مهارت مکمل در کنار AI Systems Design تعریف میشود. کسی که فقط پرامپت مینویسد و درک سیستمی ندارد، در پروژههای واقعی محدود میماند.
اشتباه پرهزینهی لحن: استفادهی بیشازحد محاورهای در System Prompt و کاهش جدیت مدل در رعایت محدودیتها. وقتی System Prompt محاورهای باشد، مدل هم محاورهای میشود و محدودیتها را شلتر اجرا میکند. راهحل: تفکیک لحن در User Prompt از لحن رسمی و ساختاریافته در System Prompt.
چه زمانی پرامپت کافی نیست؟#
وقتی نیاز به رفتار پایدار روی صدها ورودی مختلف دارید و خطای چنددرصدی هزینهزا است، مهندسی پرامپت بهتنهایی کافی نیست و باید از Fine-tuning یا RAG استفاده کنید. مرز اصلی: پرامپت تضمین نمیدهد، فقط احتمال را بالا میبرد.
مرز مهندسی پرامپت: چه زمانی باید به Fine-tuning فکر کرد#
اگر پرامپت شما روی 10 ورودی تست خوب کار میکند ولی روی 100 ورودی واقعی، نوسان خروجی دارید، پرامپت بهتنهایی کافی نیست. در این مرحله Fine-tuning یا حداقل Context Engineering با RAG لازم میشود. نشانهی عملی: وقتی خطای پرامپت روی دادهی جدید غیرقابلتوضیح است و با تغییر لایهها حل نمیشود.
نقش Context Engineering در کنار مهندسی پرامپت: مدیریت RAG، تاریخچه گفتگو و ابزارها#
Context Engineering مدیریت آنچه مدل در بافت میبیند است. اگر پرامپت شما خوب است ولی خروجی ناپایدار دارد، احتمالاً مشکل در زمینه است — مثلاً RAG اسناد نامربوط وارد بافت میکند یا تاریخچهی گفتگو از پنجرهی بافت خارج شده. این دو حوزه مکملاند، نه جایگزین.
محدودیتهای ذاتی مهندسی پرامپت: عدم تضمین پایداری، وابستگی به نسخهی مدل، و هزینهی تست. DSPy (Khattab et al., 2023) بهینهسازی خودکار پرامپت را هدف گرفته و در پروژههای با حجم بالا مفید است، اما درک اصول مهندسی پرامپت برای تنظیم و دیباگ کردن خروجی DSPy همچنان ضروری است.
ابزارها و مدیریت نسخهبندی مستر پرامپت در تیمها#
مستر پرامپتها باید مثل کد نسخهبندی شوند؛ بدون این کار، دیباگ کردن تغییرات رفتار مدل غیرممکن است. ابزارهایی مثل LangSmith، Promptfoo و DSPy این فرآیند را خودکارسازی میکنند.
چرا نسخهبندی پرامپت ضروری است: الگوی تکرارشونده از پروژههای تیمی#
در پروژههایی که پرامپت در Git ذخیره نمیشود، وقتی رفتار مدل تغییر میکند، تیم نمیداند کدام تغییر پرامپت باعث آن شده. الگوی تکرارشونده: پرامپت را در فایل جداگانه ذخیره کنید، changelog بنویسید و هر تغییر را با یک آزمون خودکار تأیید کنید.
ابزارهای ارزیابی و تست: LangSmith، Promptfoo، DSPy#
LangSmith برای tracing و دیباگ زنجیرههای پیچیده مناسب است. Promptfoo ابزار متنباز (open-source) برای تست و ارزیابی پرامپت است و بدون هزینه قابل استفاده میباشد — برای مقایسهی چند پرامپت روی چند مدل بهصورت همزمان طراحی شده. DSPy برای بهینهسازی خودکار پرامپت در حجم بالا مناسب است.
| ابزار | کاربرد اصلی | هزینه | مناسب چه نوع تیمی |
|---|---|---|---|
| LangSmith | Tracing و دیباگ | پولی | تیمهایی با زنجیرههای پیچیده |
| Promptfoo | تست و مقایسهی پرامپت | رایگان | تیمهای کوچک و مستقل |
| DSPy | بهینهسازی خودکار پرامپت | رایگان | پروژههای با حجم بالای درخواست |
فرآیند تست و ارزیابی پرامپت: از نوشتن تا تأیید در تولید#
فرآیند استاندارد: نوشتن پرامپت → آزمون روی 10 ورودی نمونه → مقایسه با baseline → ثبت در changelog → انتشار. بدون baseline، نمیدانید پرامپت جدید بهتر است یا بدتر. بدون changelog، نمیدانید چه چیزی تغییر کرده.
مدیریت مستر پرامپت در تیمها: ownership مشخص برای هر پرامپت، review قبل از تغییر، و changelog خودکار. پرامپت بدون owner در تیم، پرامپتی است که همه فکر میکنند کسی دیگری آن را مدیریت میکند.
مهندسی پرامپت مهارتی است که با تمرین هدفمند و آزمونوخطای ساختاریافته رشد میکند. اگر میخواهید این مهارت را در کنار ساخت ایجنتهای عملی تمرین کنید، آموزش جامع Claude و ابزارهای مشابه در کامیونیتی اسکول، کار با مدلهای زبانی را از پرامپتنویسی تا ساخت محصول پوشش میدهد.




دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.