

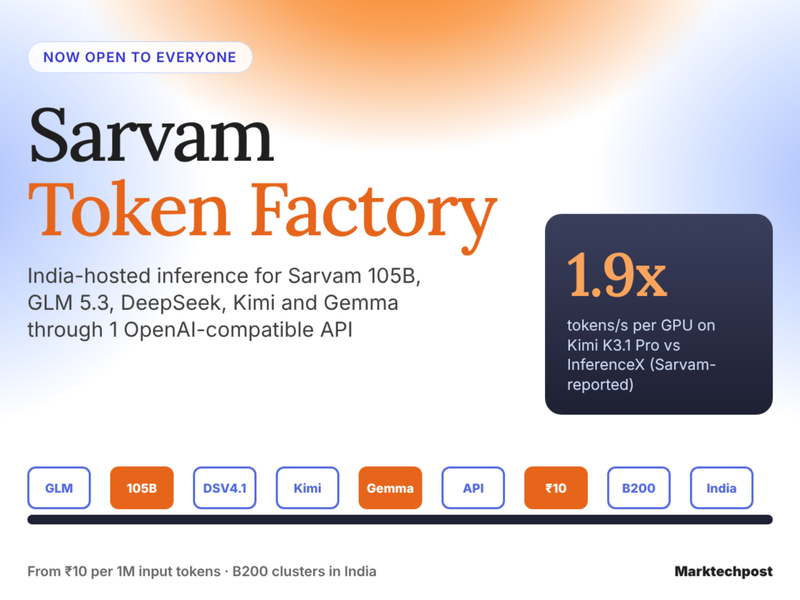


سروام، شرکت هندی هوش مصنوعی، پلتفرم استنتاج Sarvam Token Factory را برای عموم باز کرد. این پلتفرم ۸ مدل را از خوشههای NVIDIA B200 مستقر در هند سرو میکند و همه از طریق یک API سازگار با OpenAI در دسترساند.
مدلها و قیمتها#
در فهرست راهاندازی، Sarvam 105B (۱۰۵ میلیارد پارامتر کل، ۹ میلیارد فعال، ۱۲۸K طول زمینه)، GLM 5.3، GLM 5.3 Flash، DeepSeek V4.1 Flash 1017، DeepSeek V4 Pro، Kimi K3، Kimi K3.1 Pro و Gemma 4 31B قرار دارند. مدلها به دو گروه تقسیم شدهاند: مدلهای pay-as-you-go روی endpointهای اشتراکی اجرا میشوند و مدلهایی مثل DeepSeek V4 Pro و Kimi K3.1 Pro نیاز به Provisioned Throughput دارند که باید برای هر سازمان فعال شود.
- Sarvam 105B: ۱۰ روپیه ورودی / ۲۵ روپیه خروجی در هر میلیون توکن (قیمت مقدماتی)
- GLM 5.3 Flash: ۱۳.۵ روپیه ورودی / ۴۵ روپیه خروجی
- Gemma 4 31B: ۳۵ روپیه ورودی / ۹۰ روپیه خروجی
- DeepSeek V4.1 Flash 1017: ۱۴ روپیه ورودی / ۵۵ روپیه خروجی (قیمت مقدماتی)
قیمتهای مقدماتی تا پایان ۲۰۲۶ معتبرند. نرخ مدلهای provisioned در مستندات منتشر نشده است.
معماری و عملکرد#
استک سه لایه دارد: control plane با router آگاه به کش، inference engine با استخرهای GPU جداگانه برای prefill و decode، و کش روی حافظه GPU بهعلاوه یک G3 store مشترک ساختهشده روی Mooncake. روی زیرساخت vLLM، SGLang، Dynamo و FlashInfer ساخته شده و یک orchestrator agent آزمایشها را پیشنهاد میدهد که مهندس تأیید میکند.
سروام گزارش میدهد که DeepSeek V4.1 Flash روزانه بیش از ۴۵۰ میلیارد توکن سرو میکند و ۹۵.۷٪ توکنهای prompt از کش پاسخ داده میشوند. برای Sarvam 105B، وزنهای MXFP8 و speculative decoding بازده خروجی را حدود ۲.۲ برابر افزایش داد و هر replica از ۲ عدد B200 به ۱ عدد کاهش یافت.
مقایسه با رقبا#
طبق اعداد خودگزارششده سروام، Kimi K3.1 Pro روی ۱۶ عدد B200 با ۶,۱۷۷ توکن در ثانیه در هر GPU در برابر ۳,۲۱۳ برای InferenceX (۱.۹ برابر) عمل میکند. اما در DeepSeek V4.1 Flash با prompt دههزار تویی، Together AI با ۰.۷۱ ثانیه اولین توکن در برابر ۰.۹۰ ثانیه سروام و ۲۷۸ توکن در ثانیه در برابر ۱۳۰، همچنان سریعتر است.
خوانش تحریریه#
برای تیمهای هندی که ایجنت و اتوماسیون میسازند، مزیت اصلی حذف تأخیر عبور ترافیک از ابرهای خارج کشور است و این واقعی است. اما سه نکته باید در نظر باشد: اول، همه اعداد بنچمارک خودگزارششدهاند و سروام رقیب اصلیاش در سرعت استریم DeepSeek را نمیبَرَد. دوم، مدلهای provisioned هنوز نرخشان منتشر نشده، یعنی هزینه واقعی برای بارهای سنگین مشخص نیست. سوم، اگر تیم شما هند نیست، مزیت تأخیر عملاً بیمعناست و قیمتهای مقدماتی هم تا پایان ۲۰۲۶ اعتبار دارند — بعد از آن، مقرونبهصرفه بودن در برابر Together یا Fireworks باید دوباره سنجیده شود.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.