

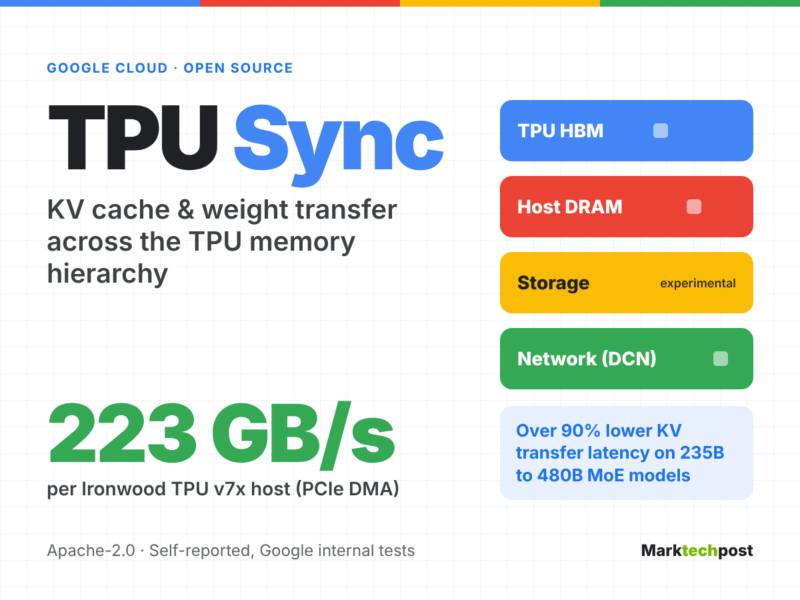
گوگل Cloud کتابخانهی متنباز C++ به نام TPU Sync را با مجوز Apache-2.0 منتشر کرده است. این کتابخانه انتقال کش KV و وزن مدل را روی Cloud TPU مدیریت میکند و HBM، DRAM میزبان، ذخیرهسازی مشترک و شبکهی دیتاسنتر را بهعنوان یک سلسلهمراتب حافظهی واحد در نظر میگیرد.
عملکرد در بنچمارکهای داخلی#
گوگل در ژوئیه ۲۰۲۶ تستهای داخلی را روی TPU v7x (Ironwood) با پیکربندی 2x2x1، PCIe Gen5 و NICهای ۲۰۰ Gbps انجام داد. در سرویسدهی تفکیکشدهی Prefill/Decode، تأخیر میانی انتقال کش KV برای مدل Qwen3 235B از چند ثانیه به حدود ۲۳۰ میلیثانیه رسید. میانگین TTFT در همزمانی پایین برای مدل ۲۳۵B حدود ۶۰ درصد و برای ۴۸۰B حدود ۹۰ درصد کاهش یافت. تولید توکن در دورههای اوج ترافیک ۳۰ تا ۷۰ درصد افزایش پیدا کرد.
در سناریوی کش پیشوندی، ظرفیت مؤثر کش با یک مرتبهی بزرگی افزایش یافت و TTFT در بار کاری با ۶۴K context تا ۹۰ درصد کاهش پیدا کرد. P99 تأخیر بینتوکنی ۳۰ درصد افت کرد.
معماری و یکپارچگی#
TPU Sync با PyTorch از طریق TorchTPU و با JAX بهصورت بومی یکپارچه میشود. در vLLM-TorchTPU نقش KV connector را بر عهده دارد و در SGLang-TorchTPU بهعنوان بکاند انتقال P/D و کش سلسلهمراتبی عمل میکند. روی GKE، llm-d 1.0 از آن برای مسیریابی کش پیشوندی و اسپیل به Managed Lustre استفاده میکند. Inferact و RadixArk در توسعهی یکپارچگیهای vLLM و SGLang مشارکت داشتهاند. گوگل اعلام کرده Meta و Wayfair در حال ارزیابی این معماری هستند.
پهنای باند PCIe بهازای هر میزبان Ironwood تا ۲۲۳ GB/s گزارش شده که از سقف ۲۵۶ GB/s نسل پنجم PCIe فاصله دارد. DCN روی یک NIC حدود ۱۹۲ Gbps و روی دو NIC حدود ۳۵۰ Gbps به دست میآید.
محدودیتها#
README صراحتاً میگوید این کتابخانه هنوز برای استفادهی عمومی توصیه نمیشود. هیچ عددی برای RL منتشر نشده و تمام اعداد عملکرد خودگزارشی و آزمایشگاهیاند. ذخیرهسازی POSIX هنوز آزمایشی است.
خوانش تحریریه#
TPU Sync گرهی گلوگاه انتقال را باز میکند، نه گرهی محاسبات را. اگر روی TPU سرویس میدهید و مدل MoE بزرگ دارید، کاهش تأخیر انتقال کش میتواند TTFT را واقعاً کوتاه کند. اما «هنوز توصیه نمیشود» در README یک هشدار جدی است: تمام اعداد در محیط آزمایشی و با نسخههای مشخصی از JAX 0.10.2 و tpu-inference v0.24.0 به دست آمدهاند. برای کسی که امروز ایجنت میسازد و روی GPU کار میکند، این خبر عملاً چیزی عوض نمیکند — مگر اینکه در اکوسیستم TPU گوگل باشید و بخواهید سرویسدهی تفکیکشده را روی TPU v7x امتحان کنید.
منبع: MarkTechPost



دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.