

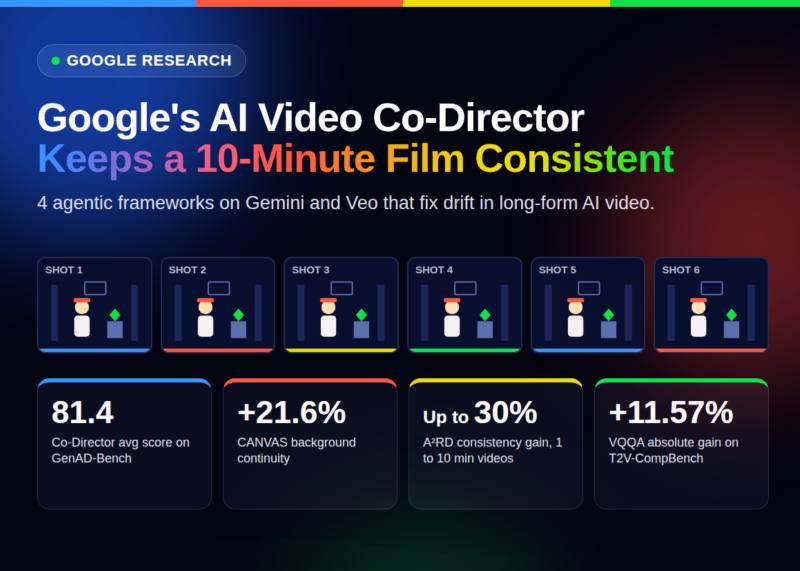


پژوهش گوگل مجموعهای از ۴ فریمورک عاملمحور را معرفی کرده که ویدئوهای کوتاه تولیدشده توسط مدلهای diffusion را به روایتهای چنددقیقهای منسجم تبدیل میکنند. این سیستم بهعنوان لایهی ارکستراسیون روی Gemini و Veo اجرا میشود و مدلمحور نیست؛ یعنی میتواند موتورهای تولید ویدئوی دیگری را هم هدایت کند. خروجیها واترمارک SynthID را از مدلهای پایه ارث میبرند.
مشکل اصلی: drift هویت و خطاهای آبشاری#
تولید کلیپهای باکیفیت با مدلهای diffusion چند ثانیه طول میکشد، اما چسباندن آنها به یک روایت منسجم مشکلساز است. بیشتر خطلولههای عاملمحور فعلی ماژولها را با پرامپتهای مستقل و دستنویس به هم وصل میکنند که دو نوع خرابی ایجاد میکند: semantic drift (تغییر لباس، چهره یا صحنه بین شاتها) و cascading failures (یک دارایی خراب در ابتدای خط، تمام شاتهای بعدی را آلوده میکند). تیم گوگل این را مسئلهی credit assignment مینامد: ردیابی اینکه کدام پرامپت باعث خرابی شده، دشوار است.
۴ فریمورک و عملکرد هرکدام#
Co-Director (پذیرفتهشده در COLM 2026): یک Orchestrator Agent پیکربندی را از میان Creative Strategy، Narrative Mode و Aesthetic Archetype انتخاب میکند. یک MLLM Judge خروجی را امتیاز میدهد و پاداش به bandit بازمیفرستد. نمرهی ۸۱/۴ در GenAD-Bench و ۳/۹۶ از ۵ در ارزیابی انسانی.
CANVAS (پذیرفتهشده در EMNLP 2026): حافظهی بصری پایدار برای کاراکترها، مکانها و وضعیت اشیاء. در آزمایش سرقت موزه، AutoStudio کلاه دزد را گم کرد و Gemini-3.1-Pro سنگ جواهر را تغییر داد؛ CANVAS هر دو را حفظ کرد. بهبود ۲۱/۶ درصدی در ثبات پسزمینه، ۹/۶ درصدی در ثبات کاراکتر و ۷/۶ درصدی در ثبات اشیاء.
A²RD (Agentic Autoregressive Diffusion): معماری بدون آموزش. هر سگمنت حلقهی Retrieve، Synthesize، Refine، Update را روی حافظهی چندوجهی ویدئو اجرا میکند. یک فیلم ۱۰ دقیقهای پیوسته با این روش تولید شده. بهبود تا ۳۰ درصدی در ثبات و ۲۰ درصدی در انسجام روایی.
VQQA (Video Quality Question Answering): برای هر پرامپت سؤالات بصری تولید میکند و نقدهای VLM بهعنوان «گرادیان معنایی» متن پرامپت را بازنویسی میکنند. دسترسی به internals مدل لازم نیست. بهبود ۱۱/۵۷ درصدی در T2V-CompBench و ۸/۴۳ درصدی در VBench2.
بچمارکها و دسترسی#
گوگل ۳ بچمارک جدید ساخته: GenAD-Bench (۴۰۰ سناریوی تبلیغاتی، ۲۰۰ محصول خیالی، ۵۰ برند)، HardContinuityBench (تکرار صحنه و تغییر وضعیت اشیاء) و LVBench-C (۱۲۰ سناریو که داراییهای کلیدی حداقل ۱۰ سگمنت غایباند). رقبای مقایسهشده: Veo 3.1، Kling 3.0 Omni، Wan 2.6 و MovieAgent.
کد Co-Director و A²RD روی GitHub منتشر شده. کد CANVAS بهزودی میآید. کل خطلوله محصول گوگل نیست.
خوانش تحریریه#
این خبر بیشتر یک گزارش پژوهشی است تا یک محصول قابلاستفاده. برای کسی که همین حالا با ابزارهای موجود ایجنت و اتوماسیون میسازد، دو چیز مشخص عوض میشود: اول، مشکل drift هویت دیگر فقط «مشکل شناختهشده» نیست و راهحلهای قابلاندازهگیری دارد (CANVAS و A²RD). دوم، رویکرد «بدون fine-tuning، فقط ارکستراسیون روی مدلهای موجود» یک مسیر عملی برای تیمهای کوچکتر است. اما این خبر هنوز یک خطلولهی آمادهی مصرفکننده نیست. کد بخشی از فریمورکها منتشر شده، بخشی نه، و هیچکدام بهعنوان محصول Google Cloud یا Vertex AI در دسترس نیست. اگر روی ویدئوی چندشات کار میکنید، ارزش دارد A²RD و VQQA را روی GitHub بررسی کنید؛ اما انتظار یک API آماده نداشته باشید.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.