

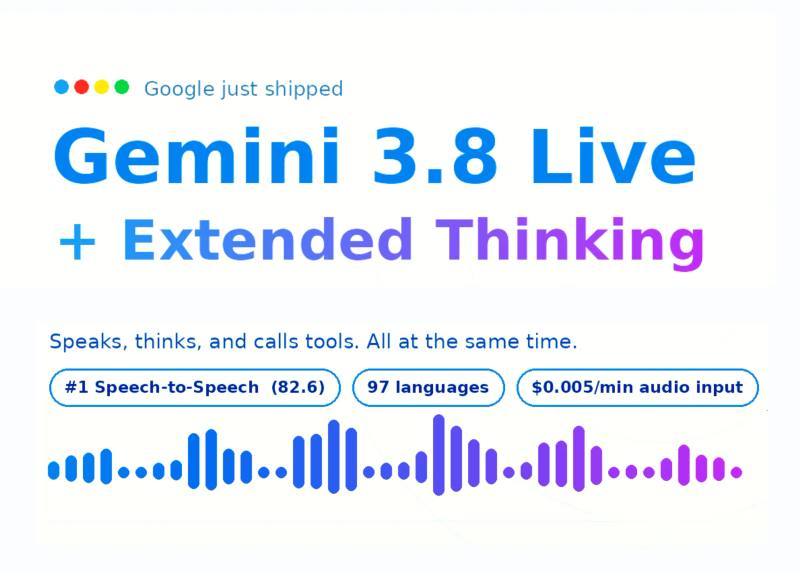
گوگل دو مدل جدید به نامهای Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking را بهعنوان پیشرفتهترین مدلهای گفتگوی زنده خود معرفی کرد. این مدلها بهصورت بومی گفتار-به-گفتار طراحی شدهاند و برای ایجنتهای صوتی زمانواقعی بهینهسازی شدهاند تا بتوانند همزمان استدلال کنند و ابزارها را اجرا نمایند، بدون آنکه جریان مکالمه قطع شود.
این دو مدل از طریق Gemini Live API و Google AI Studio در دسترس هستند. توجه داشته باشید که این مدلها بهصورت میزبانیشده ارائه میشوند و امکان میزبانی محلی (Self-hosted) وجود ندارد.
تفاوت دو مدل#
Gemini 3.8 Live برای مقیاسپذیری و کارایی هزینه طراحی شده و ترکیبی از هوش مکالمهای و درک بصری را ارائه میدهد. در مقابل، Gemini 3.8 Live Extended Thinking برای وظایف پیچیدهتر ساخته شده و قابلیت استدلال چندمرحلهای همزمان با گفتار را اضافه میکند.
نتایج بنچمارکها#
مدل Extended Thinking در رتبهبندی Artificial Analysis’s Speech to Speech Quality Index با امتیاز 82.6 در جایگاه اول قرار گرفته است. این مدل در تکمیل وظایف ایجنتمحور نیز عملکرد قابلتوجهی داشته و امتیاز 68.6 درصد در معیار τ-Voice و 35.1 درصد در معیار Sierra’s τ-Voice-banking را کسب کرده است. همچنین در معیار Big Bench Audio امتیاز 97.7 درصد را ثبت کرده است.
قابلیتهای کلیدی برای توسعهدهندگان#
- فراخوانی ناهمگام توابع: مدل میتواند فراخوانیهای API و ابزارها را در پسزمینه اجرا کند، در حالی که پاسخ صوتی همچنان برای کاربر در حال جریان است.
- زمینه بصری: پردازش ورودیهای تصویری زنده در زمان نزدیک به واقع، به ایجنتها امکان میدهد هم آنچه کاربر میگوید و هم آنچه میبیند را درک کنند.
- دقت عددی و حروفی: تجزیه دقیق کدهای تأیید، شمارههای پیگیری و دادههای فنی که اغلب در سیستمهای صوتی با خطا همراه است.
- پشتیبانی چندزبانه: تشخیص خودکار و انتقال بین 97 زبان در حین مکالمه با حفظ لهجه.
- بهروزرسانیهای تدریجی محتوا: ترکیب صوت زنده با دادههای ساختاریافته برای ارائه پاسخهای آگاه به زمینه.
قیمتگذاری#
هر دو مدل با نرخ 0.005 دلار برای هر دقیقه ورودی صوتی و 0.018 دلار برای هر دقیقه خروجی صوتی قیمتگذاری شدهاند. این برآورد بر اساس هزینه 3 دلار برای هر یک میلیون توکن ورودی و 12 دلار برای هر یک میلیون توکن خروجی محاسبه شده است.
تحلیل: چه چیزی تغییر میکند؟#
انتشار این مدلها بهویژه برای توسعهدهندگانی که ایجنتهای صوتی میسازند، گامی به سمت سادهسازی معماری سیستم است. در گذشته، ساخت یک ایجنت صوتی اغلب نیازمند زنجیرهای از مدلهای مجزا (ASR، LLM و TTS) بود که مدیریت تأخیر و هماهنگی آنها دشوار بود. قابلیت «فراخوانی ناهمگام توابع» و «استدلال همزمان با گفتار» در مدل Extended Thinking، این امکان را میدهد که ایجنت بدون قطع مکالمه، کارهای طولانیمدت را در پسزمینه انجام دهد. با این حال، عدم امکان میزبانی محلی و وابستگی به API گوگل، برای پروژههایی که نیاز به کنترل کامل روی دادهها و زیرساخت دارند، همچنان یک محدودیت جدی باقی میماند.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.