

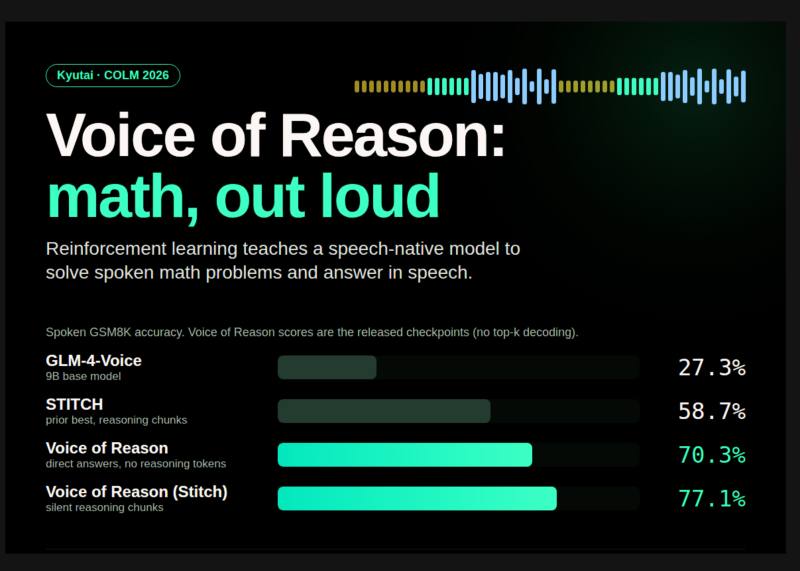
کیوتای (Kyutai) دو مدل گفتار-به-گفتار با وزنهای متنباز تحت عنوان Voice of Reason منتشر کرد که برای حل مسائل ریاضی بهصورت گفتاری طراحی شدهاند. هر دو مدل از پایهی GLM-4-Voice-9B توسعه یافته و با ترکیب تنظیم دقیق نظارتشده (SFT) و یادگیری تقویتی (RL) آموزش دیدهاند. نکتهی کلیدی این است که در این معماری هیچ مرحلهی تبدیل گفتار به متن (Transcription) و هیچ مدل زبانی متنی جداگانهای در چرخهی پردازش وجود ندارد. دقت این مدلها در حل مسائل گفتاری GSM8K از ۲۷.۳ درصد در مدل پایه به ۷۷.۱ درصد رسیده است.
چرا مدلهای گفتاری در ریاضی ضعف دارند؟#
خطوط لولهی آبشاری (Cascaded) که گفتار را به متن، متن را به پاسخ و پاسخ را دوباره به گفتار تبدیل میکنند، همچنان در استدلال برتری دارند؛ اما هر مرحله تأخیر ایجاد میکند و نشانههای فرازبانی (Paralinguistic) مانند لحن از بین میرود. مدلهای بومیِ گفتار باید در بازههای منظم خروجی صوتی تولید کنند تا تعاملی باقی بمانند، که این محدودیت تعداد توکنهای پنهان استدلال را کاهش میدهد. روش STITCH پیشتر دقت را تا ۵۸.۷ درصد بالا برده بود، اما کیوتای ادعا میکند که کار آنها نخستین کاربرد یادگیری تقویتی برای استدلال ریاضی در مدلهای بومی گفتار است.
جزئیات آموزش#
مدل GLM-4-Voice خروجی خود را بهصورت متناوب تولید میکند: ۱۳ توکن متنی و سپس ۲۶ توکن صوتی. در مرحلهی اول SFT، از ۱۵۰,۶۱۶ مسئلهی Orca-Math استفاده شد که توسط Qwen3-235B بازنویسی و سپس با سیستم TTS کیوتای به گفتار تبدیل شدند. این مرحله دقت را از ۲۷.۳ به ۶۱.۷ درصد رساند.
در مرحلهی دوم RL، برای هر سوال گفتاری ۴ پاسخ نمونهبرداری میشود و یک داور (Qwen3-235B-A22B-2507) امتیاز صفر و یک میدهد. آموزش روی ۱۶ کارت گرافیک H100 و در ۱,۵۰۰ بهروزرسانی انجام شد. دو تصمیم طراحی حیاتی بودند:
- تصحیح دما: لوگاریتم احتمالها پیش از محاسبهی تابع زیان بر دمای نمونهبرداری تقسیم میشوند. بدون این کار، دقت از ۶۵.۵ به ۱۲.۳ درصد سقوط میکند.
- ادغام توکنهای صوتی: تمام احتمالات واژگان صوتی در هر موقعیت به یک توکن انتزاعی تبدیل میشوند تا مدل فقط بداند صدایی باید تولید شود، نه کدام صدای خاص.
مدلهای منتشرشده#
نسخهی glm-4-voice-of-reason-9b بدون توکنهای استدلالی اضافی، پاسخ را مستقیماً بهصورت گفتاری میدهد. نسخهی glm-4-voice-of-reason-stitch-9b بین بلوکهای گفتاری، ۱۰۰ توکن استدلالی بیصدا تولید میکند که طبق ادعای کیوتای، همزمان با پخش گفتار قبلی ساخته میشوند و تأخیر اضافی ایجاد نمیکنند.
نتایج و محدودیتها#
بر اساس جدول نتایج، مدل Stitch به دقت ۷۴.۸ درصد (و در نسخهی نهایی منتشرشده ۷۷.۱ درصد) دست یافت. این در حالی است که مدلهای بزرگتر چندوجهی مانند Qwen3-Omni (با خروجی متنی) به ۹۴.۶ درصد میرسند، اما این مقایسهی مستقیمی نیست. جالب آنکه یادگیری تقویتی باعث کوتاهتر شدن پاسخهای گفتاری شد (از ۴۱.۹ به ۳۶.۴ ثانیه) و طبیعی بودن صدا پس از RL حفظ شد (امتیاز UTMOSv2 تقریباً ثابت ماند). با این حال، دقت در پرسشهای عمومی (TriviaQA) کاهش یافت.
خوانش تحریریه#
این خبر نشان میدهد که فاصلهی عملکردی بین مدلهای بومی گفتار و خطوط لولهی متنی در حوزهی ریاضی بهطور محسوسی در حال کم شدن است. برای توسعهدهندگانی که به دنبال حذف تأخیر و حفظ لحن در دستیارهای صوتی هستند، انتشار این وزنها روی Hugging Face و امکان اجرای آنها روی یک کارت H100، گزینهی عملی جدیدی است. اما باید احتیاط کرد: این مدلها هنوز به سطح دقت مدلهای زبانی متنی بزرگ نرسیدهاند و کاهش عملکرد در دانش عمومی (TriviaQA) نشان میدهد که بهینهسازی برای استدلال ریاضی ممکن است هزینههایی برای کاربردهای عمومیتر داشته باشد.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.