

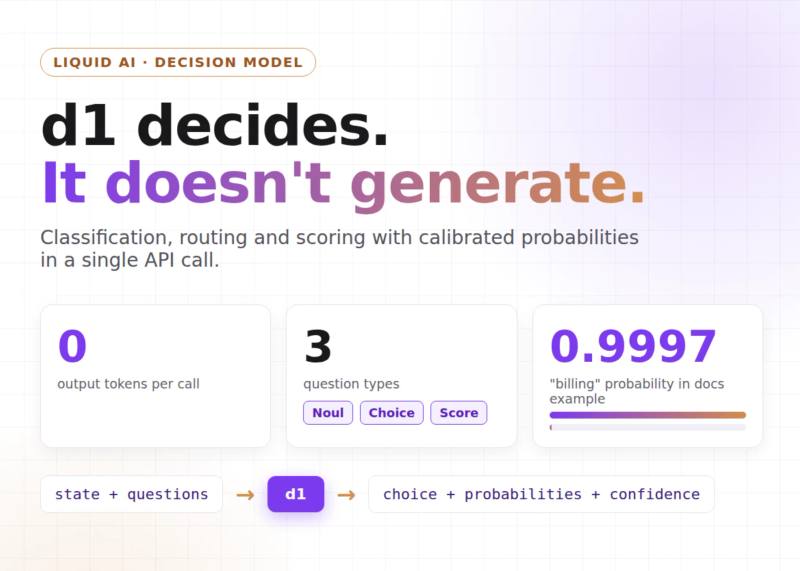


Liquid AI مدل d1 را منتشر کرده است؛ یک مدل تصمیمگیری که بهجای تولید متن، احتمالهای کالیبرهشده روی مجموعهای از گزینههای از پیش تعریفشده برمیگرداند. در هر پاسخ این مدل، مقدار usage.output_tokens برابر صفر است. d1 در دسترس بهصورت API میزبانیشده با نام d1:free قرار دارد و فعلاً امکان آموزشپذیری یا بارگیری وزنها (GGUF، MLX یا ONNX) برای میزبانی محلی وجود ندارد.
سه نوع سؤال: Noul، Choice و Score#
مدل d1 سه نوع سؤال (primitive) را پشتیبانی میکند و میتوان همه را در یک درخواست ترکیب کرد:
- Noul: سؤال بله/خیر که احتمال بین ۰ و ۱ برمیگرداند. در نمونهی مستندات، سؤال «آیا این پیام یک شکایت است؟» مقدار 0.999 برگردانده است.
- Choice: انتخاب یک گزینه از مجموعهای نامدار. برترین گزینه، توزیع کامل و یک مقدار اطمینان را برمیگرداند.
- Score: رتبهبندی ورودی روی یک مقیاس ترتیبی و بازگرداندن موقعیت وزندهیشده با احتمال. سطوح از صفر ایندکس میشوند؛ مثلاً مقیاس فوریت چهارسطحی بازه ۰ تا ۳ را پوشش میدهد.
چرا فراخوانهای طبقهبندی LLM را به d1 منتقل کنیم؟#
راهنمای مهاجرت Liquid AI تفاوتهای مشخص d1 را با یک LLM که خروجی ساختاریافته برمیگرداند اینگونه فهرست میکند: عدم هزینهی توکن خروجی، تأخیر قابلپیشبینی (چون حلقهی رمزگشایی وجود ندارد)، حذف خطاهای schema، احتمالهای کالیبرهشده بهجای عدد خودگزارشدهیشده، و کاهش تعداد round-tripها (سه فراخوان طبقهبندی پشتسرهم به یک فراخوان تبدیل میشود).
سقف عملی d1:free در دسترس است اما نرخهای پرداختی هنوز منتشر نشدهاند. پنجرهی بافت (context window) و اندازهی مدل نیز اعلام نشدهاند. کلاینتها از طریق typesafe-sdk برای Python و @typesafe-ai/sdk برای TypeScript در دسترساند و فراخوانها به آدرس POST https://api.liquid.ai/decisions/v1/systemone ارسال میشوند.
در مقایسه با رقبا، TypeSafe Jev 1.13 روی OpenRouter با نرخ 0.042 دلار به ازای هر میلیون توکن ورودی در دسترس است و Convai Laya و AutoTrust JEV-27B هر دو وزن باز با مجوز Apache 2.0 دارند و امکان fine-tuning دارند.
خوانش تحریریه: چه چیزی عوض میشود و چه چیزی نه#
برای تیمهایی که امروز طبقهبندی، مسیریابی تیکت یا امتیازدهی را با یک LLM و structured output انجام میدهند، d1 یک مزیت عملی روشن دارد: حذف هزینهی توکن خروجی و حذف خطاهای schema. اگر فراخوانهای شما پشتسرهم زیادند، کاهش round-trip هم محسوس است. اما این خبر برای کسی که هنوز LLM را برای خلاصهسازی، چت چندنوبتی یا تولید کد استفاده میکند، چیزی تغییر نمیدهد. محدودیت اصلی d1 این است که فقط روی گزینههای از پیش تعریفشده کار میکند؛ اگر پاسخ مدل باید یک رشتهی جدید بسازد، به LLM نیاز دارید. همچنین نبودِ وزنهای باز و عدم اعلام نرخ پرداختی، فعلاً امکان مقایسهی هزینه با رقبای self-hosted را محدود میکند.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.