

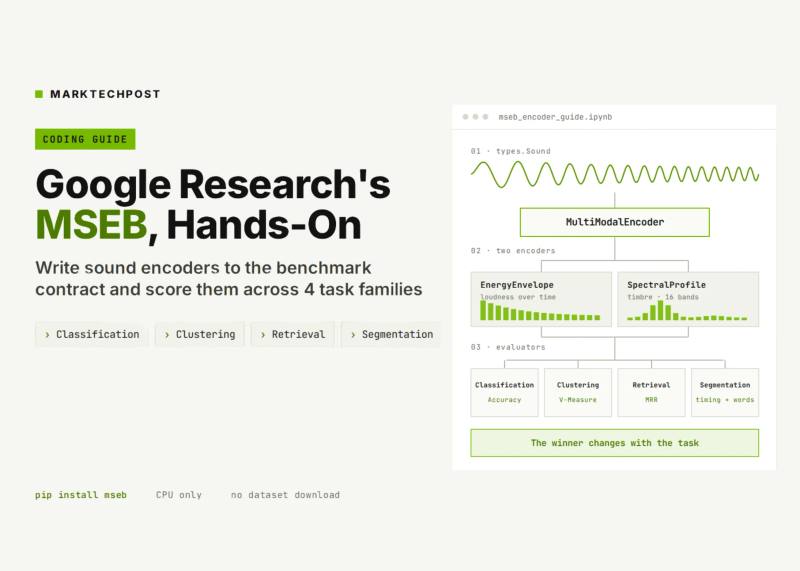
مارکتکپست راهنمای فنیای برای MSEB (Massive Sound Embedding Benchmark) منتشر کرده که محصول Google Research است. این راهنمای نسخه ۰.۱.۰ پکیج mseb را نصب میکند و معماری سهلایهی بنچمارک را باز میکند: لایهی types (شکلهای دادهی Sound، SoundEmbedding، Score و TaskMetadata)، لایهی encoder (قرارداد MultiModalEncoder که مدل شما پیادهسازی میکند) و لایهی evaluators (یک ماژول برای هر خانوادهی تسک).
نویسنده دو انکودر عمداً متفاوت روی کلاس پایهی framework نوشته است: یکی بلندی صدا (loudness) را در زمان اندازه میگیرد و دیگری رنگ صدا (timbre) را. هر دو روی یک کرپوس سنتتیک کوچک که در نوتبوک تولید میشود اجرا میشوند — بدون دانلود هیچ دادهای. سپس چهار ارزیاب classification، clustering، retrieval و segmentation روی embeddingهای حاصل اجرا میشوند.
نتیجهی کمّی این است که دو انکودر بسته به ارزیابی که میپرسد جای خود را عوض میکنند. نویسنده این را «استدلال عددی برای یک بنچمارک چندتسکی» مینامد: نمرهی یک انکودر روی یک تسک، پیشبینیکنندهی عملکردش روی تسک دیگر نیست.
محدودیتهای فنی اجرا#
راهنمای مارکتکپست تأکید میکند که ارزیابهای classification، clustering، retrieval و segmentation فقط به NumPy و scikit-learn وابستهاند و روی CPU رایگان بدون accelerator اجرا میشوند. اما ارزیابهای reranking و transcription به Whisper وابستهاند و task runner به TensorFlow و apache-beam — یعنی برای تسکهای دیگر این سادگی برقرار نیست.
در قرارداد تایپها، رابطهی بین تعداد embeddingها (N) و تعداد timestampها (M) معنای فنی دارد: اگر M برابر N باشد، بردارها frame-aligned هستند؛ اگر M برابر ۱ باشد، یک بردار utterance-level داریم. فیلد embedding میتواند علاوه بر بردار، رشتهی متنی هم حمل کند.
خوانش تحریریه#
این خبر یک «معرفی محصول» نیست؛ یک راهنمای عملی است. اما نکتهی قابلاستفاده برای کسی که ایجنت صوتی یا سیستم retrieval میسازد، این است: MSEB از ابتدا چندتسکی طراحی شده و نمرهی leaderboard آن یک عدد تکبعدی نیست. اگر قرار است انکودر صوتی خودتان را با MSEB بسنجید، باید از همان ابتدا تصمیم بگیرید که برای کدام ارزیاب بهینه میکنید — چون بهینهسازی برای طبقهبندی میتواند بازیابی را خراب کند. همچنین محدودیت وابستگیها مهم است: اگر به reranking یا transcription نیاز دارید، Whisper و TensorFlow وارد بازی میشوند و دیگر نمیتوانید روی CPU رایگان کار کنید.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.