



Nutrient (PSPDFKit سابق) API استخراج دادهای را معرفی کرده که فایلهای PDF، تصاویر اسکنشده و فایلهای Office را به JSON یا Markdown تبدیل میکند. نکته اصلی این ابزار، ارائهی «استناد» برای هر مقدار استخراجشده است: هر فیلد به یک صفحه، یک bounding box، یک برچسب تطابق و یک نمره اطمینان متصل میشود.
عملکرد و هزینه#
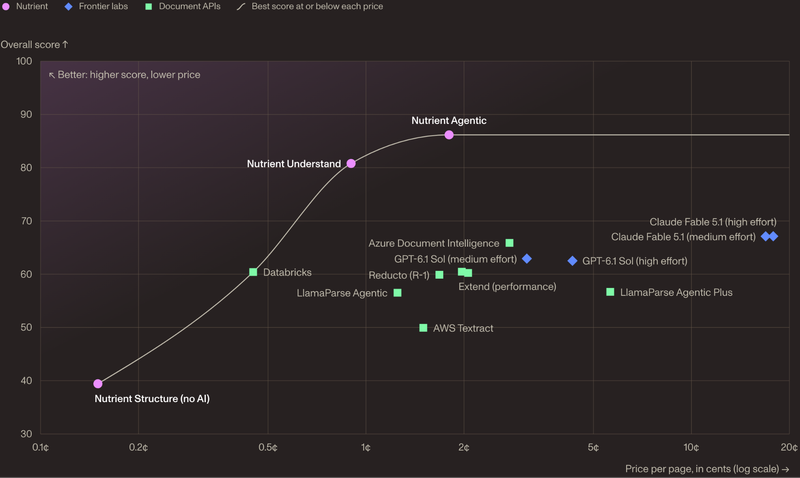
در WholeDoc Bench — بنچمارکی با ۴۸۰ سند، بیش از ۳۰ زبان و ۷ حوزه — تنظیم agentic این API نمره کلی ۸۶.۲ کسب کرده که بالاترین نتیجه میان ۱۹ تنظیم ارزیابیشده است. هزینه این حالت ۱.۸ سنت در هر صفحه است. برای مقایسه، بهترین تنظیم مدلهای frontier نمره ۶۷.۱ با هزینه ۱۷.۸ سنت در هر صفحه کسب کرده است.
API چهار حالت پارس دارد که با auto routing بهصورت خودکار انتخاب میشوند:
- text: PDF و فایل Office دیجیتال، بدون OCR — ۰.۱ سنت در صفحه
- structure: OCR برای اسکنهای ساده — ۰.۱۵ سنت در صفحه
- understand: تحلیل چیدمان با AI برای فرمها و چیدمانهای پیچیده — ۰.۹ سنت در صفحه
- agentic: مدل زبانی بینایی برای دستخط، اسکنهای مخدوش و نمودارها — ۱.۸ سنت در صفحه
هزینه Extract برای هر فیلد ۰.۶ سنت اضافه میشود. پلن رایگان ماهانه ۵ دلار اعتبار دارد (تقریباً ۳۳0 استخراج understand). پلن Starter ماهانه ۷۵ دلار برای ۹۰ دلار اعتبار و Growth ماهانه ۲۷۵ دلار برای ۳۴۵ دلار اعتبار است.
مکانیزم اطمینان#
نمره اطمینان ترکیبی از چند سیگنال اختیاری است: احتمال توکن، فاصله کاندیداها، grounding و فرمت. مدل grounding مبتنی بر NLI شرکت Nutrient تحت مجوز Apache-2.0 منتشر شده. هر فیلد برچسب تطابق جداگانه دارد: id_match، id_match_multiblock، id_match_partial، fuzzy_match یا not_found. توصیه Nutrient این است که ابتدا بر اساس برچسب تطابق تصمیم بگیرید و سپس اطمینان را بررسی کنید.
دسترسی#
این موتور همزمان پشت یک MCP server (بدون نیاز به API key)، یک agent skill، اپ Mac و SDK قرار دارد. در اپ Mac، اسناد فقط با مدل محلی کاملاً لوکال میمانند؛ برای استفاده آفلاین در محیط تولید، SDK لازم است.
این خبر برای سازندگان ایجنت چه معنایی دارد#
عدد ۸۶.۲ در برابر ۶۷.۱ با هزینه یکدهم، اگر در سناریوی واقعی شما هم تکرار شود، مستقیماً روی هزینهی هر درخواست و کیفیت خروجی اثر دارد. اما باید احتیاط کرد: WholeDoc Bench نمره پارسینگ کل سند است، نه دقت استخراج فیلد. در متن خبر تأکید شده که «یک مقدار با اطمینان ۰.۹۷ میتواند از ستون اشتباه خوانده شده باشد». یعنی نمره اطمینان بهتنهایی تضمین صحت نیست و حلقه بازبینی انسانی یا قواعد کسبوکاری هنوز لازم است. برای تیمهایی که حالا با مدلهای frontier استخراج میکنند، این API بیشتر یک گزینهی اقتصادی برای اسناد ساختارمند است تا جایگزین کامل. اگر اسناد شما دستخط یا نمودار دارند، حالت agentic منطقی است؛ اگر PDF دیجیتال سادهاند، حالت text با یکدهم هزینه کافی است.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.