


مشکل اصلی ایجنتهای هوش مصنوعی (AI Agent) در production، نبود قابلیت نیست — هزینهی پنهان تصمیمگیری پویاست. هر مرحلهی reasoning یک فراخوانی کامل مدل زبانی است و تاریخچهی جمعشده، مصرف توکن را بهطور غیرخطی بالا میبرد. این شکاف بین demo و production، دلیل فروپاشی اکثر پروژههاست و از روز اول باید طراحی شود.
ایجنت هوش مصنوعی چیست و چه مرزی با چتبات و Workflow دارد؟#
ایجنت هوش مصنوعی سیستمی است که در هر گام خودش قضاوت میکند: آیا به ابزار نیاز دارد، کدام ابزار را با چه پارامترهایی صدا بزند، و آیا خروجی فعلی کافی است یا ادامه بدهد. چتبات فقط پاسخ تولید میکند و Workflow مسیر از پیشتعریفشده را بدون قضاوت اجرا میکند. مرز سهگانه، همین تصمیمگیری پویا (Dynamic Decision-Making) است.
اگر مدل زبانی همیشه یک تابع خاص را با پارامترهای ثابت صدا میزند، صرفاً Function Calling انجام داده — ایجنت نیست. ایجنت زمانی شکل میگیرد که مدل دربارهی چهار سؤال مستقل قضاوت کند: «آیا نیاز به ابزار دارم؟»، «کدام ابزار؟»، «با چه ورودی؟»، «آیا ادامه بدهم؟». نبود حتی یکی از این چهار، ایجنت را به اسکریپت تبدیل میکند.
مثال عملی: چتباتی که همیشه به API آبوهوا زنگ میزند، ایجنت نیست. ایجنتی که ابتدا سؤال کاربر را تحلیل میکند، تشخیص میدهد «هوا چقدر سرد است؟» به دادهی آبوهوا نیاز دارد ولی «بهترین مقصد سفر زمستانی؟» اول باید جستجوی مقصد و بعد چک کردن هوا را انجام دهد، ایجنت است. تفاوت در ترتیب نیست — در قضاوتِ ترتیب است.
سه عنصر جداییناپذیر ایجنت#
هر ایجنت واقعی سه عنصر دارد که حذف یکی، آن را به فراخوانی مدل زبانی با خروجی ساختارمند تقلیل میدهد:
- برنامهریزی (Planning): شکستن هدف به زیرمراحل و انتخاب ترتیب اجرا
- تصمیمگیری (Decision-Making): قضاوت دربارهی کفایت خروجی فعلی و نیاز به ادامه
- اقدام (Acting): فراخوانی ابزار با پارامترهای مشخصشده از تصمیم قبلی
Workflow خودکار فقط عنصر سوم را دارد. چتبات با Function Calling هم فقط سوم را دارد — و آن هم بهصورت ثابت. ایجنت هر سه را در یک حلقه (Loop) اجرا میکند و خروجی هر حلقه، ورودی تصمیم بعدی است.
معماری ایجنت: چهار لایهای که باید از هم تفکیک شوند#
معماری ایجنت از چهار لایهی مجزا تشکیل شده: مدل زبانی بزرگ (LLM) بهعنوان مغز تصمیمگیری، ابزارها (Tool Use) بهعنوان دستها، حافظه (Memory) بهعنوان دانش، و برنامهریز (Planner) بهعنوان استراتژیست. تفکیک این لایهها، شرط اول دیباگپذیری و مقیاسپذیری است.
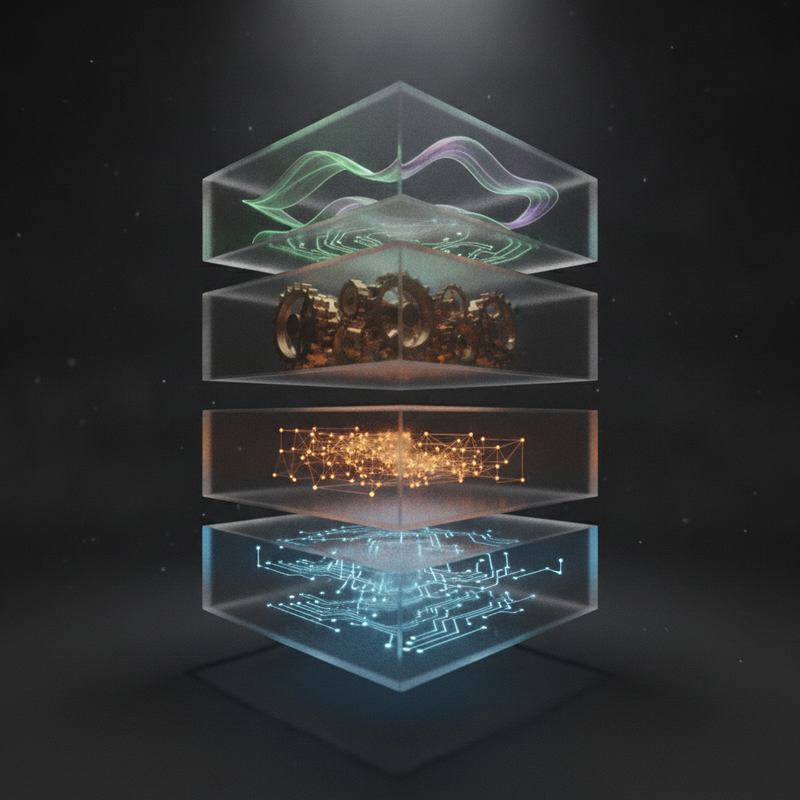
وقتی این چهار لایه در هم ادغام شوند — مثلاً حافظه و برنامهریز هر دو در prompt یکی نوشته شوند — هر تغییر کوچک در یکی، رفتار کل سیستم را بیثبات میکند. این دقیقاً همان اشتباهی است که ایجنتهای demo را در production میکُشد.
LLM بهعنوان مغز — انتخاب مدل و تأثیر آن بر کیفیت تصمیم#
مدل زبانی، مغز ایجنت است. نه فقط تولیدکنندهی متن، بلکه قضاوتکنندهی «ادامه بدهم یا نه». انتخاب مدل مستقیماً بر کیفیت تصمیمگیری تأثیر میگذارد. مدلهای ضعیفتر در تشخیص کفایت خروجی، حلقههای بیپایان میسازند یا زودتر از موعد متوقف میشوند.
در پروژههای اعضای کامیونیتی اسکول، الگوی تکرارشوندهای دیده میشود: استفاده از یک مدل ارزانتر برای مراحل سادهی استخراج پارامتر و یک مدل قویتر برای تصمیمگیری نهایی، هم هزینه را کم کرده و هم کیفیت را حفظ کرده است. این تفکیک، نه بهخاطر صرفهجویی صرف، بلکه بهخاطر کاهش خطای قضاوت است.
ابزارها و Function Calling — اتصال به APIهای خارجی#
Function Calling مکانیزم ارتباط ایجنت با دنیای بیرون است. مدل بهجای تولید متن آزاد، یک ساختار JSON با نام تابع و پارامترها تولید میکند. تعریف ابزارها با JSON Schema انجام میشود و دقت schema، مستقیماً بر صحت پارامترهای تولیدشده تأثیر دارد.
یک اشتباه رایج و پرهزینه: schema بیش از حد ساده باشد و مدل پارامترهای ضروری را حذف کند. schema بیش از حد پیچیده باشد و مدل توکنهای بیشتری صرف فهم آن کند و احتمال خطا بالا برود. در کلاسهای کامیونیتی، این خطا آنقدر تکرار شده که میتوان گفت: schema بد، مخربتر از نبود schema است — چون توهم صحت میسازد.
حافظه در ایجنت — Context Window، RAG و حافظه بلندمدت#
حافظه (Memory) سه لایه دارد: Context Window بهعنوان حافظه کوتاهمدت (تاریخچهی مکالمهی جاری)، RAG (Retrieval-Augmented Generation) بهعنوان حافظه دانش (بازیابی از پایگاه داده)، و Vector Store یا Database بهعنوان حافظه بلندمدت (یادآوری بین جلسات). اشتباه رایج، استفادهی همزمان از هر سه بدون نیاز واقعی است — که هم هزینهی توکن بالا میبرد و هم noise وارد context میکند.
برنامهریز — جدا کردن تصمیم استراتژیک از اجرای عملیاتی#
Planner مسئول شکستن هدف به زیرمراحل و اولویتبندی است. Executor مسئول اجرای هر زیرمرحله. وقتی این دو در یک prompt ادغام شوند، مدل همزمان باید «چه کار کنم» و «چطور انجامش دهم» را تصمیم بگیرد — و کیفیت هر دو افت میکند. تفکیک، هزینهی توکن را بالا میبرد اما دیباگ را ممکن میکند.
نمونهی ساختار پوشهی یک ایجنت:
agent/
core/
planner.py
executor.py
memory.py
tools/
api_client.py
web_search.py
calculator.py
config/
agent_config.yaml
tool_registry.json
الگوهای تصمیمگیری: ReAct، Plan-and-Execute و Reflexion#
الگوی ReAct (Yao et al., 2022) چرخهی Thought→Action→Observation را معرفی کرد و پایهی اکثر ایجنتهای امروزی است. Plan-and-Execute برای کارهای چندمرحلهای با ساختار از پیش معلوم بهتر عمل میکند. Reflexion برای بهبود خودکار کیفیت خروجی طراحی شده و هزینهی اضافی دارد. انتخاب الگو، نه سلیقهای است نه تصادفی — به ماهیت مسئله وابسته است.
ReAct — چرخهی استدلال و عمل#
در هر حلقهی ReAct، مدل سه چیز تولید میکند: یک thought (استدلال دربارهی وضعیت فعلی)، یک action (فراخوانی ابزار)، و سپس observation (خروجی ابزار) به context اضافه میشود. این چرخه تا رسیدن به final answer ادامه دارد.
ReAct هنوز استاندارد است چون ساده، قابلپیشبینی و قابلدیباگ است. هر گام را میتوان لاگ کرد و مسیر تصمیمگیری را بازسازی نمود. در پروژههای واقعی، همین قابلیت بازسازی، دلیل اصلی انتخاب ReAct بر الگوهای پیچیدهتر است — نه صرفاً سادگی.
Plan-and-Execute — تفکیک برنامهریزی از اجرا#
مدل ابتدا کل مسیر را بهصورت یک لیست مراحلی تولید میکند، سپس هر مرحله را جداگانه اجرا میکند. مناسب برای کارهایی که ساختار از پیش معلوم است — مثلاً «جستجو کن، خلاصه کن، بنویس». اگر در حین اجرا مسیر عوض شود، باید re-plan انجام شود که هزینهی اضافی دارد.
Reflexion — حلقهی خودبازخوردی#
پس از هر خروجی، یک مدل دیگر (یا همان مدل با prompt متفاوت) کیفیت را ارزیابی میکند و اگر زیر آستانه باشد، بازخورد میدهد و ایجنت دوباره تلاش میکند. هزینهی اضافی: هر چرخهی بازخورد یک فراخوانی کامل LLM است.
Orchestrator-Worker Pattern#
در سیستمهای چندایجنتی، یک ایجنت Orchestrator وظیفهی تقسیم کار را بر عهده دارد و چند ایجنت Worker هر کدام یک زیرمسئله را حل میکنند. الگوی مایکروسافت در AutoGen بر این پایه استوار است.
جدول تصمیمگیری برای انتخاب الگو:
| الگو | مناسب برای | هزینهی نسبی | دیباگپذیری |
|---|---|---|---|
| ReAct | مسئلههای باز، تعداد مراحل نامعلوم | متوسط | بالا — هر گام لاگ میشود |
| Plan-and-Execute | مسئلههای ساختارمند با مراحل معلوم | متوسط تا بالا (re-plan) | متوسط |
| Reflexion | خروجیهایی که کیفیت حیاتی دارند | بالا — حلقهی اضافی | متوسط |
| Orchestrator-Worker | مسئلههای چنداجزای مستقل | بالا — coordination overhead | پایین |
هزینهی پنهان ایجنت چندمرحلهای چقدر است؟#
هر مرحلهی Reasoning یک فراخوانی کامل LLM است و هزینه با تعداد مراحل تقریباً خطی رشد میکند. یک ایجنت 5 مرحلهای میتواند هزینهی توکنی 5 برابر یک فراخوانی ساده داشته باشد — بدون اینکه کاربر متوجه شود. دلیل اصلی: در هر مرحله، تاریخچهی مراحل قبلی هم بهعنوان context ارسال میشود.
آناتومی مصرف توکن در یک حلقهی ReAct#
در مرحلهی اول: prompt سیستم + سؤال کاربر + تعریف ابزارها → ورودی. خروجی: thought + action. در مرحلهی دوم: همهی مرحلهی اول + observation جدید → ورودی. خروجی: thought + action جدید. هر مرحله، ورودی بزرگتری دارد چون تاریخچه جمع میشود.
تأثیر Context Window — تاریخچهی انباشته#
اگر هر مرحله 2000 توکن ورودی و 500 توکن خروجی داشته باشد، مرحلهی اول 2500، مرحلهی دوم 5000 (2500 قبلی + 2000 ورودی جدید + 500 خروجی)، و مرحلهی سوم 7500 توکن مصرف میکند. رشد خطی نیست — رشد با شیب مثبت است چون context جمع میشود.
Overhead سیستم چندایجنتی#
در سیستم چندایجنتی، coordination بین ایجنتها خودش به فراخوانی LLM نیاز دارد. Orchestrator باید تصمیم بگیرد کدام Worker را صدا بزند، خروجی را بررسی کند و نتیجه را ترکیب نماید. این overhead، هزینهی توکن را بدون تولید خروجی نهایی بالا میبرد. در پروژههای اعضای کامیونیتی، الگوی تکرارشوندهای هست: تیمها ابتدا سیستم چندایجنتی میسازند، بعد میبینند که Orchestrator تنها، با ابزارهای مناسب، همان مسئله را با هزینهی نصف حل میکند.
استراتژیهای کاهش هزینه#
- خلاصهسازی تاریخچه: بهجای ارسال کل context، خلاصهای از مراحل قبلی ارسال شود. هزینهی خلاصهسازی کمتر از ارسال کامل است.
- محدود کردن حداکثر مراحل: یک سقف سخت برای تعداد iterations تعیین شود. بدون سقف، حلقهی بیپایان = هزینهی بیپایان.
- انتخاب مدل ارزانتر برای مراحل ساده: استخراج پارامتر یا فرمتدهی نیاز به مدل گرانقیمت ندارد.
- Caching: اگر بخشی از context ثابت است، از prompt caching استفاده شود.
بهترین فریمورک ساخت ایجنت AI کدام است؟#
هیچ فریمورکی «بهترین مطلق» نیست. LangChain انعطاف و اکوسیستم ابزار بیشتری دارد، CrewAI برای سیستمهای چندایجنتی با نقشهای مشخص سادهتر است، AutoGen معماری گفتگو بین ایجنتها را ارائه میدهد و Semantic Kernel برای سازمانهای مایکروسافتمحور مناسبتر است. انتخاب بستگی به مسئله، تیم و نیاز به دیباگ دارد.
LangChain — زنجیرهسازی و اکوسیستم ابزار#
LangChain (Harrison Chase, 2022) انعطاف بالایی در زنجیرهسازی فراخوانیها و اتصال ابزارها دارد. اما وابستگیهای سنگین، لایههای انتزاعی زیاد و چالش دیباگ، نقاط ضعف شناختهشدهاش هستند. در پروژههای واقعی، وقتی ایجنت رفتار غیرمنتظره نشان میدهد، ردیابی خطا در لایههای LangChain دشوار است — نه غیرممکن، اما دشوار.
CrewAI — ایجنتهای نقشمحور#
CrewAI برای سناریوهایی طراحی شده که چند ایجنت با نقشهای مشخص (مثلاً محقق، نویسنده، ویرایشگر) روی یک مسئله کار میکنند. هماهنگی سادهتر از AutoGen است اما انعطاف کمتری در معماری سفارشی دارد.
AutoGen — معماری گفتگو بین ایجنتها#
AutoGen (Wu et al., 2023) ایجنتها را در قالب گفتگو با هم هماهنگ میکند. برای مسئلههای پیچیدهی چنداجزا مناسب است اما debug کردن گفتگوهای بین ایجنتها، چالش جدیای است.
OpenAI Assistants API و Semantic Kernel#
OpenAI Assistants API مدیریت state و thread را به سمت سرور منتقل میکند — سادهتر برای شروع، اما lock-in به OpenAI. Semantic Kernel برای سازمانهایی که روی Azure و مایکروسافت سرمایهگذاری کردهاند، یکپارچگی بهتری دارد.
| فریمورک | سطح انتزاع | دیباگ | مناسب برای |
|---|---|---|---|
| LangChain | متوسط — لایههای زیاد | سخت — trace بین لایهها دشوار | تکایجنت با ابزارهای متنوع |
| CrewAI | بالا — نقشمحور | متوسط | چندایجنت ساده با نقش مشخص |
| AutoGen | متوسط — گفتگومحور | سخت — ردیابی گفتگو | مسئلههای پیچیدهی چنداجزا |
| OpenAI Assistants | پایین — state محوری | متوسط | شروع سریع با lock-in |
| Semantic Kernel | متوسط — enterprise | متوسط | سازمانهای مایکروسافتمحور |
از Demo تا Production: سه شکست رایج و راهحلهای عملی#
ایجنتهایی که در محیط نمایشی کار میکنند در production با timeout ابزارها، پاسخهای مبهم LLM و edge caseهای واقعی فرو میپاشند. بدون retry با exponential backoff، fallback به پاسخ ساده و circuit breaker، دوام نمیآورند. این شکاف، دلیل اصلی شکست اکثر ایجنتهاست.
شکست اول — Timeout و خطای ابزار#
API خارجی در production timeout میدهد، rate limit میزند یا پاسخ ساختارمند نمیدهد. اگر ایجنت هیچ fallback ندارد، کل حلقه متوقف میشود. راهحل: retry با exponential backoff و تعریف یک مسیر fallback — مثلاً اگر web search جواب نداد، از knowledge base داخلی استفاده شود.
شکست دوم — حلقهی بیپایان تصمیمگیری#
مدل تشخیص نمیدهد که خروجی کافی است و دوباره و دوباره ابزار صدا میزند. بدون سقف iterations، این یعنی هزینهی بیپایان. راهحل: max_steps سخت + تشخیص stuck state (اگر دو iteration پیاپی action یکسان با پارامتر یکسان تولید کرد، متوقف شو).
شکست سوم — پاسخهای مبهم و Hallucination در ابزار#
ایجنت از یک ابزار خروجی مبهم یا نادرست میگیرد و بر اساس آن تصمیم بعدی را اشتباه میسازد. Hallucination فقط در تولید متن نیست — در تفسیر خروجی ابزار هم رخ میدهد. راهحل: اعتبارسنجی خروجی ابزار قبل از استفاده — schema validation، range check، یا یک فراخوانی تأییدی.
استراتژی ارزیابی#
ایجنت مسیر متغیر دارد و نمیتوان با accuracy ساده سنجید. سه رویکرد عملی:
- Task Success Rate: آیا هدف نهایی محقق شد؟
- Trajectory Evaluation: آیا مسیر تصمیمگیری منطقی بود؟
- LLM-as-Judge: یک مدل دیگر کل trajectory را امتیاز میدهد.
نمونهی شبهکد circuit breaker ساده:
consecutive_failures = 0
for step in range(max_steps):
action = llm.decide(context)
result = execute(action)
if result.is_error:
consecutive_failures += 1
if consecutive_failures >= 3:
return fallback_response()
else:
consecutive_failures = 0
context.append(result)
چه زمانی ایجنت AI مناسب نیست و سادهتر کردن معماری بهتر است؟#
اگر مسیر اجرا از قبل معلوم است، تعداد مراحل ثابت است و تصمیمگیری پویا وجود ندارد، یک Workflow ساده یا چند فراخوانی ترتیبی LLM ارزانتر، سریعتر و قابلاطمینانتر از ایجنت است. استفاده از واژهی «ایجنت» برای هر اتوماسیونی که یک LLM در آن هست، رایجترین اشتباه بازاریابی است.
چارچوب تصمیمگیری «ایجنت یا نه؟»#
سه معیار ساده:
- نیاز به تصمیم پویا: آیا مدل باید قضاوت کند که «ادامه بدهم یا نه»؟ اگر نه، workflow کافی است.
- عدم قطعیت مسیر: آیا ترتیب مراحل از قبل معلوم نیست؟ اگر معلوم است، plan-and-execute یا workflow ساده بهتر است.
- نیاز به تطبیق با ورودی: آیا ورودیهای مختلف مسیرهای کاملاً متفاوت میطلبند؟ اگر بله، ایجنت منطقی است.
اگر هر سه معیار «نه» هستند، ایجنت اضافهکاری است. هزینهی توکن بیشتر، تأخیر بیشتر، و دیباگ سختتر — بدون مزیت واقعی.
سیستم چندایجنتی چه زمانی لازم است و چه زمانی اضافهکاری#
وقتی مسئله واقعاً چند اجزای مستقل دارد که نیاز به هماهنگی دارند — مثلاً یک ایجنت جستجو کند، دیگری تحلیل و سومی نوشتن. اگر یک ایجنت تکنفره با ابزارهای مناسب مسئله را حل میکند، سیستم چندایجنتی فقط coordination overhead و هزینه و تأخیر اضافه است.
رایجترین اشتباهات طراحی#
- توصیف ایجنت بهعنوان «چتباتی که ابزار صدا میزند» — بدون اشاره به تصمیمگیری پویا
- نادیده گرفتن مدیریت state — ایجنت بدون state management در production بیثبات است
- استفاده از MCP (Model Context Protocol) بدون نیاز واقعی — پروتکل استاندارد اتصال ابزار است، نه جایگزین معماری ایجنت
- ساختن ایجنت برای مسئلهای که یک prompt خوب حلش میکند
جمعبندی عملی#
ایجنت هوش مصنوعی یک معماری تصمیمگیری چندمرحلهای است که هزینهی توکن، تأخیر و پیچیدگی دیباگ را بهطور خطی بالا میبرد. اگر مسئلهی شما واقعاً به تصمیمگیری پویا نیاز دارد، ایجنت بسازید — اما از روز اول، retry، fallback، سقف iterations و ارزیابی trajectory را طراحی کنید. اگر نیاز ندارد، workflow ساده بسازید و از هزینهی اضافی بکاهید.
اگر میخواهید ایجنت و اتوماسیون را عملاً بسازید و از آن درآمد داشته باشید، در اسکول یک مسیر مشخص وجود دارد: دورهی «ساخت Ai Agent با N8N» در کامیونیتی پرداختی N8N، با 51 جلسه و 10 فصل، از صفر تا پروژهی واقعی. اگر هم بدون کدنویسی میخواهید ایدهتان را با ایجنتها به محصول تبدیل کنید، دورهی «آموزش جامع Claude و ابزارهای مشابه» همان مسیر را با Vibe Coding طی میکند.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.