

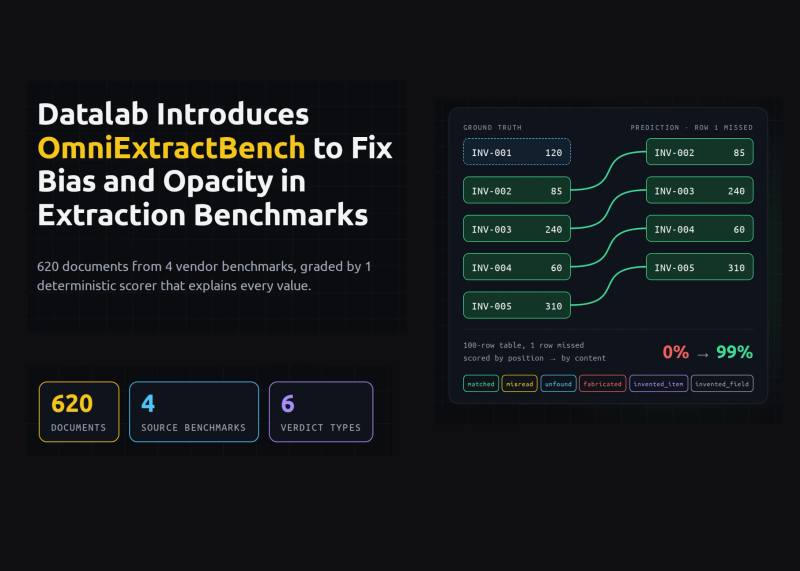


Datalab بنچمارک متنباز OmniExtractBench را منتشر کرد: مجموعهای برای ارزیابی دقت استخراج ساختیافته از اسناد PDF. این بنچمارک ۶۲۰ سند از چهار منبع مختلف را گردآوری کرده و یک امتیازدهکننده قطعی (deterministic scorer) با شش نوع حکم، هر مقدار در خروجی JSON را جداگانه ارزیابی میکند.
چه مشکلاتی را هدف گرفته#
Datalab در پست انتشار، چهار مشکل تکراری بنچمارکهای موجود را نام برده است: سوگیری در انتخاب اسناد و نحوه امتیازدهی به نفع سازنده بنچمارک، harnessهای مبهم که نمره پایین ممکن است ناشی از نقص ابزار باشد نه ضعف مدل، عدم شفافیت در دلایل نمره، و تنوع محدود اسناد.
نحوه کار امتیازدهکننده#
امتیازدهکننده، پیشبینی و فایل طلایی (gold) را به آدرسهای مقدار (مسیرهای تکمقداری) مسطح میکند و هر مقدار را نرمالسازی میکند تا مثلاً «03/31/2024» با «2024-03-31» مطابقت دهد. برای جدولها از الگوریتم مجار (Hungarian algorithm) استفاده میکند تا جفتسازی بر اساس محتوا انجام شود، نه موقعیت. Datalab نشان داد که در یک جدول ۱۰۰ ردیفی با یک ردیف حذفشده، مقایسه موقعیتی ۰٪ نمره میدهد در حالی که OmniExtractBench ۹۹٪ نمره میدهد.
شش نوع حکم برای هر مقدار: matched (مطابقت کامل)، misread (مطابقت با مقدار اشتباه)، unfound (مقدار در gold ولی نه در پیشبینی)، fabricated (پیشبینی مقداری ساخته که gold ندارد)، invented_item (ردیفی که با هیچچیز جفت نمیشود)، و invented_field (آدرسی که schema اعلام نکرده).
نتایج ارزیابی ۱۰ پیکربندی#
حالت accurate خود Datalab با دقت ۹۳.۸۵ در صدر است. Datalab balanced (۹۳.۴۸) و Reducto deep_extract v2 (۹۳.۴۷) عملاً برابرند. GPT 5.6-sol دقت (precision) ۹۵.۱۱ و فراخوانی (recall) ۸۴.۹۹ دارد؛ یعنی ۱۱.۸۸٪ مقادیر را از دست میدهد. LlamaExtract با recall ۹۳.۱۳ و precision ۸۶.۵۷، ۹.۰۳٪ مقادیر ساختگی تولید میکند. Mistral OCR 4.1 و Azure Content Understanding در هر دو معیار عقبترند.
دسترسی#
امتیازدهکننده از PyPI با نام omni-extract-bench (نسخه ۰.۱.۷، پایتون ۳.۱۱ به بالا، وابستگی فقط SciPy) و زیر مجوز Apache ۲.۰ نصب میشود. دادهها روی Hugging Face با مجوز CC BY 4.0 قرار دارند. اجرای مجدد روی فروشندگان نیازمند کلید API و اعتبار پرداختی خودتان است.
خوانش تحریریه#
OmniExtractBench برای کسی که ایجنت استخراج اسناد میسازد، ابزار مقایسهای شفافتری ارائه میدهد — بهویژه بهخاطر تفکیک «از دست دادن مقدار» از «ساختن مقدار». این تفکیک مهم است چون دو نوع خطا، دو نوع اصلاح میخواهند. اما این بنچمارک هنوز ۶۲۰ سند دارد و ۲۰۲ تا از آنها synthetic و متعلق به خود Datalab است؛ یعنی بزرگترین سهم دوم را سازنده بنچمارک در اختیار دارد. اگر قرار است بهعنوان مرجع بیطرف استفاده شود، این نقطه ضعف را باید در نظر گرفت. همچنین، دقتهای بالای ۹۳٪ در صدر جدول نشان میدهد فاصله بین مدلهای برتر بسیار کم است و انتخاب بین آنها احتمالاً به معیارهای دیگری مثل هزینه و سرعت بستگی خواهد داشت، نه صرفاً به نمره این بنچمارک.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.