

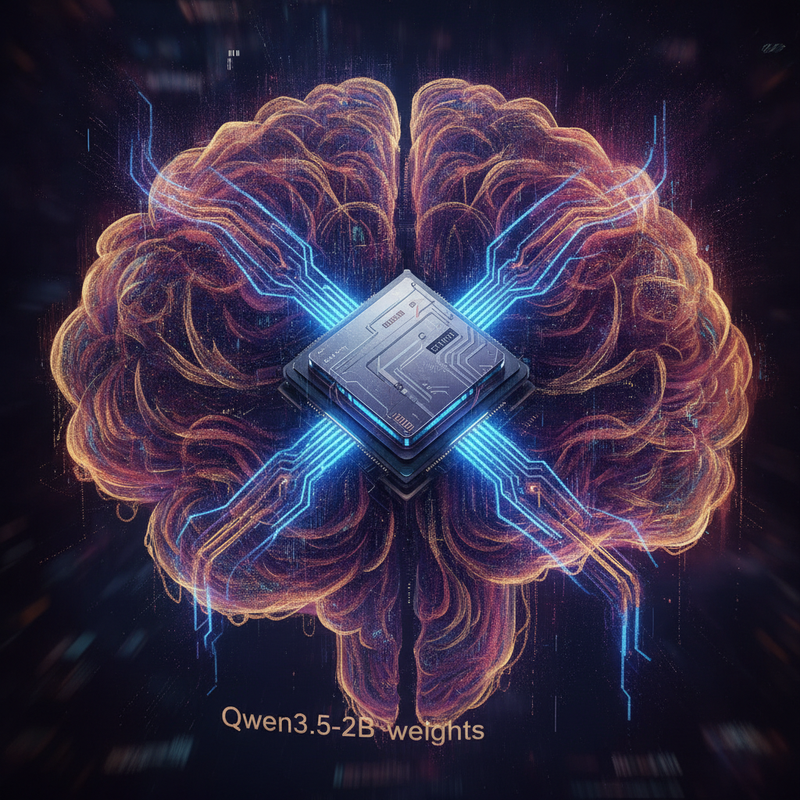
Vixhal (در توییتر @TheVixhal) پروژهی qwenGPU را در GitHub منتشر کرده است. این مدل آزمایشی یک ماشین SIMT چهارمسیره را بهصورت ۴۵ لایهی کامپایلشده (بدون هیچ آموزش) در جلوی ۲۴ لایهی اصلی Qwen3.5-2B قرار میدهد؛ مجموعاً ۶۹ لایه. نتیجه: مدل در داخل forward passهای خود، CUDA واقعی اجرا میکند که به PTX انویدیا کامپایل شده است.
GPU داخل وزنها چطور کار میکند؟#
ماشین کامپایلشده ۱۵ رجیستر در هر مسیر، یک خطلولهی چهارمرحلهای، ۳۲ بلوک ROM و ۱۲۶ کلمه حافظه دارد. نوع لایهها همانهایی هستند که خودِ Qwen3.5 استفاده میکند: Gated DeltaNet (توجه خطی) و MLPهای SwiGLU. وضعیت بازگشتی Gated DeltaNet نقش رجیستر، ROM و حافظهی جهانی را بازی میکند: در هر سرِ توجه، دروازه باز نگه داشته شده و قدرت نوشتن ۱ است؛ هر کلید one-hot است و هر بهروزرسانی دقیقاً یک سطر را بازنویسی میکند.
در زمان اجرا، host نقش NVRTC و درایور CUDA را بازی میکند: CUDA را با clang به PTX کامپایل میکند، سپس PTX را به بلوکهای ماشین پایینمیآورد و بهصورت توکن به مدل میدهد. مدل خودِ launch را مینویسد. در ویدیوی نمایشی، ضرب داخلی [1,2,3] و [4,5,6] برابر ۳۲ در ۴۷ توکن نوشته شده است.
اعداد و محدودیتها#
- سرعت: ۱۰ تا ۱۵ توکن بر ثانیه روی Apple MPS؛ بدون نسخهی کوانتایزشده.
- درستمحاسبه: تمام launchها در حالت --check دقیق بودند؛ مفسر مرجع ۴۹ از ۴۹ کرنل را با Tesla T4 مطابقت داد.
- انحراف متنی: KL حدود ۷e-4 نسبت به مدل اصلی.
- حالت پیشرفته (نوشتن کرنل CUDA توسط خود مدل): ۴ از ۵ پاسخ درست.
- حالت عادی (فراخوانی کرنل آماده): ۲۰ از ۲۴ پرسش چت با عدد محاسبهشده توسط GPU.
نیازهای اجرا#
Python 3.11+، ابزارهای uv و just، حدود ۱۶ گیگابایت حافظه آزاد. حالت پیشرفته به clang با بکاند NVPTX نیاز دارد. هیچ checkpoint آمادهای منتشر نشده؛ با just build مدل ساخته میشود و checkpoint حاصل تحت لایسنس Apache-2.0 خودِ Qwen قرار میگیرد.
این خبر برای کسی که ایجنت میسازد چه معنایی دارد؟#
هیچ چیز عملی. ۱۰ تا ۱۵ توکن بر ثانیه یعنی این مدل نمیتواند جایگزین هیچ runtime واقعی شود. ارزش آن صرفاً مفهومی است: نشان میدهد که محاسبات دقیق (نه تقریبی) میتواند در داخل وزنهای یک مدل پیشآموزشدیده قرار بگیرد، بدون اینکه توانایی تولید متن مدل بهطور محسوس افت کند. اگر کسی دنبال «LLM که کد اجرا میکند» است، sandbox بیرونی هنوز ۱۰۰ برابر سریعتر و قابلاطمینانتر است. qwenGPU یک اثبات مفهوم است، نه ابزار.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.