

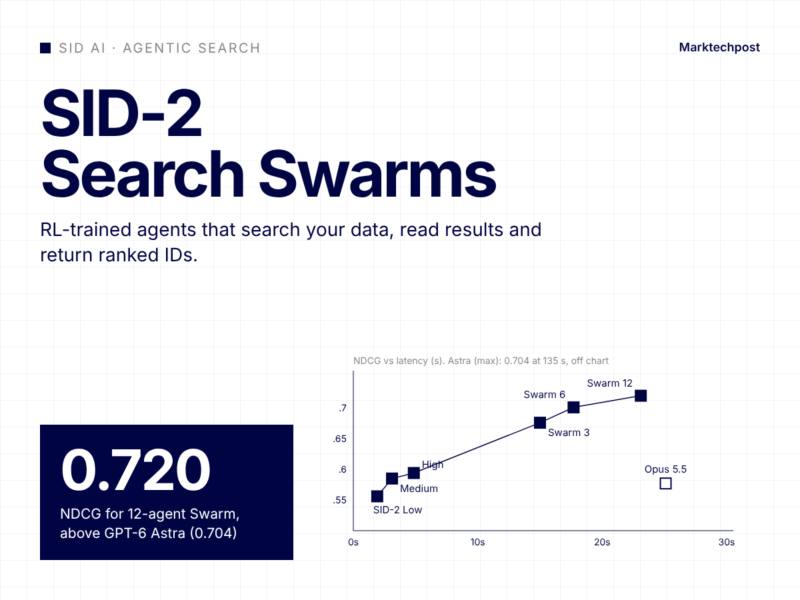


شرکت SID AI مدل جستوجوی عاملی نسل دوم خود را با نام SID-2 و نسخهی چندنمایندهی SID-2 Swarm منتشر کرد. SID-2 یک مدل تخصصی جستوجو است، نه یک چتبات عمومی؛ بهجای اجرای ثابت مراحل rewrite، embed، search و rerank، مدل خودش تصمیم میگیرد چه چیزی را بعداً جستوجو کند و در پایان هر اپیزود فهرست رتبهبندیشدهی شناسههای سند را برمیگرداند.
عملکرد در بنچمارک#
همهی اعداد زیر خودگزارششده از بنچمارک ۵۰۶ سؤالی SID در ۱۹ مجموعهداده (شامل HotpotQA، ایمیلهای Enron، SEC filings و PubMed) است. نسخهی Medium با ۰٫۵۸۵ NDCG در ۳٫۱۱ ثانیه، از Claude Opus 5.5 (۰٫۵۷۷ در ۲۵٫۱ ثانیه) جلوتر است. نسخهی Swarm با ۶ عامل ۰٫۷۰۱ و با ۱۲ عامل ۰٫۷۲۰ NDCG به دست میآورد. GPT-6 Astra در حالت max نمرهی ۰٫۷۰۴ دارد اما ۱۳۵ ثانیه زمان میبرد.
قیمت و دسترسی#
هزینهی SID-2 به ازای هر ۱۰۰۰ پرسش ۶٫۵۴ دلار و هزینهی Swarm با ۶ عامل ۲۶۳ دلار است. GPT-6 Astra برای همان ۱۰۰۰ پرسش ۲۱۴۱ دلار هزینه دارد. قیمت API: SID-2 با ۰٫۲۵ دلار ورودی و ۱٫۰۰ دلار خروجی به ازای هر میلیون توکن؛ Swarm با ۰٫۵۰ و ۲٫۰۰ دلار. پنجرهی بافتی ۲۶۲ هزار توکن اعلام شده (سایت ۲۵۶k نشان میدهد). مدل از طریق platform.sid.ai، Baseten و مسیر مرجع SageMaker در دسترس است. SDKها برای Python، TypeScript و Go منتشر شدهاند.
معماری Swarm و آموزش#
در حالت Swarm، چند عامل با هم پیامرسانی میکنند و بافت خود را به عوامل جدید منشعب میسازند؛ هر عامل بخش جداگانهای از مجموعهداده را کاوش میکند. SID استدلال میکند جستوجو بیشتر از خواندن اسناد بیشتر سود میبرد تا استدلال عمیقتر روی هر سند. آموزش دو مرحلهای RL انجام شده: مرحلهی اول کیفیت بازیابی، مرحلهی دوم جریمهی ضربدری تأخیر فقط روی پاداشهای مثبت.
تحلیل تحریریه#
این خبر برای کسی که همین حالا با RAG یا جستوجوی وکتوری سروکار دارد، یک سیگنال مهم است: مدلهای عاملی کوچک میتوانند از خطلولههای ثابت پیشی بگیرند و هزینهی عملیاتی را بهطور چشمگیری کاهش دهند. اما دو هشدار جدی وجود دارد. نخست، تمام اعداد خودگزارششدهاند — نه اندازهی پارامترها منتشر شده، نه وزنها در دسترساند و نه ارزیابی مستقلی انجام شده. دوم، در خود بنچمارک SID، نسخهی Swarm روی ۱۱ از ۱۹ مجموعهداده جلوتر است؛ یعنی روی California law، SEC filings و FiQA هنوز GPT-6 Astra برتری دارد. اگر دادههای شما در این حوزههاست، این مدل جایگزین فوری نیست. اما اگر مسئلهی شما جستوجوی اسناد داخلی با تأخیر پایین و بودجهی محدود است، عدد ۱۵ برابر اختلاف هزینه در برابر اختلاف نمرهی ۰٫۰۱۶، استدلال قانعکنندهای است.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.