

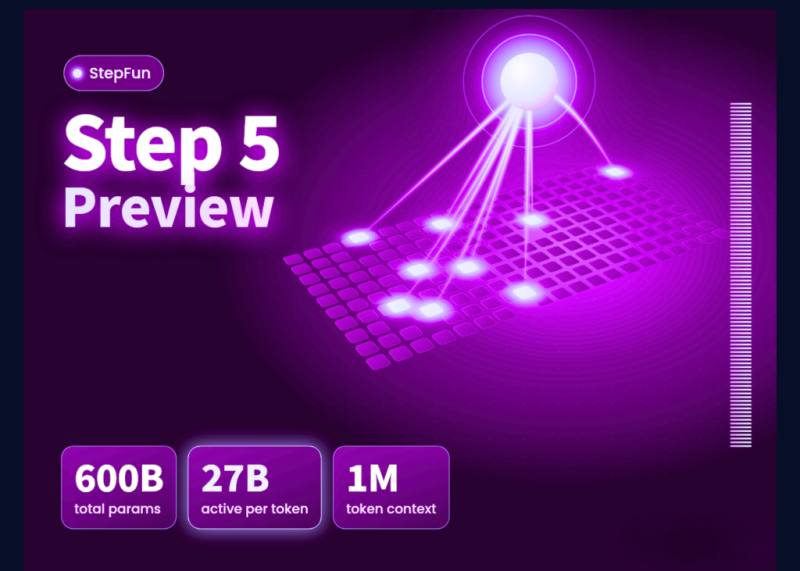
شرکت استپفان (StepFun) مدل جدید خود با نام Step 5 Preview را بهعنوان پرچمدار کارهای عاملمحور (Agentic) معرفی کرد. این مدل با معماری مخلوط متخصصان (MoE) ساخته شده و در مجموع ۶۰۰ میلیارد پارامتر دارد، اما در هر مرحله پردازش تنها حدود ۲۷ میلیارد پارامتر از آن فعال میشود. استپفان ادعا میکند که این مدل هوشمندی مشابه رقبا را با هزینهی کارکردی بهمراتب کمتر ارائه میدهد.
مشخصات فنی و معماری#
مدل Step 5 Preview از پنجرهی متنی ۱ میلیون توکن پشتیبانی میکند و میتواند ورودیهای متنی، تصویری و ویدیویی را پردازش کند. برخلاف رویهی معمول که شبکهها را پهنتر میکنند، استپفان از یک ساختار عمیق و باریک با ۹2 لایهی ترنسفورمر استفاده کرده تا مسیرهای استدلال چندمرحلهای طولانیتر شوند. این مدل برای کارهای طولانیمدت مانند جستجوی وب، اجرای کد و خواندن خروجی ابزارها بهینه شده است. استپفان گزارش داده که در یک آزمایش، این مدل توانسته ۹۵۰ درخواست وب را در یک اقدام عاملی هماهنگ کند.
قیمتگذاری و دسترسی#
در حال حاضر این مدل فقط از طریق API و پلتفرم استپفان در دسترس است. شرکت وعده داده که وزنهای باز (Open Weights) در تاریخ ۱۵ اکتبر ۲۰۲۶ منتشر خواهد شد. قیمتگذاری API برای هر میلیون توکن به شرح زیر است:
- ورودی (بدون کش): ۱ دلار
- ورودی (با کش): ۰.۰۵ دلار
- خروجی (شامل استدلال): ۲.۷۰ دلار
عملکرد در بنچمارکها#
بر اساس گزارشهای خودِ شرکت، این مدل در آزمونهای مالی و کدنویسی نمراتی نزدیک به GPT-6 Astra و Claude Opus 5 کسب کرده، هرچند در هر سه آزمون کدنویسی گزارششده، رقبا همچنان جلوتر بودند. اما یک چکبندی مستقل توسط پایگاه Artificial Analysis انجام شد که این مدل را در شاخص هوشمندی ۴۴ امتیاز داد؛ در حالی که میانهی امتیاز مدلهای مشابه در همان ردهی قیمتی ۲۴ است.
خوانش تحریریه: هزینهی پنهان استدلال طولانی#
اگرچه قیمت ۱ دلاری برای ورودی جذاب به نظر میرسد، اما گزارش Artificial Analysis هشداری مهم دارد: این مدل در آزمونها ۱۶۰ میلیون توکن خروجی تولید کرده در حالی که میانهی رقبا ۹۲ میلیون بوده است. این یعنی مدل برای رسیدن به پاسخ، «پرحرفی» میکند و هزینهی توکنهای خروجی میتواند صرفهجویی در ورودی را از بین ببرد. برای توسعهدهندگانی که نیاز به پاسخهای کوتاه و سریع دارند، این مدل ممکن است گرانتر از حد انتظار تمام شود. همچنین با توجه به نیاز به سختافزار چند GPU برای میزبانی محلی پس از انتشار وزنها، استفادهی عملی از این مدل در حال حاضر محدود به سرویسدهندهی ابری استپفان باقی میماند.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.