

#MoE
 خبر
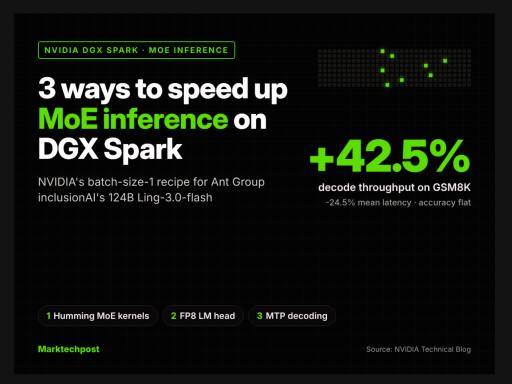
۴۲.۵ درصد افزایش سرعت استنتاج MoE روی DGX Spark با سه بهینهسازی انویدیا
انویدیا سه بهینهسازی را روی مدل MoE با ۱۲۴ میلیارد پارامتر در DGX Spark آزمایش کرد و سرعت استنتاج ۴۲.۵ درصد بالا رفت.
 خبر
Sterling: مدل ۳ میلیارد پارامتر فعال سامایا در پژوهش مالی، ۱۱ برابر ارزانتر از Claude Fable 5.1
سامایا AI مدل Sterling را منتشر کرد: یک ایجنت پژوهش مالی با ۳ میلیارد پارامتر فعال که در بنچمارک FrontierFinance از Claude Fable 5.1 پیشی…
 خبر
Prime Mega MoE: هستهی آموزشی ترکیبشدهای که زمان گامهای آموزش مدلهای MoE را تا ۵۵٪ کاهش میدهد
Prime Intellect هستهی Prime Mega MoE را منتشر کرد؛ پسگذر ترکیبشده برای DeepGEMM که زمان گامهای آموزش مدلهای Qwen3 MoE را تا ۵۵٪ کاهش…
 خبر
Kimi K3.1 Pro با قیمت API ارزانتر از نسخه قبل منتشر شد؛ وزنهای باز نوامبر ۲۰۲۶
Moonshot AI مدل Kimi K3.1 Pro را با ۲.۸ تریلیون پارامتر و قیمت API ۲/۱۰ دلار منتشر کرد. وزنهای باز نوامبر ۲۰۲۶ آزاد میشوند.
 خبر
MiniMax M3.1 Flash با قیمت ۰/۱۵ دلار در هر میلیون توکن ورودی منتشر شد
MiniMax مدل M3.1 Flash را با ۴۲۸ میلیارد پارامتر فعال ۲۳ میلیاردی، پنجره بافت یک میلیون توکنی و قیمت ۰/۱۵ دلار در هر میلیون توکن ورودی…
 خبر
Fish Audio مدل متنبهگفتار Drama 3 را با وزنهای باز و قابلیت کارگردانی احساسی منتشر کرد
Fish Audio مدل Drama 3 را منتشر کرد؛ یک مدل متنبهگفتار 35B با وزنهای باز، پشتیبانی از 83 زبان، دستورهای کارگردانی احساسی و سقف درآمد…
 خبر
Mellum2.1 جویتبرینز: مدل ۱۲ میلیارد پارامتری با ۲.۵ میلیارد فعال برای ایجنتهای کدنویسی
جویتبرینز مدل Mellum2.1 را با لایسنس Apache 2.0 منتشر کرد. این مدل MoE با ۲.۵ میلیارد پارامتر فعال، امتیاز SWE-bench Verified را از ۲.۰…
 خبر
Mistral Large 4 با ۱.۰۵ تریلیون پارامتر بهصورت پیشنمایش عمومی منتشر شد؛ وزنها تا پایان اکتبر در دسترس نیست
Mistral AI مدل Mistral Large 4 را با ۱.۰۵ تریلیون پارامتر، پنجره متنی ۱ میلیون توکن و قیمت ۱.۳۶ دلار بهازای هر میلیون توکن ورودی بهصورت…
 خبر
Beam با ۲۳ میلیارد پارامتر فعال، رقیب GLM 5.2 شد؛ وزنهای آن اواخر اکتبر منتشر میشود
Reflection AI نخستین مدل open-weight خود یعنی Beam را معرفی کرد؛ یک MoE با ۵۰۱ میلیارد پارامتر و ۲۳ میلیارد فعال برای کدنویسی و ایجنتها.
 خبر
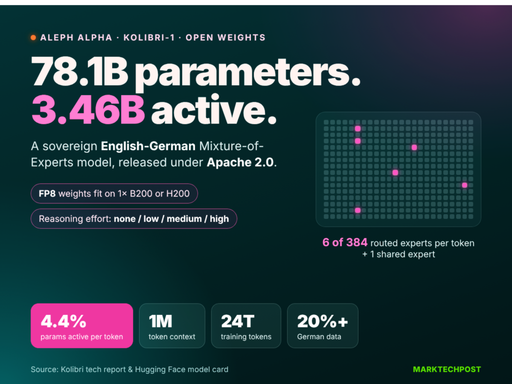
Kolibri: مدل ۷۸ میلیارد پارامتری Aleph Alpha که هر توکن فقط ۳.۴۶ میلیارد پارامتر فعال دارد
Aleph Alpha مدل Kolibri را با لایسنس Apache 2.0 منتشر کرد: ۷۸.۱ میلیارد پارامتر، فقط ۳.۴۶ میلیارد فعال، پنجره ۱ میلیون توکنی، دوزبانه…
 خبر
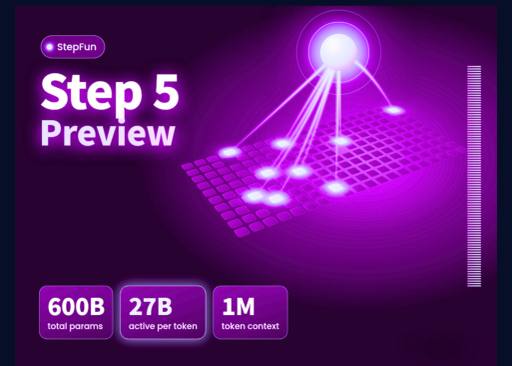
استپفان مدل Step 5 Preview را معرفی کرد؛ ۶۰۰ میلیارد پارامتر با قیمت ورودی ۱ دلار
استپفان مدل جدید خود را برای کارهای عاملمحور با ۶۰۰ میلیارد پارامتر، پنجرهی متنی ۱ میلیون توکن و قیمت ورودی ۱ دلار به ازای هر میلیون…