

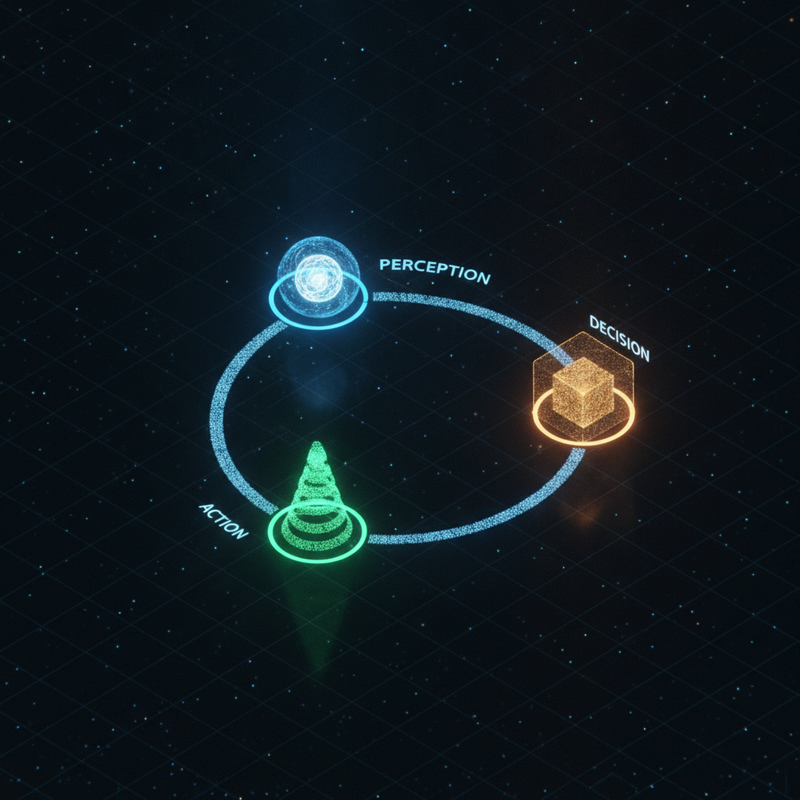

اگر چیزی که میسازید مسیر اجرا از پیشتعریفشده دارد و گام بعدی به نتیجهی گام قبلی بستگی ندارد، ایجنت هوش مصنوعی (AI Agent) گزینهی اشتباه است. انتخاب نادرست معماری، هزینهی توکن، تأخیر و عدمقطعیت خروجی میسازد. این مقاله مرز عملی بین ایجنت و workflow را مشخص میکند و معماری واقعی حلقهی تصمیمگیری را باز میکند.
ایجنت هوش مصنوعی چیست و چه فرقی با چتبات و اتوماسیون دارد؟#
ایجنت هوش مصنوعی سامانهای خودمختار است که در حلقهی تکرارشوندهی ادراک، تصمیم و عمل کار میکند. برخلاف چتبات که خروجیاش صرفاً متن است و برخلاف workflow که مسیرش از پیش ثابت است، ایجنت در زمان اجرا تصمیم میگیرد کدام ابزار صدا زده شود و آیا به پاسخ رسیده یا نه.
تمایز سهگانه را اینطور ببینید: چتبات ورودی متنی میگیرد و خروجی متنی میدهد. workflow یک DAG (Directed Acyclic Graph) از گرههاست که مسیرش در طراحی مشخص شده. ایجنت مسیر را در زمان اجرا میسازد. این تفاوت ظاهری کوچک، پیامدهای مهندسی بزرگی دارد: ایجنت قابلپیشبینی نیست، هزینهاش متغیر است، و دیباگش پیچیدهتر.
ایجنت لایهی تصمیمگیری است، نه لایهی اجرا. ایجنت تصمیم میگیرد «کدام ابزار» و «بهچه ترتیب» صدا زده شود؛ خودِ ابزارها کار را انجام میدهند. این تفکیک مسئولیت، کلید فهم معماری ایجنت است.
مثال عملی: ایجنتی که یک فایل CSV دریافت میکند. ابتدا ستونها را بررسی میکند، الگوی داده را شناسایی میکند، و سپس بر اساس آنچه فهمیده تصمیم میگیرد نمودار بکشد یا گزارش متنی بنویسد یا هر دو. این تصمیم در زمان اجرا گرفته میشود و از پیش قابلکدنویسی نیست.
یک اشتباه پرهزینه که در کلاسها و پروژههای اولیهی اعضای کامیونیتی مکرر دیده میشود: ساخت ایجنت برای کاری که یک تابع دهخطی با سه شرط if-else انجام میدهد. نتیجهاش؟ هزینهی توکن بدون بهبود کیفیت.
- چتبات: ورودی ← خروجی متنی. بدون اقدام روی محیط.
- Workflow: مسیر ثابت، ورودی ساختارمند، خروجی قابلپیشبینی.
- ایجنت: مسیر در زمان اجرا تعیین میشود، اقدام واقعی روی محیط، خروجی غیرقطعی.
معماری ایجنت: حلقهی ادراک-تصمیم-عمل#
معماری ایجنت هوش مصنوعی از سه جزء اصلی ساخته شده: حافظه (Memory) برای نگهداشتن زمینه، برنامهریزی (Planning) برای تعیین گام بعدی، و استفاده از ابزار (Tool Use) برای اجرای تصمیم. این سه جزء در یک حلقهی تکرارشونده قرار میگیرند تا ایجنت از ورودی اولیه به خروجی نهایی برسد.
ساختار حلقه به این ترتیب است: دریافت ورودی ← استدلال دربارهی وضعیت فعلی ← انتخاب ابزار یا اقدام ← اجرای ابزار ← ارزیابی نتیجه ← تکرار یا توقف. هر دور این حلقه یک فراخوانی API به مدل زبانی است. یعنی یک ایجنت پنجمرحلهای حداقل پنج فراخوانی مدل مصرف میکند، بدون احتساب فراخوانیهای ابزار.
مهمترین جزء معماری که اغلب نادیده گرفته میشود، شرط توقف (Termination Condition) است. بدون آن، حلقه بیپایان میماند و بودجهی توکن تا صفر مصرف میشود. در پروژههای واقعی، حلقهی بیپایان رایجترین دلیل فاکتورهای نجومی است.
شبهکد ساختار حلقه:
max_steps = 10
for step in range(max_steps):
thought = llm.reason(context, tools)
if thought.is_final_answer:
return thought.answer
action = thought.selected_tool
result = execute(action)
context.append(result)
return "max steps reached"
نقش مدل زبانی در حلقه — چرا هر مرحله یک فراخوانی API است#
مدل زبانی (Large Language Model) در حلقهی ایجنت نقش مغز تصمیمگیری را دارد. هر مرحلهی استدلال یک فراخوانی API جداگانه است. این یعنی تأخیر و هزینه بهطور خطی با تعداد مراحل رشد میکند. اگر ایجنت شما ده مرحله استدلال دارد، ده فراخوانی API دارید — هر کدام با توکنهای ورودی و خروجی خودش.
نکتهی عملی: context window در هر مرحله بزرگتر میشود چون نتایج مراحل قبلی به ورودی اضافه میشوند. این یعنی مرحلهی دهم گرانتر از مرحلهی اول است. در پروژههای واقعی، مصرف توکن مرحلهی آخر میتواند چند برابر مرحلهی اول باشد. الگویی که در پروژههای اعضای کامیونیتی تکرار میشود: ایجنتهایی که در سه مرحلهی اول خوب کار میکنند و از مرحلهی چهارم بهبعد فقط توکن میسوزانند.
ساختار پوشهی پیشنهادی برای پروژهی ایجنت#
ساختار پوشهی پروژهی ایجنت باید مرز بین لایهی تصمیم و لایهی اجرا را بازتاب دهد:
agent_project/
├── core/
│ ├── loop.py # حلقهی اصلی ادراک-تصمیم-عمل
│ ├── termination.py # شرطهای توقف
│ └── budget.py # مدیریت توکن و هزینه
├── tools/
│ ├── base.py # اینترفیس ابزار
│ ├── search.py
│ └── code_exec.py
├── memory/
│ ├── short_term.py # context window
│ └── long_term.py # کش یا پایگاهداده
├── prompts/
│ └── system.txt
├── config.yaml # max_steps، مدل، بودجه
└── tests/
الگوهای برنامهریزی: از ReAct تا Plan-and-Execute#
الگوهای برنامهریزی ایجنت هوش مصنوعی تعیین میکنند حلقهی تصمیمگیری چگونه ساختار یابد. ReAct استدلال و عمل را در یک حلقهی واحد ترکیب میکند، Plan-and-Execute ابتدا کل مسیر را میچیند و سپس اجرا میکند، و Reflexion نتیجهی هر مرحله را نقد و اصلاح میکند.
ReAct (Reasoning and Acting) الگویی است که توسط Shunyu Yao و همکاران در سال 2022 معرفی شد (arXiv:2210.03629). هر مرحله شامل سه بخش است: Thought (استدلال دربارهی وضعیت)، Action (انتخاب و اجرای ابزار)، Observation (مشاهدهی نتیجه). این الگو سادهترین و رایجترین الگوی ایجنتی است.
Plan-and-Execute مناسب کارهایی است که ساختار کلی از پیش قابلتعیین دارند اما جزئیات هر گام متغیر است. ابتدا یک پلن کامل ساخته میشود، سپس هر گام جداگانه اجرا میشود. مزیتش این است که اگر گامی شکست بخورد، فقط همان گام تکرار میشود نه کل حلقه.
Reflexion حلقهی خودارزیابی اضافه میکند. ایجنت پس از هر تلاش، نتیجه را نقد میکند و استراتژی بعدی را اصلاح میکند. این الگو هزینهی توکن را افزایش میدهد اما نرخ موفقیت را بالا میبرد.
Tree of Thoughts (ToT) اکتشاف موازی چند مسیر استدلالی است. مناسب مسائل پیچیده با فضای جستوجوی بزرگ. هزینهی محاسباتیاش چند برابر ReAct است. در عمل، ToT را کمتر از آنچه مقالات آکادمیک نشان میدهند در پروژههای واقعی میبینید؛ پیچیدگی پیادهسازیاش برای بیشتر تیمها توجیه اقتصادی ندارد.
کدام الگو برای چه مسئلهای مناسب است؟#
| الگو | پیچیدگی | هزینهی توکن | مناسب برای |
|---|---|---|---|
| ReAct | کم | متوسط | کارهای تکمنظوره با ابزارهای محدود |
| Plan-and-Execute | متوسط | متوسط | مسائل با ساختار از پیش قابلتعیین |
| Reflexion | متوسط | بالا | مسائلی که نیاز به اصلاح خودکار دارند |
| Tree of Thoughts | بالا | خیلی بالا | مسائل پیچیده با فضای جستوجوی گسترده |
ترکیب الگوها در عمل — چرا معمولاً یک الگوی خالص کافی نیست#
در پروژههای واقعی، ایجنتها معمولاً ترکیبی از چند الگو هستند. مثلاً Plan-and-Execute برای ساختار کلی، ReAct برای هر گام، و Reflexion برای بازبینی نهایی. این ترکیب هزینهی توکن را بالا میبرد اما نرخ موفقیت را بهبود میدهد. معیار تصمیم: اگر نرخ شکست ایجنتتان در تولید بالاست، یک لایهی بازبینی اضافه کنید. اگر هزینهی توکن مشکلساز شده، حلقههای اضافی را حذف کنید.
الگویی که در پروژههای اعضای کامیونیتی بارها تکرار شده: تیمی که با ReAct شروع میکند، در محیط تولید نرخ شکستاش بالا میرود، Reflexion اضافه میکند، و بعد از دو هفته فاکتور API دو برابر میشود. راهحل میانه: فقط روی خروجی نهایی یک بازبینی سبک انجام دهید، نه روی هر مرحله.
حافظهی ایجنت: چرا Vector DB همیشه لازم نیست#
حافظهی ایجنت هوش مصنوعی دو نوع دارد: کوتاهمدت که همان context window مدل است و بلندمدت که میتواند کش ساده، جدول relational یا پایگاهدادهی برداری (Vector DB) باشد. انتخاب نوع حافظه به الگوی بازیابی بستگی دارد، نه به ترند.
حافظهی کوتاهمدت (Short-term Memory) محدود به context window مدل است. ارزان، سریع، اما فرار. با هر فراخوانی API، محتوای آن عوض میشود. اگر ایجنت شما در یک نشست (Session) کار میکند و نیاز به بازیابی از گذشته ندارد، همین کافی است.
حافظهی بلندمدت سه سطح دارد: کش درونپروسهای (dict ساده)، جدول ساختارمند (SQL)، و پایگاهدادهی برداری. اشتباه رایج این است که فرض میشود هر ایجنتی به Vector DB نیاز دارد. اگر بازیابی بر اساس کلید دقیق است — مثلاً «نتیجهی اجرا با ID فلان» — یک dict ساده یا جدول SQL کافی و بهینهتر است.
Vector DB واقعاً لازم است وقتی بازیابی بر اساس شباهت معنایی (Semantic Similarity) است نه تطبیق کلیدی. مثلاً ایجنتی که باید از میان صدها سند، نزدیکترین سند به سؤال کاربر را پیدا کند.
موضع صریح: اضافه کردن Vector DB به ایجنتی که فقط چند نتیجهی قبلی را با ID بازیابی میکند، نهتنها بیفایده بلکه مضر است. یک لایهی embedding و یک سرویس جانبی اضافه میکنید که هیچکدام در حلقهی تصمیمگیری نقشی ندارند.
الگوی مدیریت حافظه در LangChain و LlamaIndex#
LangChain مفهوم ConversationBufferMemory و ConversationSummaryMemory را ارائه میدهد. اولی تمام تاریخچه را نگه میدارد (ساده اما گران)، دومی خلاصهسازی میکند (ارزانتر اما با از دست رفتن جزئیات). LlamaIndex بیشتر بر Retrieval-Augmented Generation (RAG) تمرکز دارد و حافظهی بلندمدتش معمولاً Vector DB است. اگر دادهی ساختارمند دارید، LlamaIndex ابزار بهتری است؛ اگر گفتوگوی چندمرحلهای دارید، LangChain انعطاف بیشتری میدهد.
چه زمانی ایجنت گزینهی اشتباه است؟#
ایجنت گزینهی اشتباه است وقتی مسیر اجرا از پیش قابلتعیین است، ورودی ساختارمند است و خروجی باید قابلپیشبینی باشد. در این شرایط، workflow ساده هم ارزانتر است هم قابلاتکاتر. ایجنت فقط جایی لازم است که تصمیمگیری در زمان اجرا بر اساس شرایط متغیر نیاز باشد.
Anthropic در راهنمای Building Effective Agents تمایز روشنی بین Workflow و Agent قائل شده و توصیه میکند ابتدا Workflow را امتحان کنید و فقط وقتی نیاز به تصمیمگیری در زمان اجرا دارید، به سراغ Agent بروید. این توصیه از یک شرکت که خودش مدلهای زبانی میسازد و ایجنتهای تجاری دارد، وزن بالایی دارد.
سه نشانهی اینکه به ایجنت نیاز ندارید:
- ورودی ثابت یا با تنوع بسیار کم است.
- مسیر اجرا از پیش مشخص است و به نتیجهی گام قبلی بستگی ندارد.
- خطاپذیری صفر لازم است — ایجنت ذاتاً غیرقطعی است.
هزینهی پنهان ایجنت در مقابل workflow: مصرف توکن چند برابر، تأخیر بالاتر (چون چند فراخوانی API در حلقه)، و عدمقطعیت خروجی. اگر یک workflow دهخطی همان کار را میکند، ایجنتسازی آن یک اشتباه مهندسی است.
الگوی ترکیبی — workflow با ایجنت در گرههای تصمیمگیری#
بهترین الگوی عملی: workflow بهعنوان اسکلت اصلی، ایجنت فقط در گرههایی که نیاز به تصمیمگیری دارند. مثلاً یک workflow که داده را از API میگیرد، پاکسازی میکند، و سپس در یک گره خاص، ایجنت تصمیم میگیرد کدام گزارش تولید شود. بقیهی مسیر ثابت است. این الگوی ترکیبی، مزایای هر دو را میدهد: قابلیتپیشبینی workflow و انعطاف ایجنت در نقاط واقعی تصمیم.
در پروژههای اعضای کامیونیتی که با n8n کار میکنند، این الگو بارها دیده شده: چند گرهی ساده برای fetch و transform، و یک گرهی ایجنت فقط در نقطهای که واقعاً «بستگی به نتیجهی قبلی دارد».
فریمورکهای ساخت ایجنت: مقایسهی عملی LangChain، CrewAI و AutoGen#
فریمورکهای ساخت ایجنت هوش مصنوعی هر کدام فلسفهی متفاوتی دارند. LangChain انعطافپذیرترین و پرکاربردترین است اما لایهی انتزاعی سنگینی دارد. CrewAI برای سناریوهای چندایجنتی با نقشهای مشخص طراحی شده. AutoGen بر گفتوگوی بین ایجنتها تمرکز دارد.
LangChain توسط Harrison Chase در اکتبر 2022 منتشر شد. اکوسیستم بزرگی دارد اما API بین نسخهها ناپایدار است. مناسب پروتوتایپ سریع و پروژههایی که به ترکیب ابزارهای مختلف نیاز دارند.
CrewAI مدل نقشمحور (Role-based) دارد. هر ایجنت یک نقش و هدف مشخص دارد و بهصورت تیمی کار میکند. مناسب جریانهای کاری که ذاتاً چندنقشی هستند.
AutoGen توسط Microsoft ساخته شده و تمرکزش بر گفتوگوی چندطرفه بین ایجنتهاست. مناسب سناریوهای پژوهشی و کدنویسی که ایجنتها باید با هم مذاکره کنند.
مقایسهی جدولی فریمورکها#
| فریمورک | پیچیدگی یادگیری | پایداری API | مناسب برای |
|---|---|---|---|
| LangChain | متوسط | ضعیف | پروتوتایپ، ترکیب ابزارها |
| CrewAI | کم | متوسط | سناریوهای نقشمحور تیمی |
| AutoGen | متوسط | متوسط | گفتوگوی بین ایجنتها، پژوهش |
| LlamaIndex Agents | کم | متوسط | ایجنتهای دادهمحور و RAG |
معیار انتخاب: بلوغ API، پایداری بین نسخهها، و همراستایی با معماری پروژه. تعداد ستارهی GitHub معیار خوبی نیست. یک فریمورک با API ناپایدار، هزینهی نگهداری (Maintenance) بالایی در تولید ایجاد میکند. LangChain در نسخههای 0.1 به بعد بارها API را شکست؛ اگر پروژهی بلندمدت میسازید، این ریسک را جدی بگیرید.
هزینه، دیباگ و اشتباهات رایج ساخت ایجنت#
رایجترین اشتباهات در ساخت ایجنت هوش مصنوعی سه موردند: حلقهی بیپایان بدون شرط توقف، اعتبارسنجی نکردن خروجی ابزار، و مصرف بیرویهی توکن در مراحل غیرضروری. هر سه قابلپیشگیریاند اگر از ابتدا طراحی شوند.
الگوی شکست «حلقهی بیپایان»: ایجنت بدون max_steps و بدون بررسی «آیا به پاسخ رسیدم؟» تا اتمام بودجه ادامه میدهد. راهحل: شرط توقف صریح + حداکثر تعداد مراحل + اعتبارسنجی خروجی هر ابزار قبل از ورود به مرحلهی بعد.
اشتباه رایج دیگر: «هرچه مراحل بیشتر، ایجنت بهتر». هر مرحلهی اضافی یک نقطهی شکست و هزینهی توکن اضافه است. ایجنت با سه مرحلهی درست، بهتر از ایجنت با ده مرحلهی نامنظم عمل میکند.
در مورد AutoGPT: این پروژه در عمل بهندرت قابلاتکا است و حلقههای بیپایان زیادی تولید میکند. اگر جایی توصیهی AutoGPT برای پروژهی تولیدی دیدید، با احتیاط برخورد کنید.
استراتژی دیباگ — لاگگیری مرحلهبهمرحله و بازپخش#
دیباگ ایجنت بدون لاگگیری مرحلهبهمرحله عملاً غیرممکن است. برای هر iteration باید ورودی، خروجی و تصمیم لاگ شود. ابزارهایی مثل LangSmith یا لاگهای سفارشی JSON به شما اجازه میدهند مسیر تصمیمگیری ایجنت را بازپخش (Replay) کنید و نقطهی خطا را پیدا کنید.
ساختار لاگ پیشنهادی:
{
"step": 3,
"input_context": "...",
"thought": "...",
"action": "search",
"tool_output": "...",
"tokens_used": 1200,
"timestamp": "..."
}
ابزارهای مانیتورینگ برای ایجنتهای تولیدی#
در محیط تولید، سه متریک کلیدی را مانیتور کنید: تعداد متوسط مراحل هر اجرا (اگر رو به افزایش است، ایجنت در حلقه گیر کرده)، هزینهی توکن هر اجرا (برای بودجهبندی)، و نرخ موفقیت (نسبت اجراهایی که به پاسخ رسیدهاند). اگر نرخ موفقیت زیر حد قابلقبول است، مشکل از الگوی برنامهریزی است نه از مدل.
سیستمهای چندایجنتی: چه زمانی یک ایجنت کافی نیست؟#
سیستم چندایجنتی (Multi-Agent System) منطقی است وقتی مسئله نیاز به تفکیک مسئولیتهای تخصصی دارد — مثلاً یک ایجنت کد بنویسد، دیگری تست کند، سومی بازبینی کند — یا وقتی حجم کار با یک context window قابلمدیریت نیست.
الگوهای تعامل سه نوعاند: ترتیبی (Sequential) که ایجنتها پشت سر هم کار میکنند، موازی (Parallel) که همزمان اجرا میشوند و نتایجشان ترکیب میشود، و سلسلهمراتبی (Hierarchical) که یک ایجنت مدیر، کار را بین ایجنتهای زیرمجموعه تقسیم میکند.
معیار ورود به چندایجنتی: آیا یک ایجنت با ابزارهای کافی نمیتواند کار را انجام دهد؟ اگر میتواند، چندایجنتی فقط پیچیدگی اضافه است. هر ایجنت جداگانه توکن مصرف میکند و هماهنگی بین آنها خود یک مسئلهی مهندسی است.
مثال واقعی: ایجنت پژوهشگر + ایجنت نویسنده + ایجنت ویرایشگر در مقابل یک ایجنت با سه ابزار. اگر یک ایجنت با ابزارهای search، write، و edit همان نتیجه را میدهد، چندایجنتی هزینهی توکن سهبرابر و تأخیر بیشتر میسازد بدون بهبود کیفیت. موضع روشن: بیشتر تیمهایی که سراغ چندایجنتی میروند، در واقع مشکلشان را با یک ایجنت خوبتر حل میکردند.
جمعبندی عملی: ایجنت هوش مصنوعی یک ابزار قدرتمند است، نه یک الگوی پیشفرض. قبل از انتخاب معماری، از خود بپرسید آیا واقعاً به تصمیمگیری در زمان اجرا نیاز دارید یا یک workflow سادهتر و قابلاتکاتر همان کار را میکند. اگر ایجنت لازم است، با حلقهی ساده شروع کنید، شرط توقف بگذارید، و فقط در صورت نیاز پیچیدگی اضافه کنید.
اگر میخواهید ایجنتها را در عمل بسازید و با n8n به نتیجهی قابلاستفاده برسید، دورهی ساخت Ai Agent با N8N در کامیونیتی اسکول دقیقاً همین مسیر را پوشش میدهد — از صفر تا ایجنتی که واقعاً کار میکند.




دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.