

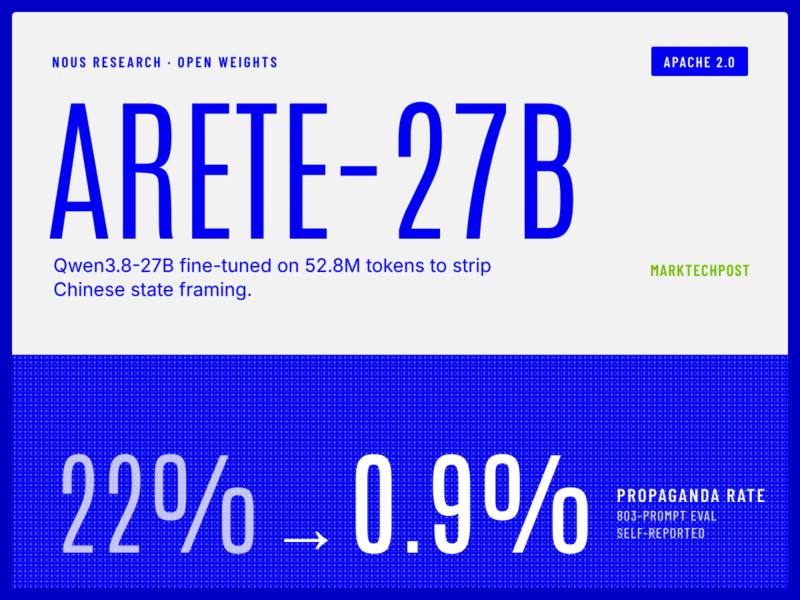


Nous Research مدل Arete-27B را منتشر کرد — یک supervised fine-tune روی Qwen3.8-27B که هدفش حذف چارچوببندی دولتی چین از پاسخهای مدل است. در ارزیابی ۸۰۳ پرامپتی خودِ Nous، سهم پاسخهای حاوی پروپاگاندا از ۲۲٪ به ۰.۹٪ رسید. وزنها، دادههای آموزشی و مجموعهی ارزیابی همگی عمومیاند.
روش آموزش#
Nous تأکید میکند که فقط SFT انجام شده — بدون RL، بدون preference optimization و بدون تغییر معماری. مدل معلم، Inkling از Thinking Machines بود. Nemotron 3 Ultra به دلیل سوابق نامطمئن در موضوعات مرتبط با چین کنار گذاشته شد. آموزش روی حدود ۵۲.۸ میلیون توکن در context طول 64k انجام گرفت: ۲ epoch، ۱,۲۰۲ گام، batch size برابر ۴۸، optimizer از نوع AdamW با نرخ یادگیری اوج 1e-5 و tensor parallel 4.
مقایسه با رقبا#
در ارزیابی Nous، میانگین امتیاز حقایق Arete-27B از ۲.۳۲ به ۲.۹۸ رسید، اما همچنان از Muse Glimmer 30B (۳.۰۲) پایینتر است. در دستهی آزادی بیان، امتیاز حقایق از ۰.۸۹ به ۲.۴۴ و نرخ پروپاگاندا از ۶۰٪ به ۱٪ تغییر کرد. Hermes Bench بدون تغییر ماند (۶۵.۷۷٪ به ۶۵.۶۰٪). Terminal-Bench-2.1 از ۶۷٪ به ۷۰٪ رسید، هرچند Nous مدعی نیست این بهبود از SFT آمده است.
دسترسی و اجرا#
وزنهای BF16 حدود ۵۳.۸۱ گیگابایتاند. یک quant Q4_K_M جامعهمحور با حجم ۱۷.۲۰ گیگابایت برای GPUهای مصرفی ۲۴ گیگابایتی مناسب است. هنوز هیچ سرویس inference میزبانمحور این مدل را ارائه نمیدهد. نسخههای GGUF در llama.cpp، LM Studio و Ollama قابل اجرا هستند. لایسنس Apache 2.0 است.
این خبر برای سازندگان ایجنت چه معنایی دارد#
پیام عملی این است که حذف چارچوببندی سیاسی از یک مدل ۲۷B با فقط ۵۲.۸ میلیون توکن SFT و بدون RL ممکن است — هزینهی محاسباتی ناچیز. اما این به معنای حل مشکل نیست. ۲۱۶ پاسخ از ۸۰۳ هنوز صفر گرفتهاند و امتیاز حقایق ۲.۹۸ از ۵ یعنی مدل هنوز در بازگویی حقایق مشخص ضعف دارد. برای کسی که Qwen را در خط تولید ایجنتی استفاده میکند، Arete یک لایهی اطمینان بیشتر است، نه جایگزین بازبینی خروجی. محدودیت اصلی فعلی هم این است که هیچ سرویس ابری آن را ارائه نمیدهد؛ یعنی اگر میخواهید همین امروز استفاده کنید، باید خودتان GPU بخرید یا GGUF را محلی اجرا کنید.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.