

#Qwen
 خبر
QwenGyre: چارچوب RL تیم Qwen با ۱٫۸۵ برابر سرعت بیشتر برای آموزش ایجنتهای کدنویس در مقیاس ۷۰۰ هزار توکن
تیم Qwen علیبابا چارچوب QwenGyre را معرفی کرد: RL الاستیک برای آموزش ایجنتهای کدنویس با رولاوتهای ۷۰۰ هزار توکنی و سرعت تا ۱٫۸۵ برابر…
 خبر
مدل تصمیمگیری ۹ میلیاردی Decision 3.0 از نسل قبلی ۲۷ میلیاردی پیشی میگیرد
تیم vLLM Semantic Router خانواده مدلهای Decision 3.0 را منتشر کرد؛ پنج مدل ۰.۸ تا ۲۷ میلیارد پارامتر با مجوز Apache-2.0 که ورودی متن،…
 خبر
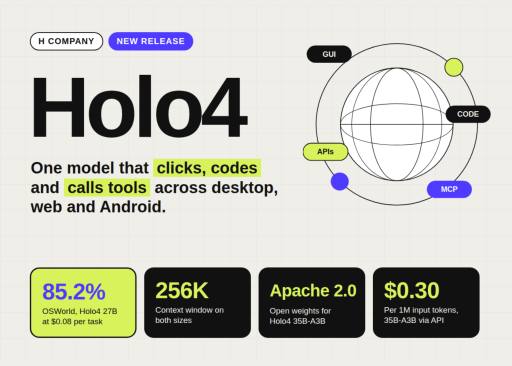
Holo4: مدلهای بازِ استفاده از کامپیوتر با لایسنس دوگانه؛ ۳۵B تجاری، ۲۷B فقط غیرتجاری
H Company دو مدل Holo4 با ۲۵۶K کانتکست منتشر کرد. نسخه ۳۵B-A3B با Apache 2.0 قابل استفاده تجاری است، اما ۲۷B فقط غیرتجاری.
 خبر
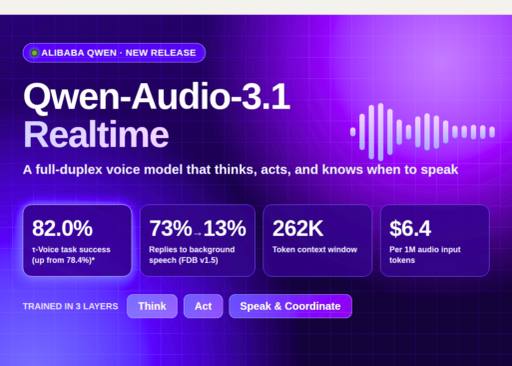
Qwen-Audio-3.1-Realtime با قیمت ۶/۴ دلار در هر میلیون توکن صوتی عرضه شد؛ کاهش ۸۵ درصدی
تیم Qwen علیبابا مدل صوتی تمامدوقلوی Qwen-Audio-3.1-Realtime را با کاهش ۸۵ درصدی قیمت و بافت ۲۶۲K توکن روی QwenCloud عرضه کرد.
 خبر
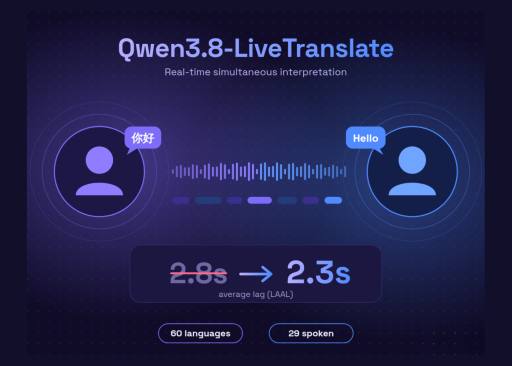
Qwen3.8-LiveTranslate: ترجمه همزمان با تأخیر ۲.۳ ثانیه و پشتیبانی از ۶۰ زبان
مدل جدید Qwen3.8-LiveTranslate با معماری Interleave و تأخیر میانگین ۲.۳ ثانیه، امکان ترجمه همزمان و تشخیص گوینده را در ۶۰ زبان فراهم میکند.
 خبر
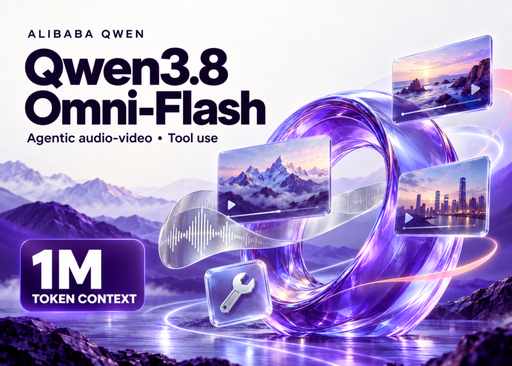
Qwen3.8-Omni-Flash؛ مدل چندوجهی Qwen با درک عاملمحور ویدئو و ۴۵٪ کاهش مصرف توکن
تیم Qwen علیبابا مدل Qwen3.8-Omni-Flash را منتشر کرد: چندوجهی، عاملمحور، با ۴۵٪ کاهش توکن در درک ویدئو. در دسترس فقط از طریق API.
 خبر
مدل استنتاجی کوچک PrismML با فشردهسازی ۹ برابری Qwen منتشر شد
استارتاپ PrismML مدل جدید Bonsai 2 را معرفی کرد که نسخه ۲۷ میلیارد پارامتری Qwen را با حفظ ۹۸ درصد عملکرد، فشرده کرده است.