

تیم پژوهش کاربردی نوشیا (Nokia) کتابخانه پایتون AnyJev را بهصورت متنباز منتشر کرد. این ابزار بدون نیاز به هیچگونه آموزش مجدد (Training-Free)، مدلهای زبانی باز را به مدلهای تصمیمگیری کالیبره تبدیل میکند. هدف اصلی این کتابخانه، انجام وظایف رایج در محیطهای عملیاتی مانند انتخاب یک پاسخ از بین مجموعهای از گزینههای از پیش تعیینشده است.
AnyJev از رابط کاربری Jev (مدل تصمیمگیری سیستم یک که توسط TypeSafe AI در سپتامبر ۲۰۲۶ راهاندازی شده بود) الهام گرفته است. کاربر با ارائه یک پرسش تایپشده، یک تصمیم همراه با احتمال دریافت میکند که این احتمال مستقیماً از توزیع توکن بعدی مدل خوانده میشود؛ به این معنی که هیچ متنی تولید یا پارس نمیشود. این کتابخانه سه نوع پرسش را پشتیبانی میکند: انتخاب از بین K گزینه، پرسش بله/خیر، و امتیازدهی در سطلهای مرتبشده.
حل مشکل سوگیری در خوانش مستقیم Logit#
در روشهای قبلی که مستقیماً توکن بعدی را محدود به برچسبهای گزینهها میکردند، دو مشکل اصلی وجود داشت: تغییر پاسخ با جابهجایی ترتیب گزینهها و عدم کالیبراسیون احتمالات. AnyJev با دو لایه اصلاحی به نام L0 و L1 این مشکلات را برطرف میکند. لایه L0 (پیشفرض) از دو تکنیک استفاده میکند: «چرخشهای دوری» (Cyclic Shifts) که باعث میشود هر گزینه در تمام موقعیتهای ممکن نمایش داده شود تا سوگیری موقعیت حذف گردد، و «تصحیح پیشین» (Prior Correction) که میانگین متحرک توزیعهای پیشبینیشده را نگه میدارد تا سوگیری برچسب اصلاح شود.
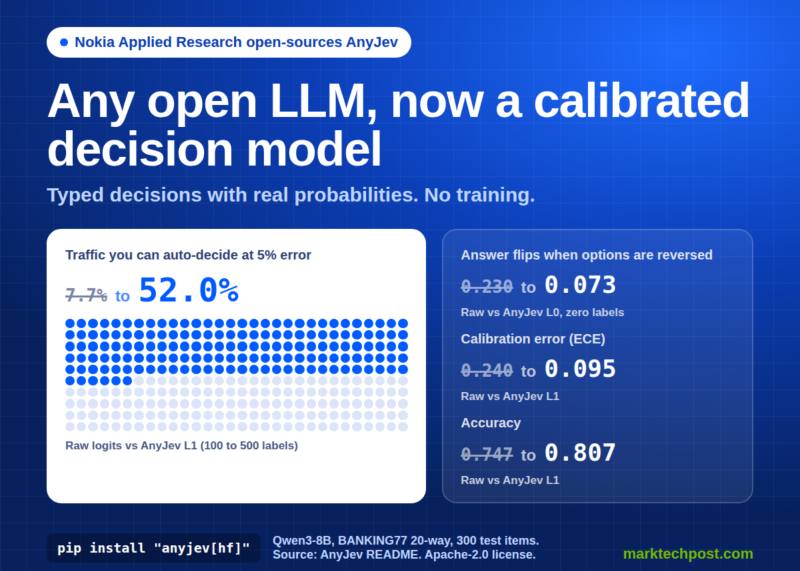
نتایج بنچمارک روی مدل Qwen3-8B در دیتاست BANKING77 نشان میدهد که استفاده از AnyJev L0 نرخ تغییر پاسخ با جابهجایی گزینهها را از 0.230 به 0.073 کاهش میدهد. همچنین دقت از 0.747 به 0.803 و خطای کالیبراسیون (ECE) از 0.240 به 0.184 بهبود یافته است. با فعالسازی لایه L1 که نیازمند 100 تا 500 برچسب است، دقت به 0.807 و ECE به 0.095 میرسد. نکته مهم این است که سهم ترافیک قابل تصمیمگیری خودکار با خطای ۵ درصدی از 7.7 درصد در روش خام، با استفاده از L1 به 52.0 درصد افزایش مییابد.
تحلیل: چه چیزی برای توسعهدهندگان ایجنت تغییر میکند؟#
انتشار AnyJev برای مهندسانی که ایجنتهای هوش مصنوعی میسازند، یک گام عملی برای کاهش هزینه و پیچیدگی است. تا پیش از این، برای داشتن یک مدل تصمیمگیر مطمئن و کالیبره، یا باید مدلهای کوچکتر را فاینتون میکردید یا از مدلهای گرانقیمت API استفاده مینمودید. AnyJev اجازه میدهد از مدلهای باز موجود (مانند Qwen یا Llama) استفاده کنید و با اضافه کردن این لایه، اطمینان یابید که خروجی مدل بهخاطر ترتیب کلمات در پرامپت تغییر نمیکند. این خبر برای کسانی که در حال ساخت سیستمهای روتینگ یا دستهبندی خودکار هستند، یعنی امکان افزایش چشمگیر نرخ تصمیمگیری خودکار بدون نیاز به جمعآوری دادههای عظیم یا آموزش مجدد مدل. با این حال، توجه داشته باشید که این ابزار همچنان به مدلهای زبانی قدرتمند نیاز دارد و در شرایطی که نیاز به استدلال پیچیده چندمرحلهای است، جایگزین روشهای Chain-of-Thought نخواهد بود.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.