

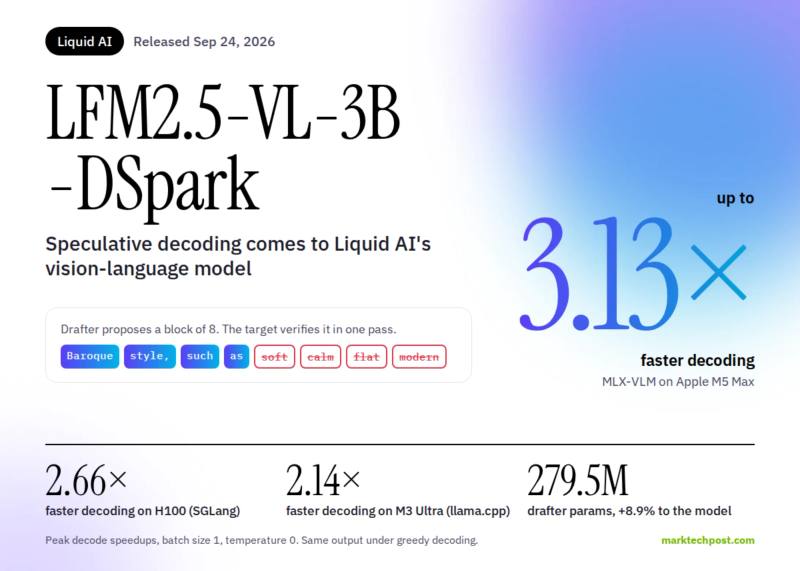
شرکت Liquid AI مدل LFM2.5-VL-3B-DSpark را بهعنوان یک مدل پیشنویس (Drafter) آزمایشی برای افزایش سرعت استنتاج مدل بینایی-زبانی LFM2.5-VL-3B معرفی کرد. این مدل با افزودن حدود ۲۸۰ میلیون پارامتر به مدل اصلی، سرعت تولید توکن را افزایش میدهد بدون اینکه خروجی نهایی تغییر کند.
مدلهای استاندارد زبانی هر بار فقط یک توکن تولید میکنند، اما روش کدگذاری حدسی از یک مدل کوچکتر برای پیشنهاد چند توکن همزمان استفاده میکند و سپس مدل اصلی، صحت آنها را در یک مرحله بررسی میکند. مدل DSpark از روشی مشابه مدلهای متنی Liquid AI پیروی میکند و حالتهای پنهان (Hidden States) مدل هدف را از چندین لایه میخواند. نکته کلیدی اینجاست که برای این مدل پیشنویس، نوع داده (متن یا تصویر) فرقی نمیکند، زیرا در لایههای پنهان، توکنهای متنی و پچهای تصویری هر دو به صورت تانسور در میآیند.
معماری مدل پیشنویس شامل ۴ لایه توجه (Attention) و یک بخش پیشبینی مارکوف است. این مدل از دادههای آموزش با نظارت کامل (Supervised Fine-Tuning) برای ۱۰ دوره آموزش دیده و تمام آزمایشها روی سختافزارهای AMD انجام شده است.
عملکرد در سختافزارهای مختلف#
بر اساس نتایج ارائهشده، این مدل افزایش سرعت زیر را در پیکربندیهای مختلف داشته است:
- Apple M5 Max (با MLX-VLM): افزایش سرعت استنتاج تا ۳.۱۳ برابر و افزایش سرعت کل تا ۲.۶۲ برابر.
- NVIDIA H100 (با SGLang): افزایش سرعت استنتاج تا ۲.۶۶ برابر و افزایش سرعت کل تا ۲.۲۷ برابر.
- Apple M3 Ultra (با llama.cpp): افزایش سرعت استنتاج تا ۲.۱۴ برابر و افزایش سرعت کل تا ۱.۷۷ برابر.
توجه به این نکته ضروری است که افزایش سرعت کل (End-to-End) همیشه کمتر از افزایش سرعت استنتاج است. دلیل آن این است که بخشهای کدگذاری تصویر و پیشپردازش (Prefill) همچنان با سرعت قبلی اجرا میشوند. در دستگاههای Edge که قدرت پردازشی کمتری دارند، این محدودیت بیشتر حس میشود.
دسترسی و محدودیتها#
مدل LFM2.5-VL-3B-DSpark در حال حاضر در Hugging Face با فرمتهای Safetensors و GGUF در دسترس است و از همان روز اول در SGLang، MLX-VLM و llama.cpp پشتیبانی میشود. این مدل تحت مجوز LFM Open License v1.0 منتشر شده که استفاده تجاری رایگان را فقط برای شرکتهایی با درآمد سالانه کمتر از ۱۰ میلیون دلار مجاز میداند.
تحلیل تحریریه#
انتشار این مدل نشان میدهد که روش کدگذاری حدسی از مدلهای متنی خالص خارج شده و به حوزه مدلهای چندوجهی (Multimodal) رسیده است. برای توسعهدهندگانی که از مدلهای بینایی-زبانی روی سختافزارهای محدود مثل لپتاپهای Apple Silicon یا GPUهای تکنفره استفاده میکنند، این مدل میتواند تجربه کاربری را بهبود بخشد. با این حال، باید در نظر داشت که این مدل هنوز در مرحله آزمایشی است و شتابدهی به مدلهای کوانتیزهشده (Quantized) هنوز پیادهسازی نشده است. همچنین، محدودیتهای مجوز استفاده تجاری، آن را برای استارتاپهای کوچک مناسب میکند اما شرکتهای بزرگتر را از استفاده رایگان محروم میسازد.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.