

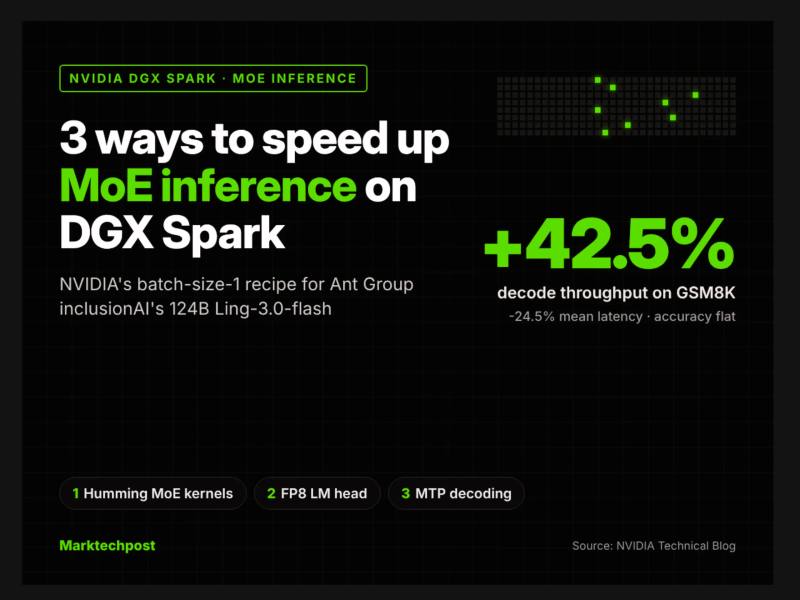
تیم فنی انویدیا در پستی در وبلاگ رسمیاش نشان داد که با سه بهینهسازی همزمان میتوان سرعت استنتاج مدلهای mixture-of-experts را روی یک سیستم دسکتاپی DGX Spark تا ۴۲.۵ درصد بالا برد. مدل آزمایشی Ling-3.0-flash محصول Ant Group inclusionAI است: یک MoE با ۱۲۴ میلیارد پارامتر کل و ۵.۱ میلیارد پارامتر فعال به ازای هر توکن، با context بومی ۲۵۶K.
سه بهینهسازی#
- هستههای Humming MXFP4: انویدیا backend MoE را از FlashInfer به کتابخانه Humming تغییر داد. Humming با NVRTC در زمان اجرا و برای شکل ماتریسهای واقعی کامپایل میکند (کامپایل در چند ثانیه، در مقابل دهها دقیقه برای مسیر CUTLASS). افزایش: ۹.۳ درصد.
- لایه خروجی FP8 (LM head): ماتریس ۱۵۷,۱۸۴ × ۲,۵۶۰ که هر توکن تولیدشده تمام آن را میخواند، در زمان بارگذاری به FP8 کوانتایز میشود. فعالسازی با متغیر محیطی SGLANG_ENABLE_FP8_LM_HEAD=1. افزایش ترکیبی با Humming: ۲۱.۷ درصد نسبت به baseline.
- استنتاج حدسی MTP با NEXTN: Ling-3.0-flash یک لایه پیشبینی NEXTN داخلی دارد، پس به مدل draft جداگانه نیاز نیست. سه توکن draft میشود و چهار موقعیت همزمان تأیید میشود. در تست مصنوعی پرش ۱۸۵.۱ درصدی داشت.
نتیجه روی GSM8K#
روی هر ۱,۳۱۹ سؤال GSM8K (با ۵-shot، CoT، temperature 0.6، top_p 0.95، top_k 29)، سرعت decode از ۳۷.۸۱ به ۵۳.۸۹ توکن بر ثانیه رسید و میانگین تأخیر از ۱۵.۲۱ به ۱۱.۴۹ ثانیه افتاد. دقت از ۹۶.۸۹ به ۹۶.۸۲ درصد تغییر کرد؛ انویدیا آن را از نظر آماری غیرقابلتشخیص میداند. طول پذیرش (accept length) از ۳.۹۰ در تست مصنوعی به ۲.۶۸ در GSM8K کاهش یافت — چون پاسخهای واقعی کوتاهتر و کمتر تکراریاند.
تلهی ترکیب#
انویدیا هشدار میدهد که FP8 LM head و MTP را نمیتوان بدون تنظیم خاص کنار هم فعال کرد. اگر draft module با لایه FP8 بهاشتراک گذاشته نشود، فریمورک بیصدا به BF16 برمیگردد، accept length به ۱.۰۰ میافتد و سرعت از baseline هم پایینتر میشود.
خوانش تحریریه: برای کسی که همین حالا ایجنت میسازد، این خبر یعنی چه#
مهمترین پیام این پست فنی، عدد ۴۲.۵ درصد نیست؛ پیام اصلی این است که روی سختافزار دسکتاپی (۱۲۸ GB unified memory، ۲۷۳ GB/s bandwidth) میتوان یک MoE با ۱۲۴B پارامتر را برای یک کاربر با سرعت قابلقبول سرو کرد. این یعنی مرز «مدل بزرگ فقط در دیتاسنتر» برای سناریوهای تککاربرهای مثل coding agent یا deep-research در حال جابهجایی است. اما دو نکته را نباید از چشم دور داشت: اول، سود مصنوعی (+۱۸۵٪) روی بار کاری واقعی به (+۴۲.۵٪) فرو میریزد؛ پس هر عددی که در تستهای synthetic میبینید، سقف نیست. دوم، تلهی ترکیب FP8 LM head و MTP یک خطای بیصداست — یعنی اگر از سرعت کمتر از حد انتظار تعجب کردید، اول بررسی کنید هر بهینهسازی واقعاً فعال است یا نه.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.