

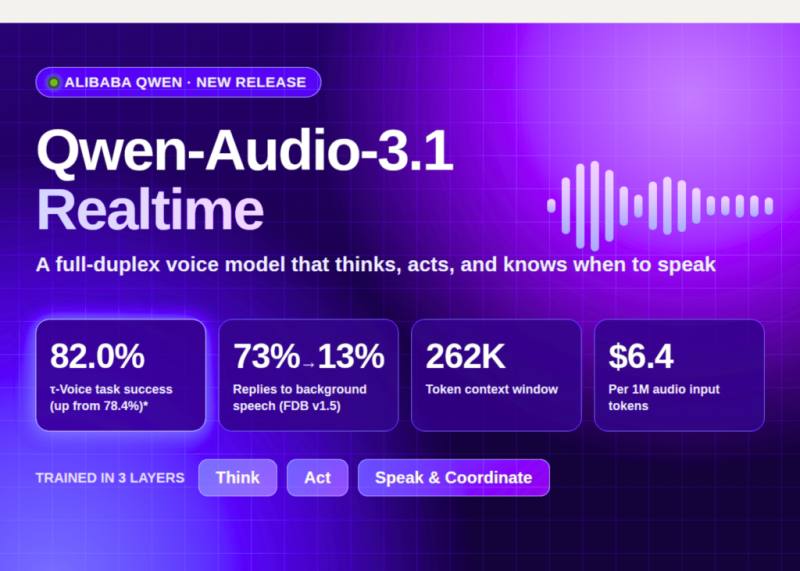


تیم Qwen علیبابا مجموعهای پنجمدلی صوتی به نام Qwen-Audio-3.1 منتشر کرد که مدل اصلی آن، Qwen-Audio-3.1-Realtime، یک مدل گفتار تمامدوقلو (full-duplex) است و برای ایجنتهای صوتیای طراحی شده که همزمان فکر میکنند، ابزار صدا میزنند و تصمیم میگیرند کِی صحبت کنند. قیمت Realtime حدود ۸۵ درصد، TTS حدود ۷۰ درصد و ASR تا ۹۵ درصد نسبت به نسخههای پیشین کاهش یافته است.
دسترسی و مشخصات فنی#
مدل با نام qwen-audio-3.1-realtime-plus روی QwenCloud و از طریق WebSocket در دسترس است. وزنهای باز منتشر نشده و خودمیزبانی ممکن نیست. بافت (context) مدل ۲۶۲K توکن است؛ حداکثر ورودی ۲۴۵K و حداکثر خروجی ۱۶K توکن. سقف پیشفرض ۶۰ درخواست و ۱۰۰K توکن در دقیقه است.
قیمتگذاری: ۶/۴ دلار در هر میلیون توکن ورودی صوتی، ۰/۸ دلار در هر میلیون توکن ورودی متنی، و ۲۴ دلار در هر میلیون توکن خروجی (صوت و متن). خروجی متنی جداگانه محاسبه نمیشود. قابلیتها شامل function calling، جستوجوی وب، خروجی ساختاریافته، context cache و fine-tuning است.
مدل همراه Qwen-Audio-3.1-ASR-Flash-Filetrans برای تبدیل آفلاین گفتار بلند به متن طراحی شده و hot words، جداسازی گوینده، نقطهگذاری و تشخیص گویشهای چینی را پشتیبانی میکند. قیمت آن ۰/۱۵ دلار ورودی و ۰/۴۷ دلار خروجی در هر میلیون توکن است.
معماری و آموزش#
سیستم از دو مدل با Audio Encoder و LLM مشترک تشکیل شده: یک مدل تصمیمگیر تمامدوقلو که پیشبینی میکند گوش بدهد، صحبت کند، متوقف شود یا ادامه دهد، و یک مدل گفتاربهمتن که پاسخ را مینویسد. سپس یک voice renderer متن را به گفتار جریانی تبدیل میکند.
آموزش در سه لایه انجام شده: Think (تقطیر چندمعلمه با GRPO)، Act (محیطهای اجرایی خودتکامل با ابزار و دیتابیس stateful)، و Speak and Coordinate (تصمیم درباره کِی و چگونه صحبت کردن).
بنچمارکها#
- Audio MultiChallenge از ۴۷/۱۲ به ۵۲/۲۱ (نسخه ۳/۰) ارتقا یافته.
- میانگین ۱۴زبانه BBA از ۸۱/۷٪ به ۸۸/۱٪ رسیده.
- WER روی FLEURS از ۹/۰۱ به ۳/۹۸ کاهش یافته.
- پاسخ به صدای پسزمینه از ۷۳٪ به ۱۳٪ افت کرده (Full-Duplex-Bench v1/5).
- موفقیت حمله چندنوبتی به ۲۶٪ (چینی) و ۲۳/۵٪ (انگلیسی) رسیده.
- در مطالعه قرمزتیم انسانی ۵۰جلسهای، GPT-Realtime-2 همچنان جلوتر است: ۹۶٪ در برابر ۹۲٪.
این خبر برای سازندگان ایجنت صوتی یعنی چه#
مهمترین پیام عملی این خبر قیمت است. ۶/۴ دلار در هر میلیون توکن ورودی صوتی، این مدل را به ارزانترین گزینه تمامدوقلو با function calling و جستوجوی وب تبدیل میکند — حدود یکپنجم GPT-Realtime-2 و دو برابر Gemini 3.8 Live. برای کسی که ایجنت صوتی با حجم بالای مکالمه میسازد، این تفاوت هزینه میتواند مرز بین مقرونبهصرفه و ناممکن بودن باشد.
اما دو هشدار وجود دارد. اول، تأخیر توقف پس از قطعشدن صحبت کاربر ۱/۱۱۶ ثانیه است در برابر ۰/۳۸۳ ثانیه GPT-Realtime-2؛ یعنی از نظر حس مکالمه طبیعی، هنوز فاصله دارد. دوم، خودمیزبانی ممکن نیست و وابستگی کامل به QwenCloud وجود دارد — اگر سرویسدهنده محدودیت نرخ را تغییر دهد یا مدل را حذف کند، کنترل شما صفر است.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.