

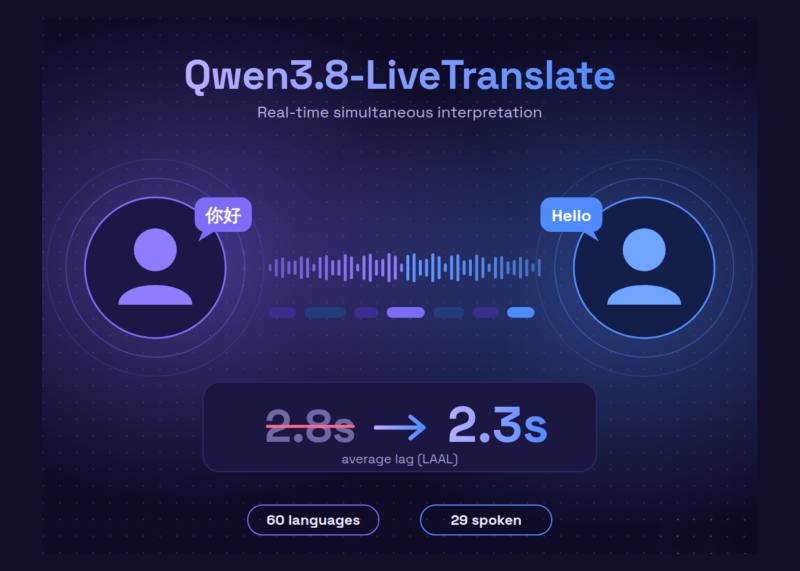
تیم Qwen در علیبابا مدل جدیدی به نام Qwen3.8-LiveTranslate را برای ترجمه همزمان (Simultaneous Interpretation) معرفی کرد. این مدل با استفاده از معماری جدید Interleave، تأخیر میانگین (LAAL) را از ۲.۸ ثانیه به ۲.۳ ثانیه کاهش داده است. این نسخه در حال حاضر به صورت API روی Alibaba Cloud Model Studio و QwenCloud در دسترس قرار دارد.
تغییرات فنی و قابلیتهای جدید#
کاهش تأخیر در این مدل به معنای بهبود دقت، روانی و ایجاز در خروجی ترجمه است. تیم توسعهدهنده سه قابلیت کلیدی را به این نسخه اضافه کرده است:
- تشخیص گوینده (Speaker Diarization): مدل در جلسات چند نفره، صدای گوینده را تشخیص داده و هویت آن را در ترجمه حفظ میکند.
- نمایش همزمان دوزبانه: متن اصلی و ترجمه همزمان در کنار هم نمایش داده میشوند.
- رفع ابهام با زمینه طولانی: مدل از تاریخچه مکالمه برای حفظ ثبات نامها و اصطلاحات در طول یک جلسه استفاده میکند.
پشتیبانی زبانی و محدودیتها#
این مدل ۶۰ زبان را درک میکند و در ۲۹ زبان (از جمله چینی، انگلیسی، عربی، آلمانی، فرانسوی، اسپانیایی، ژاپنی، کرهای و هندی) خروجی صوتی و متنی تولید میکند. برای ۳۱ زبان دیگر، تنها خروجی متنی در دسترس است. ورودیها شامل صوت و تصاویر اختیاری (حداکثر ۲ تصویر در ثانیه) هستند که به تشخیص بهتر در محیطهای شلوغ کمک میکند.
قیمتگذاری و دسترسی#
دسترسی به این مدل از طریق WebSocket و با شناسه qwen3.8-livetranslate-flash-realtime امکانپذیر است. قیمتگذاری در سرور سنگاپور برای هر ۱ میلیون توکن به صورت زیر است:
- ورودی صوتی: ۷.۵۰ دلار
- ورودی تصویر: ۰.۵۵ دلار
- خروجی متنی: ۲۰ دلار
- خروجی صوتی: ۳۰ دلار
یک ساعت مکالمه (ورودی و خروجی صوتی) حدود ۱.۵۴ دلار در سرور سنگاپور هزینه دارد. پنجره زمینه (Context Window) ۵۳,۲۴۸ توکن است و از Fine-tuning یا Function calling در این نسخه پشتیبانی نمیشود.
تحلیل تحریریه: آیا ۲.۳ ثانیه برای ما مهم است؟#
کاهش تأخیر به ۲.۳ ثانیه، این مدل را به گزینهای جدی برای جلسات رسمی و وبینارهای چندزبانه تبدیل میکند، اما برای کاربردهای تعاملی سریع (مثل چتباتهای صوتی) هنوز کند محسوب میشود. نکته مهم برای توسعهدهندگان فارسیزبان، محدودیتهای API و عدم پشتیبانی از Fine-tuning است؛ یعنی نمیتوانید مدل را روی دادههای خاص خود تنظیم کنید. همچنین هزینه ۱.۵۴ دلار برای هر ساعت مکالمه، نسبت به مدلهای متنی گران است و باید در محاسبه هزینههای عملیاتی پروژههای خود لحاظ شود.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.