


«ایجنت» در گفتگوی فنی فارسیزبان به کلمهای بیمعنا تبدیل شده که هر wrapper سادهای را با آن صدا میزنند. مشکل اینجاست که تصمیم «ایجنت بسازم یا نسازم» یک تصمیم معماری با هزینههای مشخص است — توکن، latency، و پیچیدگی دیباگ — و اشتباه در آن، گرانتر از اشتباه در نوشتن prompt است. این مقاله همان تصمیم را از همهی زوایا باز میکند: تعریف دقیق، الگوهای طراحی، ابزارها، و لحظههایی که باید ایجنت نساخت.
ایجنت هوش مصنوعی دقیقاً چیست و چه فرقی با چتبات دارد؟#
ایجنت هوش مصنوعی (AI Agent) سیستمی است که در حین اجرا خودش تصمیم میگیرد کدام ابزار را چند بار و در چه ترتیبی صدا بزند. چتبات و workflow ثابت این قدرت تصمیمگیری runtime را ندارند؛ ترتیب مراحل از پیش مشخص است.
Anthropic در پست Building Effective Agents (دسامبر 2024) دقیقاً همین تمایز را مطرح کرد: ایجنت بر اساس «تصمیمگیری خودکار مدل در حین اجرا» تعریف میشود، نه بر اساس پیچیدگی prompt. این تعریف را جدی بگیرید — اگر مدل شما در حین اجرا هیچ انتخابی نمیکند، ایجنت نساختهاید.
سه سطح عملی وجود دارد:
- Wrapper ساده: یک prompt + یک فراخوانی LLM. هیچ حلقهی تصمیمگیری ندارد.
- Workflow ثابت: ترتیب مراحل مشخص است، LLM فقط در هر مرحله fill-in انجام میدهد.
- ایجنت واقعی: حلقهی تصمیمگیری + انتخاب ابزار + امکان بازگشت به مراحل قبلی.
مثال عملی: رتبهبندی یک مقاله. در workflow ترتیب ثابت است — بخوان، خلاصه کن، نمره بده. در ایجنت، مدل خودش تصمیم میگیرد آیا نیاز به جستوجوی اضافی دارد، آیا باید بخشهایی را دوباره بخواند، یا خروجی فعلی کافی است.
نکتهی کلیدی: اگر task شما با ترتیب ثابت و یکبار اجرا حل میشود، ایجنت فقط هزینه و latency اضافه میکند. ایجنت وقتی لازم است که ماهیت task کاوشی (Exploratory) باشد.
معماری ایجنت: چرخهی ادراک، تصمیم و عمل#
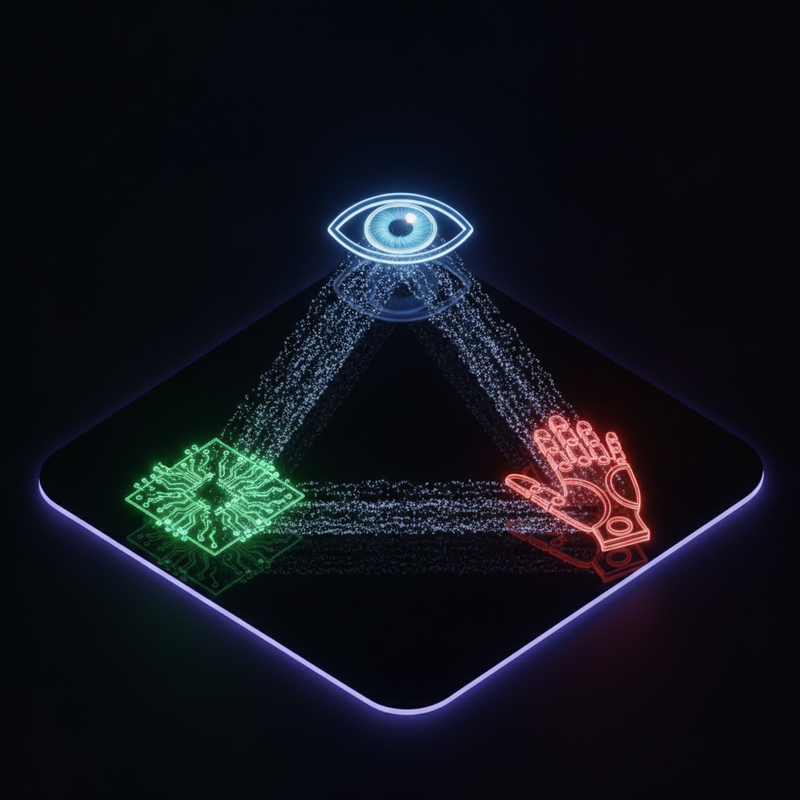
معماری ایجنت از چهار جزء اصلی ساخته میشود: حافظه (Memory)، ابزار (Tools)، برنامهریز (Planner) و ارزیاب (Evaluator). این چهار جزء در حلقهی ادراک-تصمیم-عمل (Perception-Reasoning-Action) دور هم میچرخند و هر دور، یک iteration محسوب میشود.
حافظه: کوتاهمدت و بلندمدت#
حافظهی کوتاهمدت همان context گفتوگوی جاری است. با هر iteration بزرگتر میشود و در نهایت به سقف window مدل میرسد. حافظهی بلندمدت معمولاً روی Vector Store پیاده میشود تا ایجنت اطلاعات جلسات قبلی را بازیابی کند.
LlamaIndex در این لایه نقش پررنگی دارد — اگر ایجنت شما بیشتر با مستندات و knowledge base سروکار دارد، LlamaIndex ابزار طبیعیتری نسبت به LangChain برای بخش retrieval است.
ابزار و Function Calling#
OpenAI در 2023 قابلیت Function Calling را به API اضافه کرد. این مکانیزم فنی، پایهی انتخاب ابزار توسط ایجنت شد. ایجنت schema هر ابزار را میبیند و تصمیم میگیرد کدام را صدا بزند.
طراحی دقیق tool schema بخش اصلی کار است، نه نوشتن prompt. یک schema ضعیف = یک ایجنت ضعیف. هر ابزار باید ورودی، خروجی، و خطاهای ممکن را صریح تعریف کند. این را جدی بگویید: در پروژههایی که در کلاسهای این حوزه بررسی شدهاند، تیمها ساعتها روی prompt وقت میگذارند و schema ابزار را «بعداً» مینویسند — و همان «بعداً» به هفتهها debugging تبدیل میشود.
ایجنت چند-agentی (Multi-Agent System)#
قاعدهی عملی انتخاب تک-ایجنت در برابر Multi-Agent: اگر هر ابزار با prompt مستقل و context متفاوت کار میکند، multi-agent منطقی است. اگر همهی ابزارها روی یک context مشترک کار میکنند، تک-ایجنت کافی است.
Orchestrator مسئول تقسیم وظیفه بین agentهاست. اضافهکردن لایهی multi-agent بدون نیاز واقعی، latency و هزینه را بالا میبرد و debugging را چندبرابر سختتر میکند. در پروژههای واقعی، الگوی تکرارشوندهای دیده شده که تیمها بدون ضرورت از تک-ایجنت به multi-agent مهاجرت میکنند و بعد پشیمان میشوند. دقیقتر بگویم: پشیمانی آنها از multi-agent بودن نیست، از این است که اصلاً ایجنت لازم نداشتهاند.
ارزیاب و Human-in-the-Loop#
Evaluator criteria خروج را چک میکند. بدون آن، ایجنت در حلقه گیر میکند — چون هیچکس نمیگوید «بس است، ادامه نده». Human-in-the-Loop برای سناریوهای حساس (تصمیم مالی، ارسال ایمیل، تغییر production) ضروری است، نه اختیاری.
ReAct در برابر Plan-and-Execute: کدام الگو برای چه پروژهای؟#
الگوی ReAct (Reasoning + Acting) هر قدم را بهصورت thought→action→observation جلو میبرد و برای taskهای کاوشی مناسب است. Plan-and-Execute ابتدا کل نقشه را میچیند و بعد اجرا میکند و برای taskهای ساختارمند کارآمدتر است.
برگهی ReAct توسط Shunyu Yao و همکاران در 2022 منتشر شد و ترکیب Chain-of-Thought با عمل ابزار را معرفی کرد. این الگو بهخاطر سادگی پیادهسازی، هنوز پرکاربردترین الگوی ایجنت است — و همین سادگی، بزرگترین نقطهضعفش هم هست: در taskهای بلند، حلقهی thought-action-observation بهسرعت به سقف context نزدیک میشود و کیفیت تصمیمگیری افت میکند.
ReAct مناسب است وقتی:
- نتیجهی هر action روی تصمیم بعدی اثر میگذارد
- task کاوشی است (جستوجوی وب، دیباگ کد، تحلیل داده)
- تعداد مراحل از پیش مشخص نیست
Plan-and-Execute مناسب است وقتی:
- ساختار task از قبل مشخص است و فقط fill-in لازم است
- مثال: تولید گزارش هفتگی از چند منبع ثابت
- مراحل قابل پیشبینیاند و بازگشت به عقب نیاز نیست
Reflexion: لایهی خوداصلاحی که ایجنت پس از شکست، بازخورد را تحلیل و دوباره تلاش میکند. هزینهی توکن را چند برابر میکند؛ فقط وقتی لازم است که یک بار تلاش کافی نیست.
| معیار انتخاب | ReAct | Plan-and-Execute | Reflexion |
|---|---|---|---|
| پیچیدگی task | بالا و کاوشی | متوسط و ساختارمند | بالا با نیاز به بازتلاش |
| نیاز به بازگشت | بله | کم | بله (بهصورت هدفمند) |
| هزینهی توکن | متوسط | پایین | بالا |
| Latency | متغیر | قابلپیشبینی | غیرقابلپیشبینی |
فریمورکهای ساخت ایجنت: LangChain، CrewAI و AutoGen#
LangChain یک فریمورک orchestration است، نه معادل ایجنت. میتوان ایجنت بدون LangChain ساخت و LangChain را بدون ایجنت استفاده کرد. انتخاب فریمورک به پیچیدگی orchestration و نیاز به multi-agent بستگی دارد.
| فریمورک | مدل orchestration | Multi-Agent | یادگیری | مناسب برای |
|---|---|---|---|---|
| LangChain | Chain-based با abstraction سنگین | محدود (LangGraph جدا است) | شیب تند | Single-agent با ابزارهای متنوع |
| CrewAI | نقشمحور (Role-based) | بومی | ملایم | Multi-agent با تقسیم وظیفهی شفاف |
| AutoGen | گفتوگو بین agentها | بومی و عمیق | شیب تند | سناریوهای negotiation بین agentها |
| LlamaIndex | Retrieval-first | محدود | ملایم | ایجنتهای مستندمحور |
LangChain اکوسیستم بزرگی دارد ولی abstractionهایش گاهی debug را سختتر میکنند. CrewAI برای شروع سریعتر است چون نقشها و وظایف را صریح تعریف میکند. AutoGen (مایکروسافت) گفتوگو بین agentها را بهعنوان primitive اصلی میگیرد — مناسب سناریوهایی که agentها با هم negotiate میکنند. LlamaIndex تمرکزش روی data retrieval است؛ اگر ایجنت شما بیشتر با مستندات سروکار دارد، این گزینه طبیعیتر است.
نکتهی عملی: هیچکدام از این فریمورکها جای طراحی tool schema و evaluation loop را نمیگیرند. فریمورک ابزار است، معماری تصمیم شماست.
ساخت ایجنت هوش مصنوعی از صفر: 6 مرحلهی عملی#
ساخت ایجنت یک فرآیند 6 مرحلهای است: تعریف criteria موفقیت، طراحی tool schema، انتخاب الگو معماری، پیادهسازی حلقه، اضافهکردن guardrail، و ارزیابی با replay. هر مرحله را حذف کنید، هزینهی مرحلهی بعد چند برابر میشود.
- تعریف criteria خروج صریح + max iterations. بدون این، ایجنت در حلقه گیر میکند. مثال: «خروجی معتبر است اگر شامل 3 منبع با URL باشد و حداکثر 8 iteration مجاز است.»
- طراحی tool schema. هر ابزار: نام، توضیح، ورودی، خروجی، خطاهای ممکن. این مرحله بیشتر از نوشتن prompt زمان میبرد.
- انتخاب الگو معماری. ReAct یا Plan-and-Execute بر اساس ماهیت task.
- پیادهسازی حلقه. شبهکد ساده با logging هر iteration.
- Guardrail. max cost per run، escalation به human، timeout.
- ارزیابی. Replay mode برای بازتولید خطا، test suite با taskهای شناختهشده.
نمونه ساختار پوشه پروژه ایجنت:
agent/— حلقهی اصلی و state machinetools/— schema و پیادهسازی هر ابزارmemory/— لایهی retrieval و vector storeevaluation/— test suite و replay logsconfig/— max iterations، budget، guardrail
اشتباهات رایج و الگوی دیباگ ایجنت#
رایجترین اشتباه طراحی ایجنت، نبود criteria خروج و max iterations است. نتیجه: حلقهی بیپایان و هزینهی غیرقابلپیشبینی توکن. الگوی دیباگ: logging هر iteration شامل thought + action + observation.
سه اشتباه تکرارشونده در پروژههای واقعی:
- «ایجنت یعنی هر چیزی که با LLM کار کند». تعریف آنقدر گسترده که تمایز wrapper و ایجنت از بین میرود. نتیجه: تیمها wrapper را ایجنت صدا میکنند و بعد انتظار رفتار هوشمند دارند.
- «هرچه پیچیدهتر، بهتر». اضافهکردن multi-agent بدون نیاز، latency و هزینه را بالا میبرد. یک ایجنت ساده با 3 ابزار، معمولاً از یک سیستم 5-agentی بهتر کار میکند.
- «فقط prompt بنویس، ایجنت خودکار همهچیز را انجام میدهد». نادیدهگرفتن طراحی tool schema و error handling. نتیجه: ایجنت ابزار را صدا میزند، خطا میگیرد، و دوباره همان ابزار را با همان ورودی صدا میزند.
الگوی دیباگ برخلاف کد معمولی: رفتار ایجنت non-deterministic است. یک input ثابت، خروجی متغیر میدهد. پس logging هر iteration (thought + action + observation) و replay mode برای بازتولید خطا ضروری است. این نکته در محتوای فارسی تقریباً پوشش داده نشده، ولی در عمل بدون آن دیباگ ایجنت تقریباً غیرممکن است.
در تستهای load، ایجنتهایی که بدون محدودیت حلقه طراحی شدهاند، هزینهی توکن غیرقابلپیشبینی تولید میکنند. این الگو در گزارشهای community بارها تکرار شده است.
چه زمانی نباید از ایجنت استفاده کرد؟#
اگر task یک بار و با ترتیب ثابت انجام میشود، workflow ساده ارزانتر و قابلپیشبینیتر است. اگر latency زیر یک ثانیه لازم است، حلقهی reasoning-action-observation ایجنت آن را تأمین نمیکند. اگر خروجی باید کاملاً reproducible باشد، deterministic pipeline بسازید.
معیارهای عملی «نساختن ایجنت»:
- ترتیب مراحل ثابت و از پیش مشخص است → workflow ساده بسازید
- Latency حساس است → ایجنت مناسب نیست
- خروجی باید کاملاً قابلپیشبینی باشد → deterministic pipeline
- Task در یک فراخوانی LLM حل میشود → wrapper کافی است
جایگزینهای عملی: workflow ثابت، prompt chain، RAG ساده. این «ضد-توصیه» در نتایج فعلی که همه ایجنت را راهحل جاودان معرفی میکنند، غایب است. ولی تجربهی میدانی نشان میدهد که بیشتر پروژههایی که با عنوان «ایجنت» شروع شدهاند، در نهایت به یک workflow ثابت تبدیل میشوند — چون task واقعاً به حلقهی تصمیمگیری نیاز نداشته است.
ایجنت یک انتخاب معماری است با هزینه و فایدهی مشخص. قبل از ساخت، بپرسید: آیا مدل واقعاً نیاز دارد در حین اجرا تصمیم بگیرد؟ اگر جواب منفی است، ایجنت نسازید. اگر مثبت است، با tool schema دقیق و max iterations شروع کنید، نه با prompt.
اگر میخواهید این مفاهیم را در یک پروژهی واقعی پیاده کنید، دورهی «ساخت Ai Agent با N8N» در کامیونیتی N8N اسکول، از طراحی tool schema تا deployment را گامبهگام پوشش میدهد. اگر هم بدون کدنویسی ایجنت و اتوماسیون میسازید، دورهی «آموزش جامع Claude و ابزارهای مشابه» مسیر Vibe Coding را نشان میدهد.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.