


بیشتر تیمهایی که وارد ساخت ایجنت هوش مصنوعی (AI Agent) میشوند، یکی از دو خطای پرهزینه را مرتکباند: ایجنت میسازند جایی که workflow ساده کافی بوده، یا workflow مینویسند جایی که ایجنت لازم است. ایجنتِ بیمورد، چند برابر توکن میسوزاند و قابل debug نیست؛ workflowِ بیمورد، با اولین تغییر در input میشکند. تشخیص مرز، اولین مهارت معماری ایجنت است.
ایجنت هوش مصنوعی چیست و کجا خط مرزیاش با workflow میکشاند؟#
ایجنت هوش مصنوعی در حلقهی خودمختارش تصمیم میگیرد کدام ابزار را چه زمانی صدا بزند و کی متوقف شود؛ workflow همان تصمیمگیری را از پیش بهصورت شرطی نوشته است. خط مرزی عملی: اگر تمام مسیرهای ممکن را میتوانید از پیش روی کاغذ بکشید، workflow بسازید. اگر تعداد مسیرها از 5 بیشتر است و پیشبینیپذیر نیست، ایجنت ابزار درست است.
چتبات پاسخ تولید میکند. ایجنت اقدام میکند: ابزار صدا میزند، نتیجه را میخواند، بر اساس آن تصمیم بعدی را میسازد. این حلقهی تکرارشونده — perceive، think، act — تفاوت بنیادین را میسازد. یک چتبات حتی با بهترین prompt هم ابزار صدا نمیزند؛ ایجنت میزند.
workflow یعنی شما از قبل یک سری شرط if-then-else نوشتهاید و مدل فقط شاخهی درست را اجرا میکند. ایجنت یعنی مدل خودش در زمان اجرا تصمیم میگیرد کدام شاخه را برود. اگر flow chart کامل قابل رسم است، workflow بسازید؛ اگر نه، ایجنت لازم است.
RAG (Retrieval-Augmented Generation) هم یک ابزار ثابت است: بازیابی متن و تزریق به context. ایجنت میتواند RAG را بهعنوان یکی از ابزارهایش استفاده کند، ولی خودش انتخاب میکند که آیا اصلاً به بازیابی نیاز دارد یا نه. RAG زیرمجموعهی ایجنت است، نه جایگزینش.
معیار عملی که در پروژههای اعضای کامیونیتی مکرر دیده شده: اگر تعداد مسیرهای ممکن از 5 بیشتر است و نمیتوانید همه را از قبل بنویسید، ایجنت منطقی است. زیر 5 مسیر، workflow سادهتر و ارزانتر است. این عدد قانون نیست، یک الگوی تکرارشونده است.
اجزای بنیادین معماری ایجنت: LLM، حلقه، ابزار و حافظه#
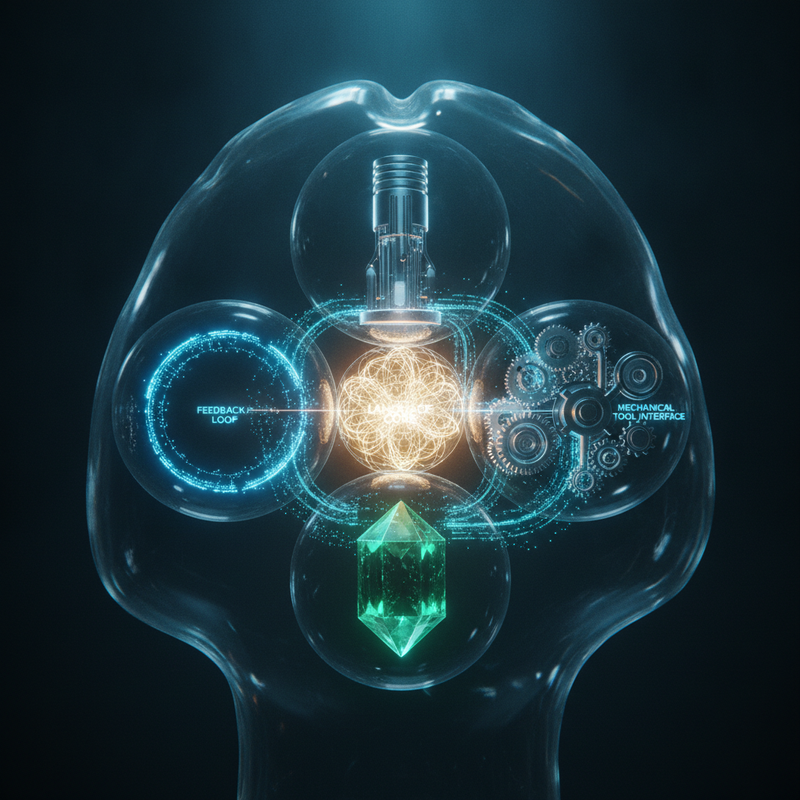
معماری ایجنت هوش مصنوعی چهار جزء اصلی دارد: مدل زبانی بزرگ (LLM) بهعنوان مغز، حلقهی perceive-think-act بهعنوان منطق، مجموعه ابزار (tool set) بهعنوان دستها، و حافظه (memory) بهعنوان تجربه. حذف هر یک از این چهار جزء، ایجنت را به چتبات یا script ساده تبدیل میکند.
حلقه perceive-think-act و نقش ReAct framework#
ReAct framework (Yao et al., 2022) الگویی است که ترکیب استدلال زنجیرهای (chain-of-thought) با اقدام را در یک حلقه واحد تعریف کرد. مدل فکر میکند، ابزار صدا میزند، نتیجه را میبیند و دوباره فکر میکند. این الگو پایهی معماری اکثر ایجنتهای مدرن است.
شبهکد سادهی حلقه:
while not success_condition and iterations < max_iterations:
thought = llm.reason(context, observation)
action = llm.select_tool(thought, available_tools)
observation = execute(action)
context.append(thought, action, observation)
iterations += 1
اجزای حافظه: کوتاهمدت و بلندمدت#
حافظه کوتاهمدت همان context window است: تاریخچهی تعاملات جاری. برای وظایف تکمرحلهای کافی است. حافظه بلندمدت معمولاً یک vector store یا database است که ایجنت بین sessions یاد میگیرد و تاریخچهی تعاملات قبلی را بازیابی میکند.
ایجنتهایی که بدون حافظه بلندمدت ساخته شدهاند، در هر session از صفر شروع میکنند و اشتباهات تکراری میکنند. الگوی مکرر در پروژههای کامیونیتی: تیمها در فاز MVP حافظه بلندمدت را حذف میکنند، بعد در فاز production با مشکل تکرار اشتباه مواجه میشوند و مجبور به بازنویسی معماری میشوند. اضافهکردن حافظه بلندمدت هزینهی توکن را بالا میبرد ولی کیفیت خروجی را در وظایف تکراری بهبود میدهد.
ابزار و فراخوانی تابع#
ایجنت از طریق فراخوانی تابع (function calling) دست به دنیای بیرون میزند. هر ابزار یک schema دارد: نام، توضیح و پارامترها. مدل بر اساس توضیح ابزار تصمیم میگیرد کدام را صدا بزند. کیفیت توضیحات ابزار، مستقیماً روی دقت انتخاب ابزار تأثیر میگذارد — بدترین توضیح ابزار، بدترین خروجی ایجنت را میسازد.
Planner و نقش chain-of-thought#
Planner بخشی از ایجنت است که وظیفه را به مراحل کوچکتر تقسیم میکند. chain-of-thought روشی است که مدل قبل از اقدام، مراحل تفکرش را بهصورت متنی مینویسد. این الگو در ایجنتهای چندمرحلهای کمک میکند مدل مسیر را از قبل طراحی کند و در حین اجرا انحراف را تشخیص دهد.
مراحل عملی ساخت یک ایجنت AI از صفر#
ساخت ایجنت هوش مصنوعی پنج مرحلهی اصلی دارد: تعریف condition of success، انتخاب ابزار، طراحی حلقه و fallback، پیادهسازی و تست، و بهینهسازی مصرف توکن. ترتیب این مراحل حیاتی است؛ شروع با کدنویسی بدون تعریف condition of success، رایجترین اشتباهیست که در کلاسها و پروژههای اولیه مکرر تکرار میشود.
- تعریف condition of success: مشخص کنید ایجنت کی متوقف میشود و نتیجهی موفق دقیقاً چیست. بدون این معیار، ایجنت قابلارزیابی نیست.
- انتخاب ابزار: حداکثر 3 تا 4 ابزار در ایجنت اول. بیشتر از این، نرخ توهم (hallucination) در انتخاب ابزار بهطور غیرخطی بالا میرود.
- طراحی حلقه با max iteration و fallback: یک سقف برای تعداد دورها بگذارید و مشخص کنید اگر ابزار خطا داد، ایجنت چه کند.
- پیادهسازی و تست: هر step را جداگانه validate کنید. ابزارها را بدون ایجنت تست کنید، بعد حلقه را بسازید.
- بهینهسازی مصرف توکن: history را خلاصه کنید، tool outputs قدیمی را حذف کنید، context window را مدیریت کنید.
ساختار پوشهی یک پروژه ایجنت:
my-agent/
├── main.py
├── agent.py
├── tools/
│ ├── search.py
│ ├── calculator.py
│ └── database.py
├── memory/
│ ├── short_term.py
│ └── long_term.py
├── config.py
├── tests/
│ ├── test_tools.py
│ └── test_agent_loop.py
└── prompts/
└── system_prompt.txt
پیشنیازهای فنی: Python، درک REST API calls، آشنایی با JSON schema. بدون این سه، شروع با فریمورکهای سنگین مثل LangGraph دردسرزا میشود — نه بهخاطر پیچیدگی خود فریمورک، بهخاطر اینکه debugging بدون این پایهها عملاً غیرممکن است.
LangGraph، CrewAI یا AutoGen — کدام فریمورک برای پروژه من مناسبتر است؟#
LangGraph برای پروژههایی با نیاز به کنترل دقیق flow و testability مناسبتر است؛ CrewAI برای prototyping سریع با مدل نقشمحور بهتر عمل میکند؛ AutoGen برای سناریوهای گفتوگویی چندایجنتی طراحی شده. انتخاب فریمورک باید بر اساس نیاز پروژه باشد، نه محبوبیت. CrewAI برای demo عالی است و برای production خطرناک.
| فریمورک | مدل معماری | کنترل flow | سادگی شروع | Testability | مناسب برای |
|---|---|---|---|---|---|
| LangGraph | State machine | بسیار دقیق | متوسط | بالا | پروژههای production با نیاز به audit trail |
| CrewAI | Role-based | محدود | بالا | متوسط | Prototyping سریع و تیمهای چندایجنتی ساده |
| AutoGen | Conversational multi-agent | غیرمستقیم | متوسط | پایین | سناریوهای گفتوگویی و research |
| OpenAI Assistants API | Managed | کم | بسیار بالا | پایین | پروتوتایپ سریع با lock-in به OpenAI |
LangGraph — state machine با کنترلپذیری بالا#
LangGraph هر ایجنت را بهصورت یک graph از nodes و edges تعریف میکند. این یعنی دقیقاً مشخص میکنید کدام مرحله بعد از کدام اجرا شود، در چه شرایطی loop شود و کجا متوقف شود. هزینهی این کنترلپذیری، پیچیدگی بیشتر در شروع و حجم کد بالاتر است. اگر پروژهتان قرار است در production کار کند و audit trail لازم دارد، LangGraph گزینۀ کمریسکتر است.
CrewAI — role-based و ساده برای شروع#
CrewAI ایجنتها را با نقش (role)، هدف (goal) و backstory تعریف میکند. شروع با آن سریع است ولی debugging دشوارتر میشود چون flow بین ایجنتها implicit است. برای پروژههایی که میخواهید در چند ساعت یک demo بسازید، مناسب است. برای پروژهای که قرار است ماهها زنده بماند، نه.
AutoGen — گفتوگویی multi-agent#
AutoGen ایجنتها را در قالب یک گفتوگو هماهنگ میکند. هر ایجنت پیامی میفرستد و دیگری پاسخ میدهد. این الگو برای سناریوهای تعاملی و research مناسب است ولی مدیریت state و testability در آن چالشبرانگیز است.
الگوی مشاهدهشده در پروژههای واقعی: برای budget محدود و نیاز به production reliability، LangGraph. برای prototyping سریع و نمایش به مشتری، CrewAI. این دو حالت، اکثر نیازها را پوشش میدهند.
هزینهی پنهان ایجنت: چرا مصرف توکن quadratic است؟#
هر بار که ایجنت یک tool call میزند، کل conversation history شامل تمام tool outputs قبلی دوباره به مدل فرستاده میشود. در ایجنتهای با 10+ step این یعنی مصرف توکن quadratic نه linear. این مسئله در مقالات آموزشی کمتر دیده میشود چون اکثر demoها با 2-3 step ساخته میشوند و مشکل پنهان میماند.
مثال ساده: ایجنتی با 5 step که هر step یک tool output 500 توکنی تولید میکند، در step پنجم حدود 2500 توکن history دارد. ولی step دهم، 5000 توکن history دارد. مجموع توکنهای مصرفی از 5 step اول به 10 step دوم، نزدیک چهار برابر میشود، نه دو برابر.
راهحلهای عملی:
- خلاصهسازی history: بعد از هر چند step، tool outputs قدیمی را با یک خلاصهی کوتاه جایگزین کنید.
- حذف tool outputs غیرضروری: اگر نتیجهی یک ابزار فقط یک عدد است، آن عدد را نگه دارید و متن کامل را حذف کنید.
- Context window management: یک سقف برای history تعریف کنید و وقتی پر شد، قدیمیترین entries را drop کنید.
نکتهی نیازمند راستیآزمایی: benchmark SWE-bench (حل باگ در کد واقعی GitHub) نشان میدهد ایجنتها حتی روی وظایفی که یک توسعهدهنده در چند دقیقه حل میکند، دهها iteration و context بزرگ مصرف میکنند. یعنی هزینهی واقعی ایجنت نه فقط در مدل، بلکه در تعداد iterations و حجم context است.
چه زمانی ایجنت AI لازم نیست و workflow ساده کافی است؟#
برای وظایف با مسیر از پیش معلوم یا خروجی قطعی — مثل استخراج فیلد از فاکتور — یک workflow ساده یا function call با structured output سریعتر، ارزانتر و قابلاعتمادتر از ایجنت است. ایجنتی که وظیفهی workflow انجام میدهد، چند برابر توکن مصرف میکند و قابل debug نیست.
سه حالتی که ایجنت overkill است:
- خروجی قطعی و ساختارمند: استخراج فیلد از فاکتور، تبدیل متن به JSON. یک function call با structured output کافی است.
- مسیر ثابت با شرطهای مشخص: اگر user گفت «A» این کار را بکن، اگر «B» آن کار را. workflow با if-then-else بنویسید.
- فقط retrieval بدون تصمیمگیری: اگر فقط باید از یک knowledge base متن پیدا کنید و به مدل بدهید، RAG ساده کافی است.
معیار عملی: اگر میتوانید flow chart کامل بکشید، ایجنت لازم نیست. اگر نمیتوانید، ایجنت بسازید. این یک خط قاعدهی ساده است که در پروژههای واقعی مکرر تأیید شده. بیشتر پروژههایی که در کامیونیتی با مشکل هزینه مواجه میشوند، ایجنتهاییاند که اصلاً نباید ایجنت میبودند.
اشتباهات رایج در طراحی ایجنت و الگوهای شکست#
رایجترین الگوی شکست ایجنت، گیر کردن در حلقهی observe-think-act است: ابزار خطا برمیگرداند و مدل بهجای fallback، دوباره همان ابزار را صدا میزند. بدون max iteration و fallback handler، این حلقه بیپایان است و هزینهی توکن بیحد میشود. این اشتباه در کلاسها مکرر دیده میشود و هزینهاش در production پنهان میماند تا صورتحساب API بیاید.
حلقهی بیپایان (infinite loop)#
ایجنت ابزاری را صدا میزند، خطا میگیرد، فکر میکند «شاید دفعهی بعد درست کار کند» و دوباره همان ابزار را صدا میزند. راهحل: max iteration عددی + fallback handler که بعد از N بار خطا، ایجنت را متوقف کند یا مسیر جایگزین بدهد. بدون این دو، ایجنت شما یک ماشین پولسوز است.
Tool selection hallucination#
ایجنت ابزاری را صدا میزند که در tool set شما وجود ندارد، یا پارامترهای اشتباه میفرستد. این مشکل با تعداد ابزارها رشد غیرخطی دارد. ایجنتی با 10 ابزار، نرخ انتخاب اشتباه بسیار بالاتری از ایجنتی با 3 ابزار دارد. راهحل عملی: split به sub-agent با هر کدام 2-3 ابزار.
Over-engineering با multi-agent#
تکایجنت با ابزارهای درست، بخش عمدهای از نیازهای پروژههای واقعی را پوشش میدهد. توصیهی «اول multi-agent بساز» برای پروژه کوچک، یک اشتباه رایج و پرهزینه است. multi-agent فقط وقتی لازم است که ابزارها ناهمگناند و یک ایجنت با 3-4 ابزار نمیتواند همه را پوشش دهد.
عدم تعریف condition of success#
ایجنت بدون معیار توقف قابلارزیابی نیست. اگر نمیدانید ایجنت کی باید متوقف شود، نمیتوانید بگویید موفق بوده یا نه. این یک تصمیم معماری است که قبل از کدنویسی باید گرفته شود — نه بعد از آن.
الگوی تکرارشونده از پروژههای واقعی: اگر ایجنت شما بیش از 4 ابزار دارد، آن را به sub-agentهایی با هر کدام 2-3 ابزار split کنید. این الگو نرخ tool selection hallucination را کاهش میدهد و debugging را سادهتر میکند.
ایجنت چندوجهی (multi-agent) چیست و چه کاربردی دارد؟#
سیستم ایجنت چندوجهی (multi-agent system) مجموعهای از ایجنتهای تخصصی است که هر کدام وظیفهای مشخص دارند و با هم هماهنگ میشوند. مناسب پروژههایی است که یک ایجنت نمیتواند آنها را با 3-4 ابزار پوشش دهد. معماری رایج: یک coordinator + چند specialist agent.
چه زمانی لازم است: وقتی وظایف با ابزارهای ناهمگن دارید — مثلاً یک ایجنت برای search، یکی برای code execution، یکی برای database. چه زمانی لازم نیست: پروژههای کوچک، تکایجنت با 3-4 ابزار کافی است.
چالش اصلی multi-agent: هماهنگی و مدیریت state بین ایجنتها. هر ایجنت context خودش را دارد و باید مشخص کنید چه اطلاعاتی بین آنها رد و بدل شود. AutoGen و CrewAI هر دو این الگو را پیادهسازی میکنند ولی در روششان متفاوتاند.
هشدار عملی: اگر هنوز تکایجنتتان را debug نکردهاید، سراغ multi-agent نروید. مشکل را از 10 برابر پیچیدهتر میکنید.
تست و دیباگ ایجنت AI: metrics و روشهای عملی#
دیباگ ایجنت هوش مصنوعی باید step-by-step باشد: هر node در حلقه را جداگانه test کنید، log هر tool call را نگه دارید، و success rate را بر اساس condition of success تعریفشده بسنجید. اگر ایجنت را نمیتوانید با یک condition of success بسنجید، قبل از تست مشکل معماری دارید.
Metrics عملی#
- Success rate: درصد وظایفی که ایجنت با condition of success تعریفشده تکمیل کرده.
- Average iterations: میانگین تعداد دورهای حلقه قبل از توقف. اگر این عدد بالا است، حلقه بهینه نیست.
- Tool call accuracy: درصد دفعاتی که ایجنت ابزار درست را با پارامترهای درست صدا زده.
- Token cost per task: مجموع توکن مصرفی برای هر وظیفه. این metric مستقیماً هزینهی عملیاتی شماست.
روشهای تست#
Unit test هر ابزار: ابزار را بدون ایجنت صدا بزنید و مطمئن شوید درست کار میکند. Integration test حلقه: با یک input مشخص، مطمئن شوید ایجنت در N step به condition of success میرسد. Scenario-based test: چند حالت واقعی را simulate کنید و ببینید ایجنت در هر کدام چه میکند.
نکتهی عملی: log هر tool call را نگه دارید (نام ابزار، ورودی، خروجی، timestamp). بدون این log، debugging ایجنت تقریباً غیرممکن است. اکثر فریمورکها این capability را دارند ولی باید فعالش کنید.
ایجنت هوش مصنوعی ابزار قدرتمندی است، ولی نه جادو. مرز بین workflow و agent را بشناسید، condition of success را قبل از کدنویسی تعریف کنید، و مصرف توکن را از روز اول مدیریت. اگر میخواهید این مفاهیم را در پروژهی عملی تمرین کنید، دورهی «ساخت AI Agent با N8N» در کامیونیتی اسکول مسیر مشخصی برای شروع دارد.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.