


آموزشهای ایجنت هوش مصنوعی (AI Agent) تقریباً همه از صفر شروع میکنند: «این ابزار را نصب کن، آن فریمورک را یاد بگیر، حلقه بساز.» اما پرسش اصلی را نمیپرسند: آیا مسئلهی شما اصلاً به ایجنت نیاز دارد؟ معیار سهمرحلهای تصمیمگیری (پرامپت ← workflow ← ایجنت) و هزینهی تجمعی توکن حلقهها، نشان میدهد کجا ایجنت لازم است و کجا فقط پیچیدگی و هزینهی اضافی میسازد. معماری حلقهی ادراک-تصمیم-عمل، مقایسهی فریمورکها و روش عملی دیباگ هم در ادامه میآیند.
ایجنت هوش مصنوعی چیست و چه فرقی با چتبات و RAG دارد؟#
ایجنت هوش مصنوعی سیستمی خودمختار است که محیط را ادراک میکند، تصمیم میگیرد و عمل میکند. چتبات فقط ورودی را به متن تبدیل میکند و RAG فقط اطلاعات بازیابیشده را در پاسخ میگنجاند. تفاوت بنیادین: ایجنت بدون دستور مرحلهبهمرحلهی کاربر، خودش ابزار انتخاب و اقدام انجام میدهد.
در تعریف آکادمیک، Russell و Norvig در کتاب Artificial Intelligence: A Modern Approach ایجنت را موجودی میدانند که از طریق حسگرها محیط را ادراک میکند و از طریق محرکها بر آن اثر میگذارد. تعریف صنعتی که OpenAI و Anthropic در مستنداتشان ارائه میدهند، این مفهوم را به مدل زبانی بزرگ (LLM) که با ابزارها تعامل میکند و در حلقهی تکراری تصمیم میگیرد، محدود کرده است.
سه تفاوت ایجنت را از چتبات و RAG جدا میکند:
- خودمختاری در تصمیم: ایجنت خودش تعیین میکند کدام ابزار، چه ترتیبی و چه تعداد بار لازم است.
- توانایی اقدام: ایجنت واقعاً کاری انجام میدهد — فایل ذخیره، API صدا زده، ایمیل فرستاده — نه فقط توصیف.
- حلقهی بازخورد: نتیجهی هر اقدام را ارزیابی و در دور بعد اصلاح میکند.
مثال عملی: از چتبات بخواهید «خلاصهی این PDF را بده»، فقط متن خلاصه را تولید میکند. از ایجنت بخواهید، خودش فایل را باز میکند، محتوا را استخراج میکند، خلاصه را در دیتابیس ذخیره میکند و نتیجه را گزارش میدهد — بدون اینکه شما هر مرحله را جداگانه دستور بدهید.
معماری ایجنت: حلقهی ادراک-تصمیم-عمل چگونه کار میکند؟#
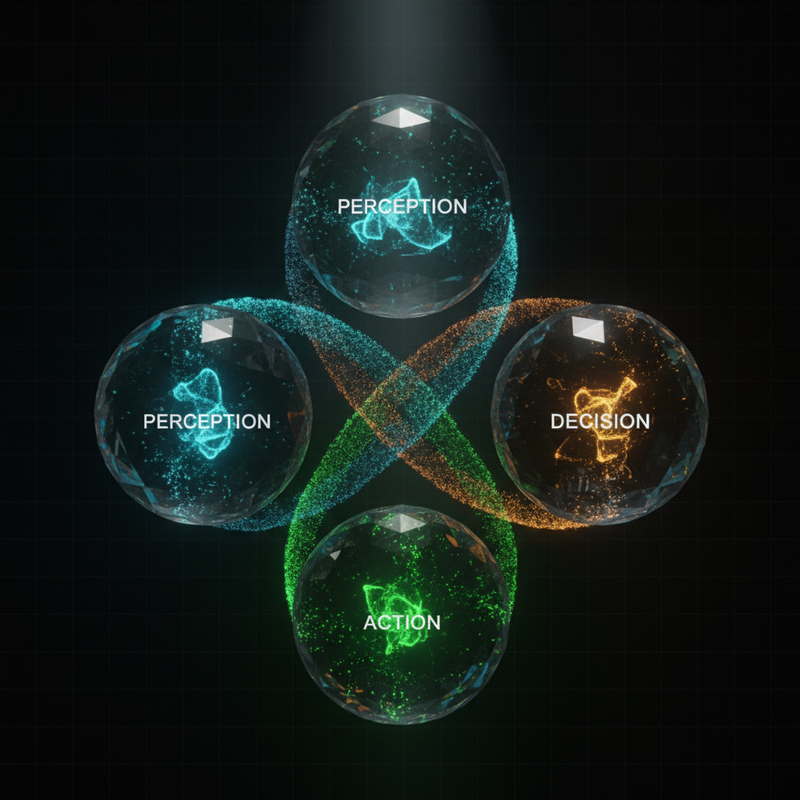
حلقهی ادراک-تصمیم-عمل (Perceive-Plan-Act Loop) ستونمهرهی هر ایجنت است و چهار جزء دارد: مدل زبانی بهعنوان مغز تصمیمگیر، حافظه برای نگهداشتن وضعیت، ابزارها برای اقدام در محیط، و برنامهریز برای تعیین ترتیب گامها. حذف هر یک از این چهار جزء، ایجنت را به چتبات یا RAG ساده تنزل میدهد.
اجزای اصلی ایجنت#
مدل زبانی (LLM): موتور تصمیمگیری. ورودی آن شامل پرامپت سیستمی، تاریخچهی حلقههای قبلی و نتیجهی آخرین ابزار است. خروجی آن یا یک اقدام (فراخوانی ابزار) است یا یک پاسخ نهایی.
ابزارها و Function Calling: OpenAI قابلیت Function Calling را در ژوئن 2023 معرفی کرد. مدل بهجای تولید متن آزاد، یک شیء JSON با نام تابع و آرگومانها برمیگرداند. سیستم این JSON را اجرا میکند و نتیجه را به مدل برمیگرداند.
حافظه: حافظهی کوتاهمدت همان context window مدل است و محدود به تعداد توکن. حافظهی بلندمدت معمولاً با پایگاه دادهی برداری (Vector Database) پیادهسازی میشود. ایجنت در هر دور حلقه، اطلاعات مرتبط را از حافظهی بلندمدت بازیابی و به context اضافه میکند.
الگوهای برنامهریزی#
سه الگوی غالب در طراحی ایجنتها وجود دارد:
- ReAct (Yao et al., 2022): ترکیب استدلال زنجیرهای (Chain-of-Thought) با اقدام محیطی. مدل هر بار فکر میکند، ابزار صدا میزند، نتیجه را میبیند و دوباره فکر میکند. برای کارهای اکتشافی و باز مناسب است.
- Plan-and-Execute: ابتدا کل مسیر را یکجا طراحی میکند، بعد مرحلهبهمرحله اجرا. برای کارهای ساختاریافته با مراحل مشخص، پایدارتر و ارزانتر است.
- Tree of Thoughts: کاوش موازی در چند مسیر تصمیم همزمان. برای مسائل پیچیدهی چندگامی که مسیر حل از پیش معلوم نیست مفید است، ولی هزینهی توکن را چند برابر میکند.
مقایسهی عملی: ReAct برای کارهایی که نمیدانید از کجا شروع کنید — تحلیل دادهی نامنظم، پاسخ به سؤالات باز. Plan-and-Execute برای کارهایی که مراحلش مشخص است — مهاجرت داده، گزارشسازی دورهای. انتخاب بین این دو، تفاوت بین یک پروژهی تمیز و یک حلقهی بیپایان پرهزینه است.
مقایسهی فریمورکهای ساخت ایجنت: LangChain، CrewAI، AutoGen و OpenAI Agents SDK#
فریمورکهای ساخت ایجنت هر کدام برای مقیاس و الگوی متفاوتی طراحی شدهاند. LangChain برای چرخهی کامل، CrewAI برای ایجنت چندگانهی نقشمحور، AutoGen برای گفتگوی آزاد بین ایجنتها و OpenAI Agents SDK برای سادهترین حالت Function Calling مناسب است. انتخاب اشتباه یعنی ماهها صرف دیباگ انتزاعهایی که به مسئلهی شما ربطی ندارند.
| فریمورک | الگوی اصلی | مقیاس مناسب | محدودیت کلیدی |
|---|---|---|---|
| LangChain | زنجیرهی ابزارها + حافظه | پروژههای تکایجنت با چند ابزار | انتزاعهای زیاد، دیباگ سخت |
| CrewAI | Orchestrator-Worker نقشمحور | ایجنت چندگانه با وظایف تفکیکشده | انعطافپذیری کم در تغییر مسیر |
| AutoGen | گفتگوی Peer-to-Peer بین ایجنتها | پژوهش و کارهای اکتشافی | غیرقابلپیشبینی در تولید |
| OpenAI Agents SDK | Function Calling ساده | ایجنتهای کوچک با ۲ تا ۵ ابزار | محدود به اکوسیستم OpenAI |
محدودیتهای واقعی LangChain#
LangChain توسط Harrison Chase در اکتبر 2022 ساخته شد و بزرگترین اکوسیستم ابزارهای ایجنت را دارد. اما در پروژههای واقعی، لایههای انتزاعی آن — Chain → Agent → AgentExecutor → Memory → Callback — دیباگ را به کابوس تبدیل میکند. وقتی ایجنت در دور هفتم حلقه ابزار اشتباهی صدا میزند، ردیابی علت در این لایهها ساعتها طول میکشد.
نمونهی ساختار پروژه با شبهکد:
from langchain.agents import initialize_agent
from langchain.tools import Tool
tools = [
Tool(name="search", func=search_api, description="..."),
Tool(name="save", func=save_notion, description="..."),
]
agent = initialize_agent(
tools=tools,
llm=llm,
agent_type="react",
max_iterations=10
)
الگوی Orchestrator-Worker در مقابل Peer-to-Peer#
CrewAI مسیر Orchestrator-Worker را انتخاب کرده: یک ایجنت «مدیر» وظایف را بین ایجنتهای «کارگر» تقسیم میکند. AutoGen مسیر Peer-to-Peer را: ایجنتها آزادانه با هم گفتگو میکنند و هر کدام میتواند نوبت بعدی را تعیین کند.
در عمل، Orchestrator-Worker قابلپیشبینیتر است چون مسیر تصمیم از قبل محدود شده. Peer-to-Peer انعطاف بیشتری دارد ولی در تولید، رفتار غیرقابلپیشبینی و هزینهی توکن تجمعیاش ریسکساز است. اگر ایجنت چندگانه میخواهید و به پایداری نیاز دارید، Orchestrator-Worker شروع امنتری است.
آیا واقعاً به ایجنت نیاز داری؟ معیار سهمرحلهای تصمیمگیری#
ایجنت فقط وقتی لازم است که تعداد و نوع فراخوانیهای ابزار از پیش معلوم نباشد و به خروجی مراحل قبلی بستگی داشته باشد. اگر مسئله با یک پرامپت خوب حل میشود، ایجنت اضافه است. اگر با ۲ تا ۳ فراخوانی ابزار با ترتیب مشخص حل میشود، workflow خطی کافی است و ایجنت فقط پیچیدگی بیمورد میسازد.
معیار سهمرحلهای (Agent Necessity Test)#
- مرحله ۱: آیا مسئله با یک پرامپت + context کافی حل میشود؟ اگر بله، ایجنت لازم نیست. فقط یک prompt خوب بنویسید.
- مرحله ۲: آیا با ۲ تا ۳ فراخوانی ابزار با ترتیب مشخص (workflow خطی با if-else) حل میشود؟ اگر بله، workflow کافی است.
- مرحله ۳: آیا تعداد و نوع ابزارهایی که لازم است از پیش معلوم نیست و به خروجی مراحل قبلی بستگی دارد؟ در این حالت ایجنت لازم است.
تجربهی میدانی از پروژههای واقعی#
در پروژههایی که اعضای کامیونیتی اسکول ساختهاند، بارها مشاهده شده که workflow خطی با چند شرط، از ایجنت با ReAct loop پایدارتر و ارزانتر است. دو مثال:
مثال ۱ — workflow کافی است: «خلاصهی ۱۰ مقاله و ذخیره در Notion.» مراحل ثابتاند: fetch → summarize → save. ترتیب مشخص است. یک workflow خطی با سه گام انجام میدهد. ایجنت اینجا فقط هزینه و پیچیدگی اضافه میکند.
مثال ۲ — ایجنت لازم است: «تحلیل این فایل CSV و اگر مشکوک بود ایمیل بده و اگر نبود در لاگ بنویس.» مسیر از پیش مشخص نیست. ایجنت اول باید فایل را باز کند، ستونها را بشناسد، دادهی نامنظم را پاک کند، بعد تصمیم بگیرد آیا مشکوک است یا نه. این وابستگی تصمیمهای بعدی به خروجی مراحل قبلی، دقیقاً همان چیزی است که ایجنت برای آن ساخته شده.
رایجترین اشتباهات در ساخت ایجنت و هزینهی تجمعی توکن#
رایجترین اشتباه در ساخت ایجنت، «هرچه ابزار بیشتر بهتر» است. Anthropic در راهنمای Building Effective Agents (دسامبر 2024) صراحتاً توصیه میکند با حداقل ابزار شروع کنید. اشتباه دوم: نادیدهگرفتن هزینهی تجمعی توکن حلقهها که هر دور چند برابر یک پرامپت ساده مصرف میکند و در ایجنتهای با حلقههای زیاد بهسرعت به قبض نجومی تبدیل میشود.
اشتباهات طراحی#
- تعداد ابزارهای زیاد: وقتی ۱۵ ابزار به ایجنت میدهید، مدل در انتخاب سردرگم میشود و خطا بالا میرود. Anthropic این را در Building Effective Agents صریحاً ذکر کرده.
- ایجنت برای هر مسئله: استفاده از ایجنت جایی که workflow کافی است، فقط هزینهی توکن و زمان دیباگ را بالا میبرد.
- نمونهبرداری از AutoGPT: الگوی AutoGPT (2023) امروز بهعنوان anti-pattern شناخته میشود: حلقههای بیپایان و توهم شدید. الگوی استاندارد فعلی، ایجنتهای محدود با وظیفهی مشخص است.
- Multi-Agent بدون نیاز: وقتی یک ایجنت با چند ابزار کار را راه میاندازد، Multi-Agent فقط پیچیدگی اضافه میکند.
هزینهی واقعی حلقهها#
هر دور حلقهی ایجنت شامل سه بخش است: thought (مدل فکر میکند)، action (ابزار صدا زده میشود)، observation (نتیجه به مدل برمیگردد). در پروژههای واقعی مشاهده شده که هر دور حلقه چند برابر یک پرامپت ساده توکن مصرف میکند. ایجنتی که ۱۰ دور حلقه میزند، هزینهی توکناش بهسرعت تجمعی میشود.
چرا این عدد در آموزشها ذکر نمیشود؟ چون اکثر آموزشها با یک حلقهی ساده demo میسازند و هزینهی حلقههای زیاد را تجربه نمیکنند. کاربر در تولید غافلگیر میشود وقتی قبض توکناش چند برابر پیشبینیاش است.
Guardrails در لایهی ابزار نه پرامپت#
مدل میتواند پرامپت سیستمی را دور بزند. اما نمیتواند فراخوانی ابزاری را که اصلاً تعریف نشده انجام دهد. بنابراین guardrails باید در لایهی ابزار قرار بگیرند نه در پرامپت.
نمونهی ساختار:
def safe_tool_wrapper(tool_name, args):
if tool_name not in ALLOWED_TOOLS:
return {"error": "unknown tool"}
if not validate(args):
return {"error": "invalid parameters"}
return execute(tool_name, args)
این الگو در کامیونیتی اسکول بارها استفاده شده و نتایج بهتری از پرامپتنویسی صرف دارد.
چگونه یک ایجنت AI را ارزیابی و دیباگ کنیم؟#
دیباگ ایجنت بدون دستهبندی شکستها، حدس زدن است. چهار نوع اصلی شکست وجود دارد: حلقهی بیپایان، توهم ابزار، انتخاب نادرست ابزار و عدمتطابق خروجی. هر کدام روش تشخیص و اصلاح متفاوتی میخواهند. اولین قدم: لاگگیری thought، action و observation هر دور حلقه بهصورت جداگانه.
دستهبندی شکستها (Failure Taxonomy)#
- حلقهی بیپایان: ایجنت بدون max_iterations در loop گیر میکند. هر دور هزینهی توکن اضافه میکند و خروجی بهتری تولید نمیکند.
- توهم ابزار: ایجنت ابزاری را صدا میزند که تعریف نشده. معمولاً وقتی تعداد ابزارها زیاد است یا نامها مبهماند.
- انتخاب نادرست ابزار: ابزار درست وجود دارد ولی ایجنت اشتباهی را انتخاب میکند. علت معمولاً توضیحات ضعیف ابزارهاست.
- عدمتطابق خروجی: ایجنت کار را انجام داده ولی نتیجه با انتظار کاربر فرق دارد. این نوع شکست سختترین برای تشخیص است.
روشهای عملی ارزیابی#
- Human-in-the-loop: برای تصمیمات حساس — حذف داده، ارسال ایمیل، پرداخت — تأیید انسانی بگیرید. ایجنت نباید بدون بازبینی، عمل غیرقابلبازگشت انجام دهد.
- لاگگیری هر دور حلقه: thought، action و observation هر دور را جداگانه ثبت کنید. بدون این لاگ، نمیفهمید ایجنت در دور پنجم چرا ابزار اشتباهی انتخاب کرده.
- تست با سناریوهای edge case: قبل از deployment، ورودیهای غیرمنتظره بدهید. دادهی خالی، فایل بزرگ، نام ابزار غلط.
- معیار موفقیت: نه «خروجی زیبا» بلکه «مسیر تصمیمگیری قابلتوضیح.» اگر نمیتوانید بگویید ایجنت چرا این ابزار را انتخاب کرد، حتی با خروجی درست، قابلاعتماد نیست.
معیار سهمرحلهای تصمیمگیری را قبل از شروع پروژه اجرا کنید: پرامپت ← workflow ← ایجنت. بیشتر مسائل با دو مرحلهی اول حل میشوند. وقتی ایجنت واقعاً لازم است، با حداقل ابزار شروع کنید، guardrails را در لایهی ابزار بگذارید و حلقهها را با max_iterations محدود کنید. هزینهی تجمعی توکن را از روز اول در بودجهی عملیاتی لحاظ کنید.
اگر میخواهید ایجنت و اتوماسیون را در عمل بسازید و از آن درآمد داشته باشید، دورهی «ساخت Ai Agent با N8N» در کامیونیتی اسکول، ۵۱ جلسهی کاربردی با پروژههای واقعی دارد. اگر اولویتتان یادگیری ایجنت بدون کدنویسی است، دورهی «آموزش جامع Claude و ابزارهای مشابه» با ۵۳ جلسه و ۶ فصل، مسیر Vibe Coding و ایجنتسازی را پوشش میدهد.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.