

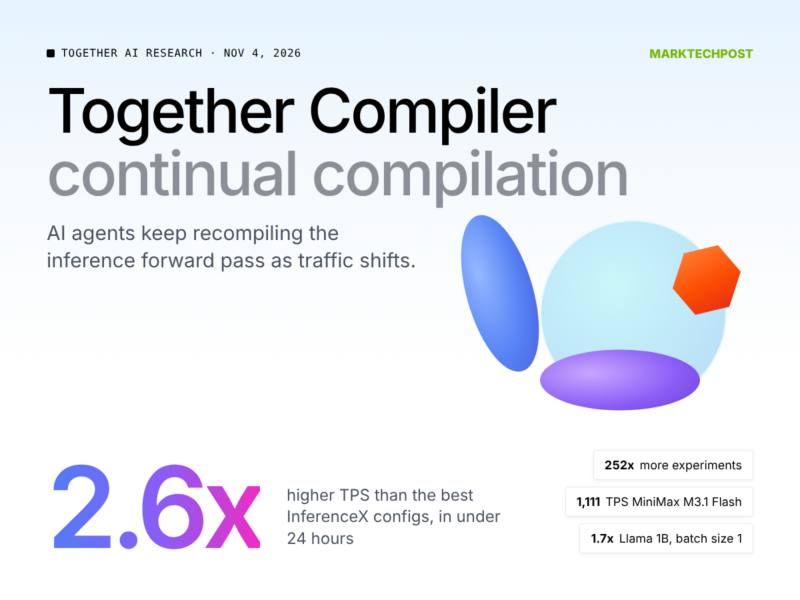
Together AI از Together Compiler (TKCC) رونمایی کرد؛ سیستمی که عاملهای کدنویس را بهصورت پیوسته برای بازنویسی forward pass مدلها بهکار میگیرد. این سیستم هماکنون روی چند endpoint سرورلس Together اجرا میشود و فعلاً در نسخه بتای محدود برای مشتریان Together در دسترس است.
چرا بهینهسازی پیوسته؟#
تیم Together گزارش میدهد که شکل ترافیک تولیدی ثابت نمیماند: طول prompt در یک کشور حدود ۹۷ هزار توکن در برابر ۷۰ هزار توکن در کشور دیگر. P90 طول ورودی یک مشتری در ۳ روز از ۱۸ هزار به ۳۳ هزار توکن رسیده است. همچنین kernelهای تنظیمشده روی داده تصادفی گمراهکنندهاند؛ ورودیهای تصادفی ۱۳ تا ۳۸ درصد expert بیشتر در MoE فعال میکنند و یک kernel نوشتهشده توسط عامل روی داده تصادفی ۲۰ میکروثانسه بود ولی روی داده واقعی با context ۷۰ هزار توکن تا ۶۲ میلیثانیه طول کشید.
موتور پایدار و دو سطح اندازهگیری#
برخلاف حلقههای عاملی معمول که هر بار vLLM یا TensorRT-LLM را restart میکنند (۷۶۱ ثانیه cold startup برای MiniMax M3.1 Flash)، Together Compiler موتور را یکبار بالا میآورد و عاملها از طریق RPC کاندید forward pass میفرستند. دو سطح اندازهگیری وجود دارد: سطح سریع (۱۲ لایه) برای غربالگری و سطح کند (۶۰ لایه) برای تأیید روی توزیع واقعی. این دو سطح ۸.۱ برابر کاندید بیشتری نسبت به یک سطح کند آزمایش میکنند (۱٬۳۵۴ در برابر ۱۶۸) و ۲۵۲ برابر throughput آزمایش بالاتر از baseline restart موتور دارند.
نتایج بنچمارک#
روی workload AgentX در SemiAnalysis InferenceX، با batch size 1 و P90 TPS per user:
- MiniMax M3.1 Flash (B200): ۱٬۱۱۱ در برابر ۶۳۳ (۱.۸ برابر)
- DeepSeek v4.1 Flash (GB300): ۱٬۲۰۵ در برابر ۹۴۳
- GLM 5.3 (B200): ۴۱۷ در برابر ۳۲۹
- Kimi K3 (GB300): ۴۵۰ در برابر ۴۲۳
- GLM 5.3 (MI355X): ۴۸۰ در برابر ۴۶۳ (حدود ۴ درصد)
یک یافته قابلتوجه: عاملهای سادهای که فقط دستور «سریعترین forward pass ممکن» را داشتند، از knowledge base تنظیمشده توسط متخصص ۲۵ تا ۳۱ درصد speedup بیشتر تولید کردند (امتیاز ensemble ۶.۲ در برابر ۴.۹ پس از ۱۰ آزمایش).
برای کسی که امروز ایجنت میسازد، این خبر چه معنایی دارد؟#
دو نکته عملی دارد. اول، مفهوم «بهینهسازی پیوسته» بهجای «تنظیم یکباره» اگر ترافیک واقعی شما ناپایدار است، منطق دارد — ولی بازه نتایج (از ۴ درصد تا ۲.۶ برابر) نشان میدهد این مزیت به سختی به مدل و سختافزار بستگی دارد. دوم، اینکه عاملهای بدون راهنمایی تخصصی از استراتژیهای دستچین متخصص بهتر عمل کردند، برای هر کسی که pipeline بهینهسازی با LLM میسازد، زنگ هشداری است: knowledge base ممکن است بهجای کمک، عامل را محدود کند. با این حال، دسترسی محدود بتا و خوداظهاری نتایج یعنی فعلاً نمیتوان این اعداد را برای زیرساخت خود تعمیم داد.
منبع: MarkTechPost
دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.