


ایجنتهایی که در محیط آزمایشی «موفق» بهنظر میرسند، در استقرار واقعی اغلب شکست میخورند. علت معمولاً فنی نیست؛ انتخاب نادرست معماری است. این مقاله نشان میدهد چهوقت ایجنت لازم است، چهوقت سادهتر کار میکند، و الگوی موفق در محیط تولید کدام است.
ایجنت هوش مصنوعی چیست و چه زمانی لازم نیست؟#
ایجنت هوش مصنوعی (AI Agent) سیستمی است که در آن مدل زبانی بهطور تکراری ادراک میکند، تصمیم میگیرد و عمل میکند؛ اما در اکثر پروژهها یک Chain ساده یا Workflow با شرط (Conditional Workflow) کارآمدتر، ارزانتر و قابلمدیریتتر است. ایجنت فقط وقتی لازم است که مدل در هر گام باید بین چند مسیر تصمیم بگیرد.
تمایز ایجنت با چتبات، RAG و Workflow#
چتبات یک ورودی میگیرد و یک خروجی میدهد. RAG (Retrieval-Augmented Generation) فقط بازیابی و تولید پاسخ است. Workflow مسیر ثابت با شرطهای از پیشتعریفشده دارد. ایجنت در هر مرحله خودش تصمیم میگیرد کدام ابزار را فراخوانی کند و آیا ادامه دهد یا خیر.
بسیاری از مواردی که در مقالات فارسیزبان بهعنوان ایجنت معرفی میشوند، در واقع یک Conditional Workflow هستند. اگر مدل زبانی در هر گام تصمیم نمیگیرد و فقط یک خروجی تولید میکند، ایجنت ندارید؛ یک زنجیره دارید. این اشتباه طبقهبندی، هزینهی پنهان بزرگی دارد: تیمها وقت و بودجهشان را صرف پیچیدگیای میکنند که خروجی بهتری نمیدهد.
نقطهی شکست ایجنت — چهزمانی پیچیدگی وظیفه آن را مضر میکند#
ایجنت وقتی مفید است که مدل باید بین چند مسیر تصمیم بگیرد و نتیجهی هر تصمیم قابلاعتبارسنجی باشد. اگر وظیفه خطی و قابلپیشبینی است، ایجنت فقط هزینه و تاخیر اضافه میکند.
سه نشانهی «ایجنت لازم نیست»:
- خروجی ابزار قابلاعتبارسنجی نیست (مثلاً «خلاصهی این متن را بنویس»)
- تعداد مراحل ثابت و مشخص است (Chain ساده همان کار را با هزینهی کمتر میدهد)
- هزینهی خطا بالاست و انسان در حلقه (Human-in-the-Loop) نمیتواند اضافه شود
الگوی ایجنت محدودسازیشده در مقابل ایجنت خودمختار#
ایجنت خودمختار (Autonomous Agent) بدون محدودیت تصمیم میگیرد. ایجنت محدودسازیشده (Constrained Agent) با سقف فراخوانی، دامنهی ابزار مشخص و اعتبارسنجی خروجی قبل از اجرا کار میکند. الگوی دوم در محیط تولید قابلمدیریتتر است — و صادقانه بگویم، الگوی اول در عمل تقریباً هرگز قابلاستقرار نیست.
معماری یک ایجنت AI از چه اجزایی تشکیل شده است؟#
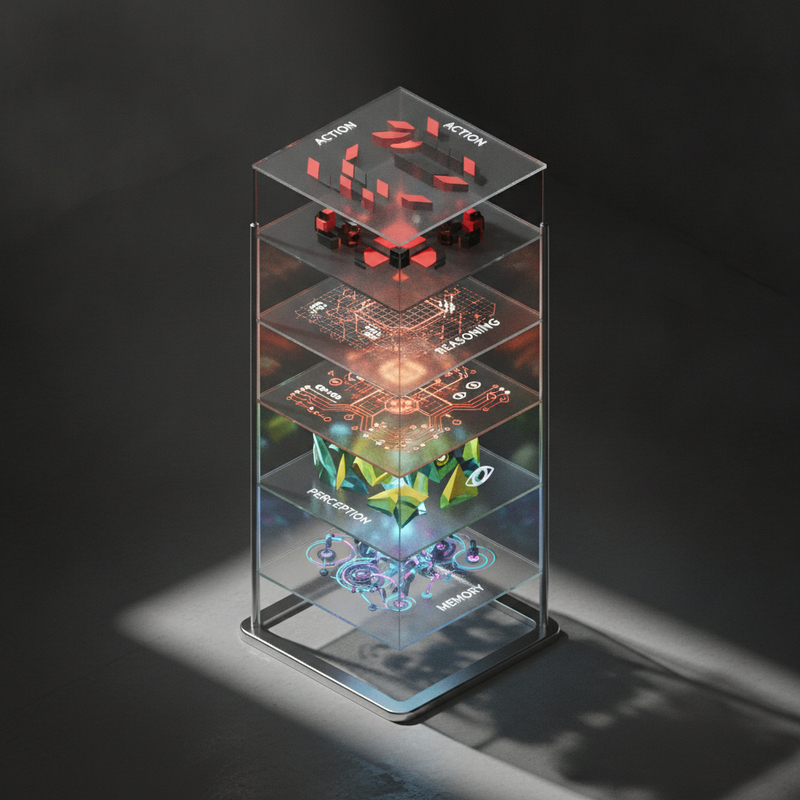
معماری ایجنت بر پایهی حلقهی ادراک-تصمیم-عمل (Perception-Decision-Action Loop) بنا شده و چهار جزء اصلی دارد: مدل زبانی، حافظه (Memory)، ابزارها (Tools) و برنامهریز (Planner). حذف هر یک از این چهار جزء، ایجنت را به یک ابزار ناقص تبدیل میکند.
مدل زبانی بهعنوان مغز تصمیمگیری#
مدل زبانی (LLM) در ایجنت نقش «مغز» را بازی میکند: ورودی را تفسیر میکند، ابزار بعدی را انتخاب میکند و نتیجهی فراخوانی را ارزیابی میکند. انتخاب مدل بر اساس سرعت، هزینه و توانایی استدلال چندگامی انجام میشود.
یک اشتباه رایج: تیمها مدلهای بزرگتر را «بهتر» فرض میکنند، درحالیکه برای ایجنتهای با 3-5 ابزار، یک مدل کوچکتر با latency پایینتر عملکرد عملیاتی بهتری میدهد. سرعت تصمیمگیری در حلقه، مهمتر از عمق استدلال تکمرحلهای است.
ابزارها و فراخوانی تابع#
فراخوانی تابع (Function Calling) مکانیزمی است که مدل زبانی از طریق آن ابزارهای خارجی را صدا میزند. OpenAI در مستندات Function Calling توصیه میکند تعداد توابع محدود نگه داشته شود چون افزایش آن نرخ انتخاب نادرست را بالا میبرد. الگوی رایج موفق 3 تا 7 ابزار هدفمند است.
حافظهی کوتاهمدت و بلندمدت#
حافظهی کوتاهمدت (Short-term Memory) همان Context Window و تاریخچهی گفتگو است. حافظهی بلندمدت (Long-term Memory) معمولاً یک پایگاهدادهی برداری یا RAG است. ساختاردهی حافظه مهمتر از حجم Context Window است.
برنامهریز و ارزیاب#
برنامهریز (Planner) وظیفه را به زیرگامها تقسیم میکند. ارزیاب (Evaluator) پس از هر گام بررسی میکند که آیا نتیجهی ابزار مورد انتظار است یا باید تکرار یا تغییر مسیر انجام شود. بدون ارزیاب، ایجنت عملاً یک Loop کور است.
الگوهای طراحی: ReAct، Plan-and-Execute و Reflexion#
هر الگو یک مسئلهی متفاوت را حل میکند: ReAct برای تصمیمگیری گامبهگام، Plan-and-Execute برای وظایف چندمرحلهای با ساختار مشخص، و Reflexion برای بهبود از طریق بازخورد خود. انتخاب نادرست الگو، حتی با معماری درست، عملکرد ایجنت را تخریب میکند.
الگوی ReAct و مقالهی Yao et al., 2022#
ReAct (Reasoning + Acting) الگویی است که در آن مدل زبانی بین هر فراخوانی ابزار، یک گام استدلال (Thought) تولید میکند. این الگو در مقالهی Yao et al. (2022) معرفی شد و هنوز پرکاربردترین الگوی ایجنت است. مزیتش سادگی و قابلیت دیباگ است. محدودیتش این است که در تجربهی عملی، با افزایش تعداد گامها دقتش افت میکند.
الگوی Plan-and-Execute — مزیت و محدودیت#
در Plan-and-Execute ابتدا یک برنامهریز کل مسیر را تعیین میکند، سپس یک اجراکننده (Executor) گامبهگام اجرا میکند. مزیت: برای وظایف با ساختار مشخص، هزینهی توکن کمتر است چون برنامهریز یکبار تصمیم میگیرد. محدودیت: اگر محیط در میانه تغییر کند، برنامه از پیشنوشتهشده بهدرستی واکنش نمیدهد.
Plan-and-Execute در مقالات تبلیغاتی بهعنوان «جایگزین حرفهای ReAct» معرفی میشود، درحالیکه برای وظایف باز و غیرقابلپیشبینی، واکنشپذیری ReAct را ندارد.
الگوی Reflexion و نقش بازخورد در بهبود عملکرد#
Reflexion (Shinn et al., 2023) الگویی است که در آن ایجنت پس از هر تلاش، یک بازخورد خودارزیابی تولید میکند و آن را در حافظه ذخیره میکند تا در تلاش بعدی از اشتباهات قبلی پرهیز کند. این الگو برای وظایف تکرارپذیر (مثل دیباگ کد) مؤثرتر است.
کدام الگو برای کدام نوع وظیفه مناسب است؟#
- ReAct: وظایف با 3 تا 10 گام، خروجی ابزار قابلاعتبارسنجی، نیاز به تصمیمگیری در هر مرحله
- Plan-and-Execute: وظایف با ساختار ثابت و قابلپیشبینی، بیش از 10 گام، نیاز به بهینهسازی هزینه
- Reflexion: وظایف تکرارپذیر با معیار موفقیت مشخص (کد، تست، امتیاز)
با چه فریمورکهایی میتوان ایجنت ساخت؟#
LangChain، CrewAI و AutoGen (Microsoft) سه فریمورک اصلی هستند که هرکدام سطح انتزاع و مدل اجرایی متفاوتی ارائه میدهند؛ انتخاب بستگی به پیچیدگی وظیفه و نیاز به کنترل دارد. اگر ایجنت شما 3 ابزار دارد، هیچکدام از اینها لازم نیست.
مقایسهی LangChain، CrewAI و AutoGen#
| فریمورک | مدل اجرایی | سطح کنترل | مناسب برای |
|---|---|---|---|
| LangChain | Chain و Agent مستقل | متوسط — abstraction بالا | پروتوتایپ سریع، وظایف تکایجنتی |
| CrewAI | Multi-Agent با نقشهای تعریفشده | متوسط — سلسلهمراتبی | تقسیم وظیفه بین چند ایجنت تخصصی |
| AutoGen | گفتگوی چندایجنتی | پایینتر — انعطاف بیشتر | پژوهش، وظایف باز با تعامل پیچیده |
OpenAI Function Calling و Anthropic Tool Use بهعنوان لایهی زیرساختی#
Function Calling (OpenAI) و Tool Use (Anthropic) لایهی زیرساختی فراخوانی ابزار هستند. فریمورکهای بالا روی این لایه سوار میشوند. اگر وظیفهتان ساده است، میتوانید مستقیماً از API خام استفاده کنید و نیازی به فریمورک نیست.
چهزمانی فریمورک لازم نیست و API خام کافی است؟#
اگر ایجنت شما فقط 3 ابزار دارد، حلقهی ReAct ساده است و نیاز به حافظهی بلندمدت یا چند ایجنت ندارید، API خام با یک switch-case برای routing ابزار کافی است. فریمورک وقتی ارزش دارد که چند ایجنت، حافظهی پیچیده یا Orchestrator-Worker نیاز دارید. در غیر این صورت، abstraction فریمورک فقط یک لایهی عیبیابی اضافه میکند.
مراحل ساخت یک ایجنت عملیاتی از صفر#
ساخت ایجنت عملیاتی از تعریف دقیق دامنه و محدودیتها شروع میشود، نه از انتخاب فریمورک؛ گامهای اصلی شامل تعریف ابزارها، طراحی حلقه، پیادهسازی گاردریل (Guardrails) و اعتبارسنجی است. ترتیب این گامها را اگر جابهجا کنید، هزینهی بازگشت به طراحی چند برابر میشود.
گامبهگام از تعریف دامنه تا استقرار#
- تعریف دامنه: دقیقاً بنویسید ایجنت چه کارهایی مجاز است و چه کارهایی مجاز نیست. یک جملهی «ایجنت فقط X را انجام میدهد» از هر فریمورک مهمتر است.
- طراحی ابزارها: هر ابزار یک ورودی، یک خروجی و یک معیار موفقیت مشخص داشته باشد. حداکثر 7 ابزار.
- طراحی حلقه: تصمیم بگیرید ReAct یا Plan-and-Execute. سقف فراخوانی (max iterations) تعیین کنید.
- پیادهسازی Guardrails: اعتبارسنجی ورودی، اعتبارسنجی خروجی ابزار، و محدودیت دامنهی ابزار.
- تست با سناریوهای شکست: نه فقط سناریوی موفق. ایجنت در شرایط مبهم چه میکند؟
- استقرار با Human-in-the-Loop: در محیط تولید، ایجنت محدودسازیشده با امکان تایید انسانی در گامهای حساس.
نمونهی ساختار پوشهی پروژه#
agent-project/
├── agent/
│ ├── core.py # حلقهی اصلی
│ ├── planner.py # برنامهریز
│ └── evaluator.py # ارزیاب
├── tools/
│ ├── base.py # رابط مشترک ابزار
│ ├── search.py
│ └── calculator.py
├── memory/
│ ├── short_term.py # Context management
│ └── long_term.py # Vector store
├── guardrails/
│ ├── input_validator.py
│ └── output_validator.py
├── config.py # سقف فراخوانی، دامنهی ابزار
└── main.py
شبهکد حلقهی ReAct با Function Calling#
while iteration < MAX_ITERATIONS:
thought = llm.generate(prompt + history + observation)
action = parse_tool_call(thought)
if action is None:
return final_answer(thought)
if action.tool not in ALLOWED_TOOLS:
return error("Tool out of scope")
result = execute_tool(action.tool, action.args)
observation = validate(result)
if not observation.valid:
history.append(retry_prompt)
continue
history.append(observation)
رایجترین اشتباهات در ساخت ایجنت چیست؟#
پنج پادالگوی (Anti-pattern) اصلی عبارتاند از: ایجنتسازی برای وظیفهی خطی، ابزار بیش از حد، حلقه بدون برنامهریز، فرض خودمختاری کامل و بزرگنمایی نقش Context Window. از این پنج، «ابزار بیش از حد» پرهزینهترین است چون اثرش تدریجی است و تشخیصش سخت.
ابزار بیش از حد و کاهش دقت انتخاب#
وقتی بیش از 7 ابزار به ایجنت میدهید، نرخ انتخاب نادرست ابزار بهطور محسوس بالا میرود. این پدیده در مستندات Function Calling OpenAI و تجربهی میدانی اعضای کامیونیتی بهصورت مکرر مشاهده شده. راهحل: ابزارها را بر اساس وظیفه گروهبندی کنید و هر ایجنت فقط ابزارهای گروه خودش را ببیند.
حلقهی بیپایان و نبود سقف فراخوانی#
بدون max_iterations، ایجنت میتواند در حلقهی تکرار بماند. این نهفقط هزینه را چند برابر میکند، بلکه در محیط تولید میتواند سرویس را از کار بیندازد. سقف فراخوانی باید از ابتدای طراحی مشخص باشد، نه بعد از استقرار.
نبود Human-in-the-Loop در وظایف باز و مبهم#
ایجنتهایی که وظایف مبهم دارند (مثل «این ایده را به محصول تبدیل کن») بدون بازخورد انسانی معمولاً در دور تکرار میافتند یا خروجی بیربط تولید میکنند. Human-in-the-Loop در گامهای تصمیمساز، نه در هر گام، کفایت میکند.
اشتباه «AutoGPT همان ایجنت عملیاتی است»#
AutoGPT یک پروژهی متنباز با ایجنت خودمختار بود که در محیط عملیاتی قابلاستقرار نبود. بسیاری از مقالات فارسیزبان AutoGPT را الگوی ایجنت عملیاتی معرفی میکنند، درحالیکه الگوی موفق در تولید، ایجنت محدودسازیشده با سقف فراخوانی و اعتبارسنجی است. این یکی از گمراهکنندهترین اشتباهات طبقهبندی در اکوسیستم فارسی است.
ایجنتهای چندگانه و الگوی Orchestrator-Worker#
سیستم ایجنت چندگانه (Multi-Agent System) فقط وقتی لازم است که وظیفهی بزرگ به زیروظایف مستقل با تخصصهای متفاوت قابلتقسیم باشد؛ الگوی Orchestrator-Worker قابلمدیریتتر از ایجنتهای همسطح است. اگر یک ایجنت میتواند کار را انجام دهد، دو ایجنت فقط پیچیدگی اضافه میکند.
چهزمانی Multi-Agent واقعاً لازم است؟#
وقتی یک ایجنت نمیتواند همزمان هم کدنویسی کند، هم تحلیل بازار انجام دهد و هم محتوا تولید کند. هر ایجنت یک نقش تخصصی دارد و Orchestrator بین آنها هماهنگی ایجاد میکند.
الگوی Orchestrator-Worker در مقابل ایجنتهای همسطح#
در Orchestrator-Worker یک ایجنت مرکزی وظیفه را تقسیم و نتایج را تجمیع میکند. در ایجنتهای همسطح (Peer-to-Peer)، ایجنتها مستقیم با هم گفتگو میکنند. الگوی سلسلهمراتبی قابلمدیریتتر است چون نقطهی شکست مشخصی دارد و دیباگ آن سادهتر است.
چالشهای هماهنگی و تداخل خروجی#
مهمترین چالش Multi-Agent، تداخل خروجی است: دو Worker ممکن است دادهی متناقض تولید کنند. راهحل: Orchestrator باید معیار حل تعارض (Conflict Resolution) داشته باشد — معمولاً اعتبارسنجی بر اساس منبع یا تاریخ.
حافظهی ایجنت چگونه کار میکند؟#
حافظهی ایجنت دو لایه دارد: کوتاهمدت (Context Window و تاریخچهی گفتگو) و بلندمدت (پایگاهدادهی برداری یا RAG)؛ ساختاردهی حافظه مهمتر از حجم Context Window است. تیمهایی که فقط به بزرگتر کردن Context Window فکر میکنند، مشکل را جابهجا کردهاند نه حل.
حافظهی کوتاهمدت و محدودیت Context Window#
حافظهی کوتاهمدت همان Context Window است. هر گام ایجنت، تاریخچهی گفتگو را بزرگتر میکند و توکنهای بیشتری مصرف میکند. مدیریت این حافظه (خلاصهسازی، حذف گامهای قدیمی) مستقیماً بر هزینه تأثیر دارد.
حافظهی بلندمدت و نقش RAG در ایجنت#
حافظهی بلندمدت معمولاً یک پایگاهدادهی برداری است. ایجنت در هر گام میتواند از این حافظه بازیابی کند. RAG در ایجنت نقش «دانش پسزمینهای» دارد، نه نقش اصلی. اگر ایجنت شما فقط RAG است، ایجنت نیست؛ یک سیستم پرسشوپاسخ است.
چرا Context Window بزرگتر لزوماً به ایجنت هوشمندتر منجر نمیشود؟#
مدلهای زبانی در Context Windowهای بزرگ، دقت بازیابی اطلاعات در میانهی متن را از دست میدهند (پدیدهی Lost in the Middle). بزرگتر کردن Context Window بدون ساختاردهی، هزینه را بالا میبرد و دقت را کاهش میدهد.
هزینهی پنهان ایجنت و نقش بازخورد محیط#
هزینهی پنهان ایجنت تابع چهار متغیر است — تعداد فراخوانی، توکن ورودی/خروجی، تعداد ابزار و نرخ Retry — و بازخورد محیط (Environment Feedback) تعیینکنندهی اصلی موفقیت یا شکست است. تیمهایی که فقط قیمت توکن را محاسبه میکنند، هزینهی واقعی را دستکم میگیرند.
فرمول محاسبهی هزینه و مثال عملی#
هزینهی تقریبی هر اجرا = تعداد فراخوانی × (توکن ورودی + توکن خروجی) × نرخ قیمت توکن × (1 + نرخ Retry). اگر ایجنت 5 ابزار دارد، هر ابزار 2000 توکن ورودی و 500 توکن خروجی میگیرد و نرخ Retry 30 درصد است، هزینهی واقعی حدود 1.3 برابر محاسبهی سادهی اولیه است.
بازخورد محیط: چرا ایجنتهای کدنویس بهتر از ایجنتهای تحلیلی عمل میکنند؟#
ایجنت کدنویس خروجیاش قابلاعتبارسنجی است (کامپایل، تست واحد). ایجنت تحلیلی خروجی مبهم تولید میکند و نمیتواند خودش موفقیت را بسنجد. این تفاوت، مهمترین عامل تفاوت عملکرد است. هرچه بازخورد محیط دقیقتر و فوریتر باشد، ایجنت بهتر عمل میکند.
Guardrails و Sandbox Execution برای کنترل هزینه و ایمنی#
گاردریل (Guardrails) محدودیتهایی است که روی ورودی، خروجی و دامنهی ابزار اعمال میشود. اجرای جعبهشنی (Sandbox Execution) ابزارهای خطرناک (مثل اجرای کد) را در محیط ایزوله اجرا میکند. این دو مکانیزم، ایجنت محدودسازیشده را از ایجنت خودمختار خطرناک جدا میکنند.
ایجنت هوش مصنوعی ابزار قدرتمندی است، اما فقط وقتی وظیفه واقعاً به تصمیمگیری چندگامی نیاز دارد و خروجی ابزار قابلاعتبارسنجی است. در محیط تولید، ایجنت محدودسازیشده با سقف فراخوانی و Human-in-the-Loop در گامهای حساس، الگوی موفق است.
اگر میخواهید این الگو را در عمل پیادهسازی کنید، دورهی «ساخت Ai Agent با N8N» در کامیونیتی N8N اسکول، مسیر گامبهگام از تعریف دامنه تا استقرار ایجنت عملیاتی را پوشش میدهد.

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.