

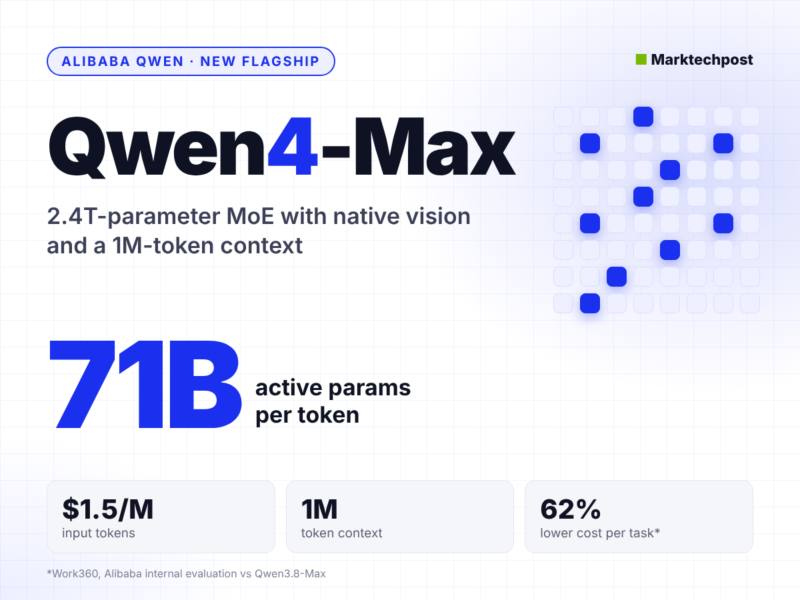


تیم Qwen علیبابا Qwen4-Max را منتشر کرد؛ اولین مدل نسل چهارم این خانواده. این مدل یک MoE (mixture-of-experts) با ۲٫۴ تریلیون پارامتر در ستون فقرات و ۷۱ میلیارد پارامتر فعال بهازای هر توکن است. ورودی آن متن، تصویر و ویدیو را میپذیرد و پنجرهی بافتی ۱ میلیون توکنی و سقف خروجی ۳۹۳ هزار توکن دارد. مدل انحصاری است و فقط از طریق API میزبانیشده در QwenCloud، Token Plan، Qwen Studio، QwenWork و Qoder در دسترس قرار میگیرد؛ وزنهای آن باز نیست و امکان self-hosting یا ساخت نسخهی quantized وجود ندارد.
معماری: سه تغییر اصلی در MoE#
Qwen4 در سه بخش معماری sparse MoE را بازنویسی کرده: لایههای توجه، اتصالات باقیمانده (residual) و امبدینگها. در بخش توجه، هر لایهی QSA (Qwen Sparse Attention) با سه لایهی Gated DeltaNet جفت میشود که تاریخچه را در حالتهای ثابتاندازه فشرده میکنند؛ سپس یک شاخصساز سبک، بافت مرتبط را در دقت micro-block انتخاب میکند. در بخش باقیمانده، چهار شاخهی موازی با دروازههای خواندن و نوشتن پویا استفاده شده. ۳۲۸ میلیارد پارامتر اضافی هم برای N-gram Embedding در لایهی دوم بهکار میروند. علیبابا گزارش میدهد که در طول پیشآموزش ۲٫۴ تریلیونی هیچ spike در تابع زیان رخ نداده و مدل پایه نسبت به Qwen3.8-Max-Base بین ۵ تا ۱۳ درصد bits-per-byte کمتری دارد، درحالیکه ۲۵ درصد پارامتر کمتری فعال میکند.
عملکرد: چهار برتری از ۱۶ معیار#
در مقایسهی علیبابا روی ۱۶ معیار، Qwen4-Max در چهار مورد رتبهی اول را گرفته: HLAB-Vals-1.1 (عاملهای حقوقی) با ۲۱٫۳ در برابر ۱۱٫۷ برای Kimi K3.1، Agents' Last Exam v1.1 با ۴۶٫۷، BioMysteryBench با ۸۵٫۰ و DeepSWE v1.1 با ۷۵٫۷. اما Claude Opus 5.5 در هفت معیار پیشرو است و Qwen4-Max بهویژه در کدنویسی و بینایی عقب است: ProgramBench با ۳۱٫۵ در برابر ۶۵٫۰ برای Opus 5.5، و Terminal-Bench 4.0 با ۴۸٫۵ در برابر ۶۷٫۲ برای Kimi K3.1. هیچیک از این امتیازها در زمان انتشار بهطور مستقل بازتولید نشدهاند.
قیمت API: کاهش ۶۲ درصدی هزینهی هر تسک#
قیمت ورودی از ۲ دلار به ۱٫۵ دلار و خروجی از ۶ دلار به ۴٫۵ دلار بهازای هر میلیون توکن رسیده است. خواندن کششده ۷۰ درصد ارزانتر شده (از ۰٫۲۵ به ۰٫۰۷۵ دلار). علیبابا میگوید مصرف توکن در benchmark داخلی Work360 حدود ۲۴ درصد (در سطح Xhigh) و ۳۵ درصد (در سطح High) کم شده و هزینهی میانگین هر تسک از ۴٫۴۳ دلار به ۱٫۶۷ دلار رسیده است.
دسترسی و ویژگیها#
شناسهی مدل qwen4-max در QwenCloud است و API با کلاینتهای سازگار با OpenAI و Anthropic کار میکند. قابلیتهای پشتیبانیشده شامل function calling، structured outputs، context caching، batch processing، web search و fine-tuning است. سقف پیشفرض نرخ، ۵ میلیون توکن در دقیقه و حالت تفکر با enable_thinking فعال میشود.
تحلیل: چه چیزی عوض میشود و چه چیزی نه#
برای کسی که همین حالا با ابزارهای ایجنت و اتوماسیون کار میکند، دو چیز در این خبر عملیاتی است: اول، کاهش هزینهی هر تسک از ۴٫۴۳ به ۱٫۶۷ دلار — یعنی اگر قبلاً Qwen3.8-Max را بهدلیل قیمت انتخاب میکردید، حالا مدل قویتر هم ارزانتر است. دوم، پنجرهی ۳۹۳ هزار توکنی خروجی که نسبت به ۱۳۱ هزار نسل قبل سه برابر شده و برای تسکهای طولانی خروجی (گزارشهای کامل، کد چندفایلی) تفاوت واقعی ایجاد میکند.
اما دو محدودیت همزمان وجود دارد: مدل بسته است — بدون وزنهای باز، بدون self-hosting، بدون quantization — یعنی وابستگی کامل به زیرساخت علیبابا حفظ شده. و در حوزهی کدنویسی و بینایی، فاصلهی محسوس با Opus 5.5 و Kimi K3.1 باقی است. اگر workflow شما حول coding agent یا vision-heavy task میچرخد، این مدل جایگزین نمیشود؛ اگر حول agentهای حقوقی، پژوهشی و تسکهای متنی طولانی میچرخد، نسبت قیمت به عملکرد آن جدی است.
منبع: MarkTechPost

دیدگاهها
برای گذاشتن دیدگاه وارد شو
دیدگاهها فقط از حسابهای کاربری پذیرفته میشوند.
ورود / ثبتنامهنوز دیدگاهی ثبت نشده — اولین نفر باش.